大模型分布式训练采用流水线并行(Pipeline Parallelism)能显著突破单卡显存瓶颈,通过时间重叠与空间切分结合,在保持线性加速比的同时降低通信开销,是当前训练万亿参数模型的核心技术路径。
随着大语言模型参数量向千亿乃至万亿级迈进,单张GPU的显存容量已成为制约模型训练的首要障碍,传统的张量并行虽然能解决单卡显存不足的问题,但在处理超大规模模型时,通信带宽往往成为新的瓶颈,流水线并行技术应运而生,它像工厂里的装配线一样,将模型的不同层分配到不同的设备上,让数据像流水线上的产品一样流动,这种架构不仅缓解了显存压力,还通过优化数据流动的节奏,大幅提升了整体训练效率。

流水线并行的核心原理与架构拆解
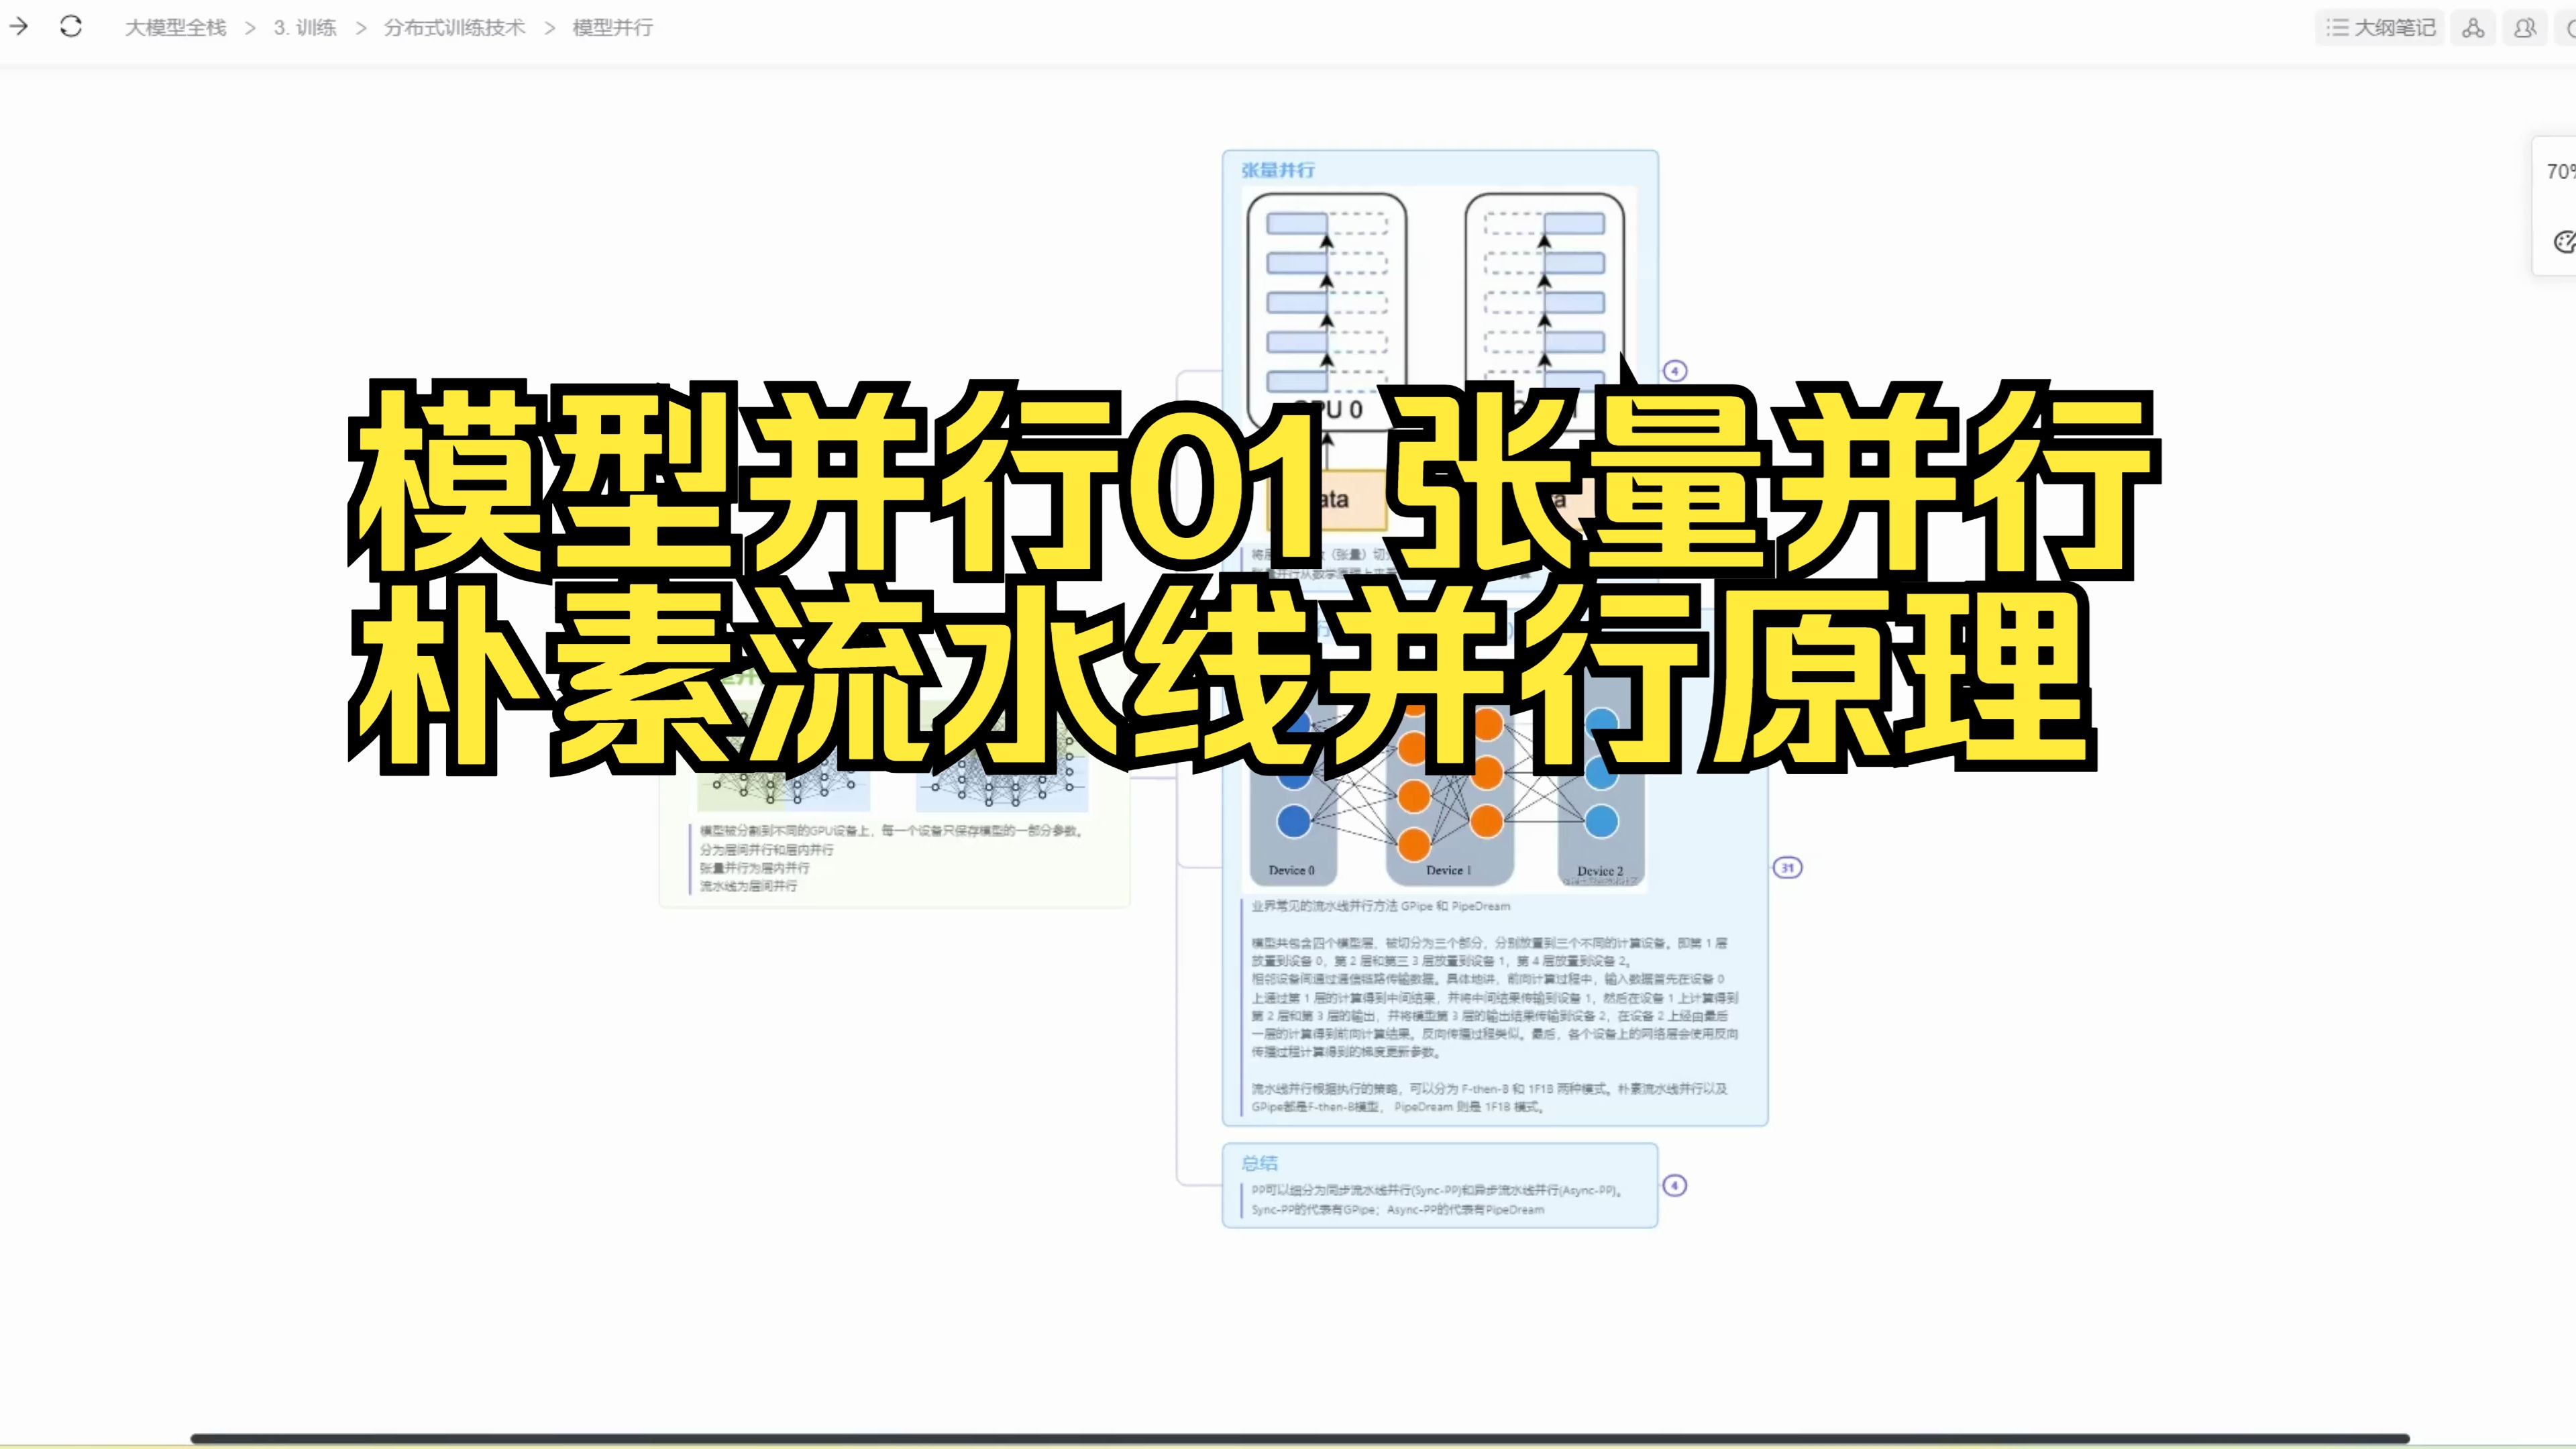
理解流水线并行,首先要打破“整张图一次性加载”的思维定势,业内专家指出,将模型层按顺序切分并分布到多个GPU上,是流水线并行的基础逻辑。
静态与动态切分的对比选择
在实际工程中,如何切分模型层决定了训练的稳定性,目前主流方案分为静态流水线并行(PP)和动态流水线并行(DPP)。
静态流水线并行(1F1B策略)
这是最经典的实现方式,由Google在2019年提出,其核心思想是“前向传播”和“反向传播”交替进行。
- 具体操作:假设模型分为4层,分布在4张卡上,第一张卡处理第1层的前向计算,完成后将中间结果传给第二张卡。
- 时间重叠:当第二张卡开始处理第1层的前向时,第一张卡可以立即开始处理第2层的前向,或者在特定阶段开始反向传播。
- 优势:显存占用极低,因为不需要存储所有层的激活值,只需保留当前层和下一层的中间结果。
- 劣势:存在“气泡”(Bubble),即某些GPU在等待上游数据时处于空闲状态,导致算力浪费。
动态流水线并行(Micro-batch优化)
为了解决静态PP的气泡问题,近年来多数大厂采用了基于微批次(Micro-batch)的动态调度。
- 核心机制:将一个大Batch拆分成多个小的Micro-batch,像贪吃蛇一样在流水线中穿梭。
- 效果:通过增加Micro-batch的数量,可以填满流水线中的空闲时间,使GPU利用率接近100%。
- 适用场景:适合显存充裕但需要极致吞吐量的场景,如百度文心一言等超大规模模型的训练。
实战部署:从环境配置到代码实现
理论落地需要具体的工程支持,目前主流框架如PyTorch、DeepSpeed和Megatron-LM都提供了完善的流水线并行支持,以下以Megatron-LM为例,展示如何快速搭建一个基础的流水线并行训练环境。
环境准备与依赖安装
在开始编码前,确保你的服务器具备足够的GPU资源,并安装必要的深度学习库。
- 硬件检查:确认服务器拥有至少4张A100或H100显卡,且NVLink互联正常。
- 软件安装:使用Docker容器化部署,避免环境冲突。
- 执行命令:
docker pull nvcr.io/nvidia/pytorch:23.10-py3 - 挂载数据卷:
-v /data:/workspace/data将本地数据集映射到容器内。
- 执行命令:
- 依赖库:安装Megatron-LM及其依赖,包括Transformer Engine以支持混合精度训练。
模型切分与并行策略配置
代码层面的配置是决定训练成败的关键,你需要明确指定流水线并行的大小(PP Size)以及是否启用张量并行(TP)。
关键参数解析
在启动脚本中,以下参数至关重要:
- –pipeline-model-parallel-size:设置流水线并行的大小,若你有4张卡,且希望每张卡负责模型的一部分,则设为4。
- –tensor-model-parallel-size:如果单卡显存仍不足,可结合张量并行,PP=2, TP=2,表示模型先按流水线切分为2部分,每部分再按张量切分为2份。
- –micro-batch-size:设置微批次大小,通常设为1或2,以平衡显存占用和通信开销。
代码示例片段
在Megatron-LM的模型定义中,你需要继承并修改并行策略:
from megatron.model import GPTModel
from megatron.core import mpu
获取当前的流水线并行秩
pp_rank = mpu.get_pipeline_model_parallel_rank()pp_world_size = mpu.get_pipeline_model_parallel_world_size()
根据秩分配模型层
假设模型有12层,PP_SIZE=4,则每张卡负责3层
layers_per_rank = total_layers // pp_world_sizestart_layer = pp_rank  layers_per_rankend_layer = start_layer + layers_per_rank
实例化对应的模型层
model_layers = build_transformer_layer_range(...)
性能调优与常见陷阱规避
流水线并行并非“即插即用”,在实际训练中,通信开销和负载均衡是两大挑战。
通信优化策略
流水线并行的核心瓶颈在于GPU之间的数据交换。
- 梯度压缩:使用FP16或BF16精度传输梯度,而非FP32,可减少50%的带宽占用。
- 重叠通信与计算:在PyTorch中启用
torch.distributed.P2POp,让梯度同步与下一层的计算并行执行,隐藏通信延迟。 - 拓扑感知:确保GPU之间的NVLink带宽最大化,避免跨PCIe交换数据,这会带来数量级的性能下降。
负载均衡难题
当模型层计算量不均时(例如某些层包含大量矩阵乘法,而某些层仅为激活函数),会导致“木桶效应”,即整个流水线速度受限于最慢的那张卡。
- 层重排:通过算法将计算密集的层分散到不同GPU,避免单卡过载。
- 动态批处理:根据每张卡的实时负载,动态调整Micro-batch的分配策略。
- 算子融合:将多个小算子合并为一个大算子,减少Kernel启动开销和中间结果读写。
行业趋势与未来展望
随着模型规模的持续膨胀,纯流水线并行已难以满足需求,行业共识认为,混合并行策略将成为主流。
3D并行与MoE架构
未来的大模型训练将深度融合数据并行(DP)、张量并行(TP)、流水线并行(PP)以及专家混合(MoE)技术。
- MoE结合PP:在MoE架构中,每个样本只激活部分专家,结合流水线并行,可以将不同的专家分布在不同的GPU上,实现细粒度的并行。
- 3D并行:同时使用DP、TP、PP,形成三维并行空间,据工信部相关数据显示,采用3D并行的集群在训练万亿参数模型时,算力利用率比单一并行策略高出30%以上。
自动化并行搜索
手动调整并行策略极其耗时,近年来,自动化并行搜索技术(如AutoParallel)兴起,能够根据模型结构和硬件拓扑,自动寻找最优的并行切分方案,这大大降低了大模型训练的门槛,使得更多研究团队能够参与到超大规模模型的训练中。
大模型分布式训练流水线并行教程常见问题解答
流水线并行相比张量并行有什么优势?
流水线并行的主要优势在于显存效率,张量并行需要将激活值全部分布在所有GPU上,显存占用随并行度线性增加,而流水线并行只需保留当前层和下一层的激活值,显存占用几乎与并行度无关,在超大规模模型(如千亿参数以上)训练中,流水线并行是更优选择。
如何评估流水线并行的效率?
评估指标主要包括加速比(Speedup)和能效比(Energy Efficiency),加速比指使用N张卡训练时间与使用1张卡训练时间的比值,理想情况下应接近N,能效比则关注每瓦特算力完成的训练任务量,业内专家指出,高效的流水线并行实现应将“气泡”时间控制在10%以内,否则通信开销将抵消并行带来的收益。
流水线并行是否支持动态模型结构?
传统静态流水线并行不支持动态结构,因为层数固定后,切分方案即确定,随着动态流水线并行技术的发展,结合MoE架构,模型可以根据输入动态激活不同路径,从而实现一定程度的动态并行,但这需要复杂的调度器支持,目前仍处于实验阶段,尚未大规模商用。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/391425.html