通过Docker Compose编排部署大模型,能实现环境隔离、一键启停与资源动态调度,是中小企业及开发者在2026年落地本地化AI应用的首选标准化方案。
大模型本地化部署早已不是科技巨头的专利,随着硬件门槛降低和开源生态成熟,越来越多的团队开始将目光从云端API转向私有化部署,传统的安装方式往往伴随着依赖冲突、版本混乱和环境污染等痛点,Docker Compose凭借其声明式的配置能力和标准化的镜像管理,成为了连接复杂AI基础设施与简单操作体验之间的桥梁,它让部署过程从“玄学”变成了“科学”,让开发者能将精力集中在模型调优而非环境排查上。
大模型Docker Compose编排部署的核心优势
在深入具体操作之前,我们需要明确为什么选择Docker Compose而不是裸机安装或Kubernetes集群,对于大多数非超大规模的场景,Compose提供了最佳的性价比和操作体验。
环境一致性与隔离性
业内专家指出,环境一致性是软件工程中最大的隐形成本之一,在本地部署大模型时,Python版本、CUDA驱动、PyTorch版本以及各类C++库的依赖关系错综复杂,Docker容器通过文件系统隔离,确保了“在我机器上能跑”不再是一句玩笑话,无论是使用LLaMA 3、Qwen 2.5还是Mixtral,每个模型都可以拥有独立的运行环境,互不干扰。
- 依赖隔离:每个服务运行在独立的容器中,互不影响。
- 版本锁定:通过Dockerfile或镜像标签,精确控制基础镜像版本。
- 快速回滚:一旦新版本出现问题,只需切换镜像标签即可恢复。
资源管理与弹性伸缩
大模型对GPU显存和CPU内存的需求极大,Docker Compose允许通过配置文件精确限制容器的资源使用上限,防止单个模型实例占用过多资源导致宿主机崩溃。
- GPU调度:通过
nvidia-container-toolkit,可以指定容器使用的GPU设备ID。 - 内存限制:设置
mem_limit防止内存泄漏导致OOM(Out of Memory)。 - 并发控制:通过限制最大请求数,保护后端服务稳定性。
实战:构建高效的大模型部署架构
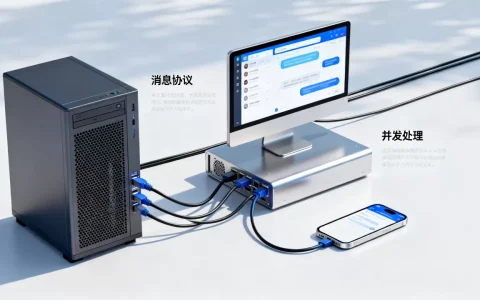
一个典型的大模型部署架构通常包含三个核心部分:推理服务、向量数据库和前端应用,Docker Compose通过docker-compose.yml文件将这三者有机串联。
推理服务层配置
推理服务是整个架构的核心,负责接收请求并返回生成结果,目前主流的方案包括vLLM、Ollama和Text Generation Inference(TGI),以vLLM为例,其高吞吐量特性使其成为高性能场景的首选。
如何选择适合的大模型Docker Compose编排部署方案
在选择具体方案时,需根据硬件配置和业务需求进行权衡。
- vLLM:适合高并发、低延迟场景,支持PagedAttention技术,显存利用率极高。
- Ollama:适合快速原型开发和轻量级应用,内置模型管理,开箱即用。
- TGI:适合生产环境,支持分布式推理,稳定性强,但配置相对复杂。
以下是一个基于vLLM的基础配置示例:
services:
  llm-service:
    image: vllm/vllm-openai:latest
    container_name: vllm-server
    runtime: nvidia
    deploy:
      resources:
        reservations:
          devices:
            - driver: nvidia
              count: 1
              capabilities: [gpu]
    ports:
      - "8000:8000"
    volumes:
      - ./models:/data/models
    command: >
      --model meta-llama/Llama-3-8b-Instruct
      --tensor-parallel-size 1
      --max-model-len 4096
    environment:
      - HF_TOKEN=${HF_TOKEN}
向量数据库与知识库集成
大模型应用通常离不开RAG(检索增强生成)架构,向量数据库用于存储和检索非结构化数据,常见的选择有Chroma、Milvus和Qdrant,Docker Compose可以轻松将这些组件与推理服务连接。
Chroma向量数据库的快速集成
Chroma因其轻量级和易用性,成为许多初创团队的首选,在Compose文件中,只需添加一个服务即可:
  vector-db:
    image: chromadb/chroma:latest
    container_name: chroma-db
    ports:
      - "8001:8000"
    volumes:
      - ./chroma_data:/chroma/chroma
通过环境变量将向量数据库的地址传递给应用层,实现数据检索与大模型生成的无缝对接。
前端应用与服务网关
前端应用负责用户交互,服务网关负责路由和负载均衡,对于小型部署,Nginx或Caddy可以作为反向代理,将外部请求转发到后端的推理服务和向量数据库。
性能优化与故障排查指南
部署完成只是第一步,确保系统稳定高效运行才是关键。
GPU资源监控与调优
GPU利用率是衡量大模型部署效率的重要指标,使用nvidia-smi或专门的监控工具如Grafana+Prometheus,可以实时查看显存占用、GPU温度和使用率。
- 显存优化:通过调整
--max-model-len参数,平衡并发数与显存占用。 - 量化部署:使用INT4或FP8量化模型,可显著降低显存需求,提升推理速度。
- 批量处理:启用
--batch-size参数,利用GPU并行计算能力提升吞吐量。
常见故障排查
在部署过程中,可能会遇到各种意外情况,以下是几种常见问题的解决方案:
- CUDA版本不匹配:确保Docker镜像中的CUDA版本与宿主机驱动兼容,较新的镜像支持较旧的CUDA版本,但反之则不行。
- 显存溢出:检查
--max-model-len设置是否过大,或尝试减少并发请求数。 - 网络连通性问题:检查容器间的网络配置,确保服务间可以通过内部IP或容器名相互访问。
大模型Docker Compose编排部署常见问题解答
大模型Docker Compose编排部署常见问题
如何在大模型Docker Compose编排部署中实现多GPU支持?
在docker-compose.yml中,通过`deploy.resources.reservations.devices`配置多个GPU设备,设置`count: 2`并使用`–tensor-parallel-size 2`参数,即可让模型在两张显卡上并行推理,显著提升处理速度。
大模型Docker Compose编排部署的硬件配置推荐是什么?
对于8B参数量的模型,建议至少配备16GB显存的单张显卡(如RTX 3090/4090),若需部署70B以上模型,建议使用多卡A100/H100或云端GPU实例,内存方面,建议32GB起步,以支持向量数据库和前端服务的运行。
大模型Docker Compose编排部署的成本效益如何分析?
相比云端API调用,私有化部署的初期硬件投入较高,但长期来看,对于高频调用场景,成本优势明显,据行业共识认为,当日均请求量超过一定阈值时,自建服务器的单位成本远低于API调用费用,数据隐私和安全性的提升也是不可忽视的隐性价值。
通过Docker Compose编排部署大模型,不仅简化了技术复杂度,更为企业提供了灵活、可控且高效的AI落地路径,在2026年的技术浪潮中,掌握这一技能,意味着掌握了自主掌控AI能力的钥匙。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/397918.html