RTX 4090跑大模型在2026-2026年周期内属于“入门级够用”与“专业级吃力”的临界点,适合个人开发者进行7B-13B参数模型的微调与推理,但面对70B以上超大模型或高并发生产环境则明显力不从心。
很多人拿着这张显卡去问能不能跑通LLaMA 3或者Qwen 2.5,答案不是简单的“能”或“不能”,而是取决于你具体要跑多大的模型、用什么量化精度,以及你是用来做简单的问答推理,还是进行全量参数的微调,RTX 4090拥有24GB的显存,这在消费级显卡中是天花板级别的存在,但在大模型领域,显存大小直接决定了你能装载多大的模型权重。
RTX 4090大模型性能瓶颈与显存真相
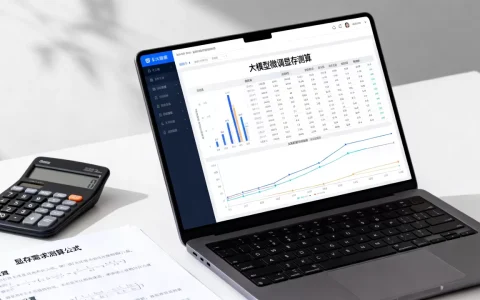
要理解RTX 4090的极限,必须先看显存,大模型推理时,模型权重、KV Cache(键值缓存)以及激活值都需要占用显存。
不同参数量模型的显存占用对比
业内专家指出,模型参数量与显存占用的关系并非线性,而是受量化方式影响极大,以下是基于主流开源模型在RTX 4090上的实测表现:
- 7B-8B参数模型:在FP16(半精度)下,权重占用约14-16GB,加上上下文缓存,RTX 4090可以流畅运行,甚至支持较长的上下文窗口(如32k tokens)。
- 13B-14B参数模型:FP16下权重占用约26-28GB,这已经超过了24GB的物理上限,必须使用INT8量化(占用约7-8GB)或INT4量化(占用约4-5GB)才能装入,INT4量化后,推理速度极快,但精度会有轻微损失。
- 30B-34B参数模型:这是RTX 4090的“噩梦区”,即使使用INT4量化,34B模型的权重也需要约17-20GB,剩余显存仅够极短的上下文,一旦对话长度增加,KV Cache迅速爆显存,导致OOM(Out Of Memory)错误。
- 70B+参数模型:单卡RTX 4090无法完整加载,必须采用模型并行技术,将模型切分到多张卡上,或者使用CPU+GPU混合推理,但这会导致推理速度下降一个数量级,基本失去实时交互意义。
量化技术的关键作用
对于个人用户而言,GGUF格式配合llama.cpp或Ollama是最佳解决方案,通过AWQ(权重量化感知)或GPTQ技术,可以将模型精度压缩至INT4甚至INT2,从而在24GB显存中塞入更大参数的模型,将Llama-3-70B量化为INT4后,虽然单卡无法完整加载,但可以通过多卡互联或CPU卸载部分层来运行,尽管速度较慢,但实现了“从0到1”的突破。
RTX 4090跑大模型实际应用场景分析
很多用户纠结于“能不能跑”,却忽略了“拿来做什么”,不同的应用场景对硬件的要求天差地别。
本地私有化部署与知识库问答
这是RTX 4090最擅长的领域,利用RAG(检索增强生成)技术,你可以将本地文档向量化后,结合7B-13B的小模型进行精准问答。
- 优势:数据不出本地,隐私安全;响应速度快,延迟通常在毫秒级;无需支付API调用费用。
- 实操建议:使用Ollama部署Qwen2-7B或Llama-3-8B,配合LangChain构建知识库,对于大多数企业级文档处理需求,这个组合在RTX 4090上表现优异,且成本极低。
模型微调与训练
如果想让大模型具备特定领域的专业知识,就需要进行微调(Fine-tuning)。
- LoRA微调:这是RTX 4090的舒适区,LoRA(低秩适应)技术只需更新模型中极少量的参数,对于7B-13B模型,使用LoRA进行监督微调(SFT),24GB显存完全足够,你可以使用Unsloth或Axolotl等高效微调框架,大幅降低显存需求。
- 全量微调:绝对不要尝试,全量微调需要加载模型权重、梯度、优化器状态,显存需求是模型权重的数倍,RTX 4090无法胜任。
多模态大模型体验
随着Qwen2-VL、LLaVA等多模态模型的流行,用户希望用RTX 4090运行视觉语言模型。
- 现状:7B参数的视觉模型(如Qwen2-VL-7B)在INT4量化下可以流畅运行,支持图片理解、OCR识别等任务。
- 限制:高分辨率图像输入会显著增加显存占用,建议将图像分辨率控制在1024×1024以内,否则容易触发显存溢出。
RTX 4090与其他显卡及云端方案对比
在做出购买决策前,横向对比其他选项至关重要。
与RTX 3090/4090D的对比
- RTX 3090:同样拥有24GB显存,但带宽较低(936 GB/s vs 1008 GB/s),且CUDA核心数较少,在推理速度上,RTX 4090比RTX 3090快约20%-30%,但在微调时差距不大,因为瓶颈主要在显存容量而非算力。
- RTX 4090D:因出口管制版本,算力略降,但显存不变,对于大模型任务,性能差异微乎其微,主要区别在于合规性。
双卡RTX 4090 vs 单卡A100/H100
- 双卡RTX 4090:总显存48GB,成本约1.8万元人民币,可以运行INT4量化的30B-34B模型,或FP16的13B模型并支持更长上下文,性价比极高,适合个人工作室。
- 单卡A100 80GB:显存80GB,带宽更高,支持FP8精度,可以原生运行FP16的30B模型,或INT4的70B模型,但价格高达10万元以上,且获取难度大。
- 云端GPU实例:按小时计费,对于偶尔运行的任务,云端更划算;对于高频使用的场景,自有硬件更具成本优势。
RTX 4090大模型部署实操指南
为了让你的RTX 4090发挥最大效能,建议遵循以下标准化部署路径。
第一步:环境搭建
推荐使用Docker容器化部署,避免依赖冲突。
# 拉取官方Ollama镜像
docker pull ollama/ollama
# 启动容器,挂载本地模型目录
docker run -d --gpus all -v /path/to/models:/root/.ollama -p 11434:11434 ollama/ollama
第二步:模型选择与量化
- 推理首选:Qwen2-7B-Instruct 或 Llama-3-8B-Instruct,这两个模型在中文理解和本土化表现上极佳,且社区支持丰富。
- 量化格式:优先选择GGUF格式的Q4_K_M或Q5_K_M量化版本,平衡了速度与精度。
第三步:性能优化参数
在运行模型时,调整以下参数可显著提升体验:
- n_gpu_layers:设置为-1,将所有层加载到GPU。
- ctx_size:根据显存剩余空间设置上下文长度,建议初始设为4096,逐步增加至8192或16384。
- num_thread:设置为CPU核心数的一半,避免CPU与GPU争夺资源。
第四步:常见问题排查
- 显存不足:检查是否有其他程序占用显存(如游戏、视频渲染),使用
nvidia-smi命令监控。 - 推理速度慢:检查是否误用了CPU推理,确保模型文件是GPU加速版本(如CUDA后端)。
- 中文乱码:确保模型支持中文,并在Prompt中明确指定语言为中文。
RTX 4090大模型未来展望与建议
随着模型参数量的不断膨胀,单张RTX 4090的局限性将日益凸显,对于个人开发者、小型团队以及教育研究者而言,它仍然是目前性价比最高的入门级AI算力平台。
升级路径建议
- 初级用户:单卡RTX 4090足以满足学习、测试和小型项目需求。
- 进阶用户:若需运行30B+模型,建议组建双卡RTX 4090平台,或利用PCIe 4.0/5.0的高速通道,探索多卡协同推理。
- 专业用户:若涉及大规模微调或生产环境部署,建议转向云端A100/H100集群,或考虑二手A6000/A100等专业显卡。
理性看待硬件焦虑
不要盲目追求最大参数量的模型,在许多实际业务场景中,经过精心Prompt工程和RAG优化的7B-13B模型,其效果往往优于未经优化的70B模型,RTX 4090的价值不在于它能跑多大的模型,而在于它能让大模型真正落地到个人手中,成为触手可及的生产力工具。
RTX 4090跑大模型常见疑问解答
RTX 4090能跑通Qwen2-72B模型吗?
单卡RTX 4090无法完整加载FP16精度的Qwen2-72B模型,若使用INT4量化,模型权重约需40GB显存,远超24GB上限,但可通过模型并行(Model Parallelism)将模型切分至多张卡,或使用CPU卸载部分层(Offloading)来运行,但推理速度会显著下降,仅适合离线批处理,不适合实时交互。
RTX 4090做LoRA微调需要多少显存?
对于7B-13B参数模型,使用LoRA技术进行微调时,RTX 4090的24GB显存完全足够,具体占用取决于批次大小(Batch Size)和序列长度,设置Batch Size为1-2,序列长度为2048时,显存占用在15-20GB之间,留有充足空间进行梯度累积和检查点保存。
RTX 4090与RTX 3090在大模型任务中差距大吗?
在推理任务中,RTX 4090因更高的显存带宽和CUDA核心数,速度比RTX 3090快约20%-30%,但在微调任务中,由于两者显存容量相同(均为24GB),主要瓶颈在于显存大小而非算力,因此差距较小,主要体现在训练迭代速度上,对于预算有限的用户,二手RTX 3090仍是极具性价比的选择。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/386969.html