大模型微调的显存需求并非固定值,它主要取决于模型参数量、微调方法(全量或LoRA)、序列长度以及Batch Size,通常LoRA微调可将显存占用降低至全量微调的1/3至1/5。
在2026年的今天,算力资源依然是制约AI应用落地的核心瓶颈,许多开发者在部署大模型时,往往因为显存估算失误导致训练中断或推理超时,要准确测算显存需求,不能仅凭经验拍脑袋,而需要拆解模型架构、优化策略以及硬件限制这三个关键维度。
基础显存构成:拆解模型的“内存账本”
理解显存占用首先要明白数据在训练和推理过程中是如何流动的,显存主要被四个部分占据:模型权重、梯度、优化器状态以及激活值。
模型权重与优化器状态
这是显存占用的大头,对于全量微调(Full Fine-tuning),你需要加载模型权重,同时为了更新参数,还需要存储梯度,更重要的是,像AdamW这样的优化器,会为每个参数维护动量和方差两个状态变量。
- FP32精度:每个参数占用4字节。
- FP16/BF16精度:每个参数占用2字节。
业内专家指出,优化器状态往往比模型权重本身更占空间,使用Adam优化器时,优化器状态需要的显存通常是模型权重的2倍,这意味着,如果你有一个70亿参数的模型,仅优化器状态就可能吃掉相当于模型权重两倍的空间。
激活值(Activation):隐形的显存杀手
激活值是前向传播过程中产生的中间结果,用于反向传播计算梯度,这部分显存占用与Batch Size(批次大小)和序列长度(Sequence Length)呈线性甚至指数级增长。
- Batch Size:批次越大,显存占用越高。
- 序列长度:处理长文本时,注意力机制的计算复杂度增加,激活值占用急剧上升。
在实际场景中,当Batch Size设为1时,激活值可能只占少量显存;但当Batch Size增加到8或16时,激活值可能成为显存溢出的主要原因。
微调策略对比:LoRA与全量微调的显存博弈
选择哪种微调策略,直接决定了你的显卡能否跑得动,目前主流的方案是全量微调和低秩自适应(LoRA)微调。
全量微调:性能极致,显存昂贵
全量微调需要更新模型的所有参数,虽然效果最好,但显存需求极高,以Llama-3-70B为例,全量微调至少需要8张A100 80GB显卡进行分布式训练,对于大多数个人开发者或小团队来说,这种配置门槛过高。
LoRA微调:性价比之选
LoRA通过冻结预训练权重,仅训练少量低秩矩阵,大幅降低了显存需求。
- 显存节省比例:相比全量微调,LoRA通常可节省60%-80%的显存。
- 适用场景:适合大多数垂直领域微调任务,如客服机器人、代码辅助等。
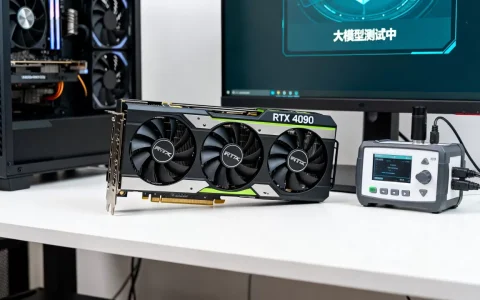
据统计,使用LoRA微调7B参数模型,在单张RTX 4090(24GB显存)上即可实现,而全量微调则几乎不可能。
QLoRA:极限压榨显存
如果显存依然紧张,QLoRA是终极方案,它结合了4-bit量化和LoRA技术,将模型权重量化为4位精度。
- 显存占用:相比FP16,QLoRA可进一步降低30%-50%的显存占用。
- 性能损失:在多数任务中,性能损失极小,几乎可忽略不计。
实操测算公式与工具推荐
知道了原理,如何具体计算?以下是通用的估算逻辑和实操步骤。
显存估算公式
一个简化的显存需求公式如下:
$$
text{Total VRAM} approx text{Model Weights} + text{Optimizer States} + text{Gradients} + text{Activations}
$$
- Model Weights:参数量 × 字节数(FP16为2字节)。
- Optimizer States:参数量 × 字节数 × 优化器状态数(Adam为2)。
- Gradients:参数量 × 字节数。
- Activations:与Batch Size和序列长度强相关,需通过实验调整。
使用工具自动测算
手动计算容易出错,推荐使用以下工具进行精确测算:
- Hugging Face Transformers:内置
compute_stats功能,可自动输出各模块显存占用。 - PyTorch Profiler:通过代码插入Profiler,详细记录每一步的显存变化。
- NVIDIA Nsight Systems:可视化分析GPU资源使用情况,定位显存瓶颈。
实操步骤:使用Hugging Face测算
from transformers import AutoModelForCausalLM
import torch
model = AutoModelForCausalLM.from_pretrained("model_name", torch_dtype=torch.float16)
# 执行前向传播以计算激活值
input_ids = torch.randint(0, 1000, (1, 512))
outputs = model(input_ids)
# 查看显存占用
torch.cuda.memory_allocated()
常见场景下的显存需求参考
不同场景对显存的需求差异巨大,以下是基于2026年主流硬件环境的参考数据。
| 模型规模 | 微调方式 | 推荐显存 | 适用硬件示例 |
|---|---|---|---|
| 7B | LoRA | 12-16 GB | RTX 3090/4090 |
| 7B | QLoRA | 8-10 GB | RTX 3060/4060 |
| 13B | LoRA | 24-32 GB | RTX 4090 / A6000 |
| 70B | QLoRA | 48-64 GB | A100 80GB / 双卡4090 |
长文本处理的特殊考量
当序列长度超过4096时,显存占用会显著增加,建议采用以下优化策略:
- 梯度检查点(Gradient Checkpointing):用计算换显存,牺牲少量训练速度,大幅降低激活值占用。
- Flash Attention 2:优化注意力机制计算,减少中间激活值存储,提升训练效率。
如何选择合适的显卡配置
选择显卡不仅看显存大小,还要看带宽和互联方式。
消费级显卡 vs 专业级显卡
- RTX 4090:性价比高,适合小规模微调,但显存仅24GB,且不支持NVLink,多卡扩展性差。
- A100/H100:显存大(80GB),支持NVLink,适合大规模分布式训练,但价格昂贵,租赁成本高。
显存带宽的重要性
显存带宽决定了数据读取速度,对于大模型,带宽不足会导致GPU等待数据,形成瓶颈,A100的显存带宽约为2TB/s,而RTX 4090约为1TB/s,在训练大模型时,带宽的影响不容忽视。
微调显存需求怎么测算:Q&A
大模型微调显存需求怎么测算具体步骤是什么?
首先确定模型参数量和精度(FP16/FP32),计算权重占用,根据优化器类型(如Adam)计算优化器状态和梯度占用,通常是权重的2-3倍,通过小规模实验测试不同Batch Size和序列长度下的激活值占用,使用Hugging Face的compute_stats或PyTorch Profiler可自动获取精确数据。
LoRA和全量微调哪个更省显存?
LoRA显著更省显存,全量微调需要存储权重、梯度和优化器状态,显存占用约为模型权重的4倍,LoRA仅训练少量低秩矩阵,优化器状态也仅针对这些矩阵,因此显存占用可降低至全量微调的1/3至1/5,对于70B以上模型,LoRA几乎是唯一可行的微调方案。
显存不足时有哪些优化手段?
可采用梯度检查点技术,用计算换显存,减少激活值存储,使用QLoRA将模型量化为4位精度,大幅降低权重占用,调整Batch Size为1,或减小序列长度,启用Flash Attention 2优化注意力计算,使用ZeRO-3等分布式优化技术,将参数分片存储在多张显卡上,也可有效缓解单卡显存压力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/386965.html