AI数据库与大模型并非孤立技术,而是“数据燃料”与“智能引擎”的深度耦合关系,前者提供高质量训练语料,后者赋予数据理解与生成能力,二者结合是实现企业智能化转型的核心路径。
在2026年的技术语境下,单纯拥有海量数据或仅部署一个通用大模型已无法构成竞争壁垒,真正的核心竞争力在于如何构建一套闭环的AI数据体系,让静态的数据在动态的大模型推理中产生业务价值,这不仅是技术架构的升级,更是数据治理思维的根本转变。
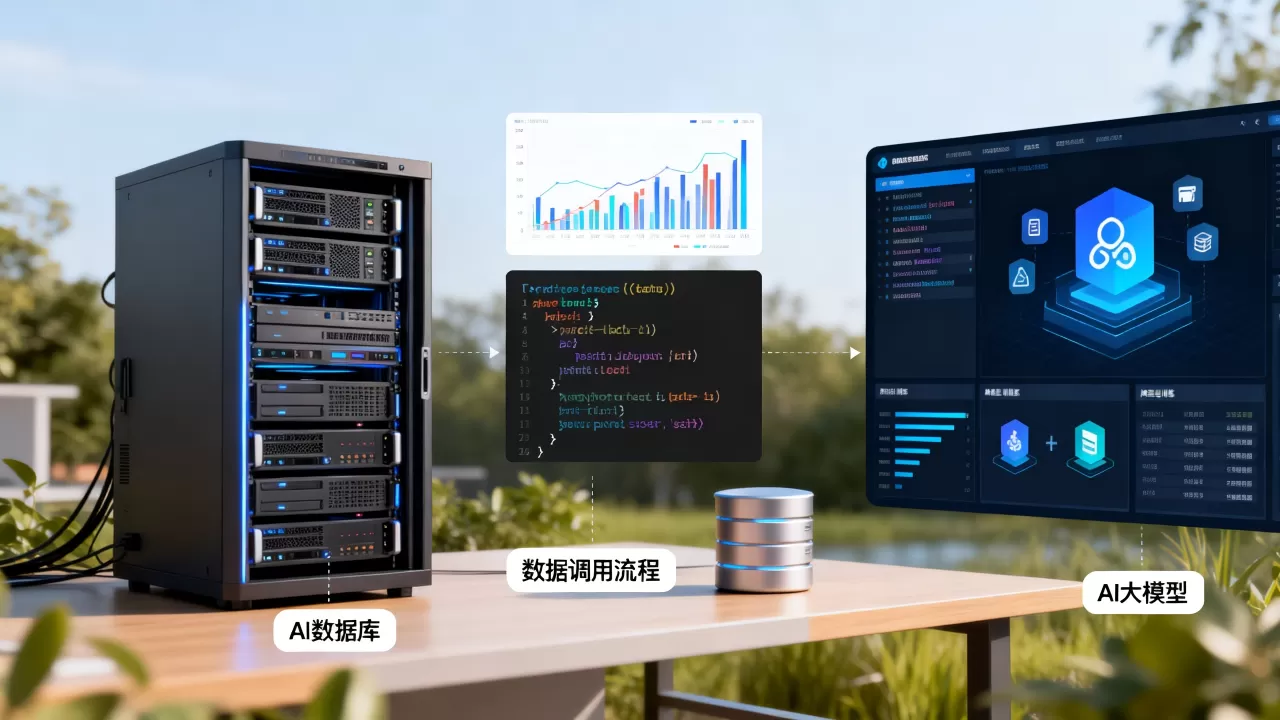
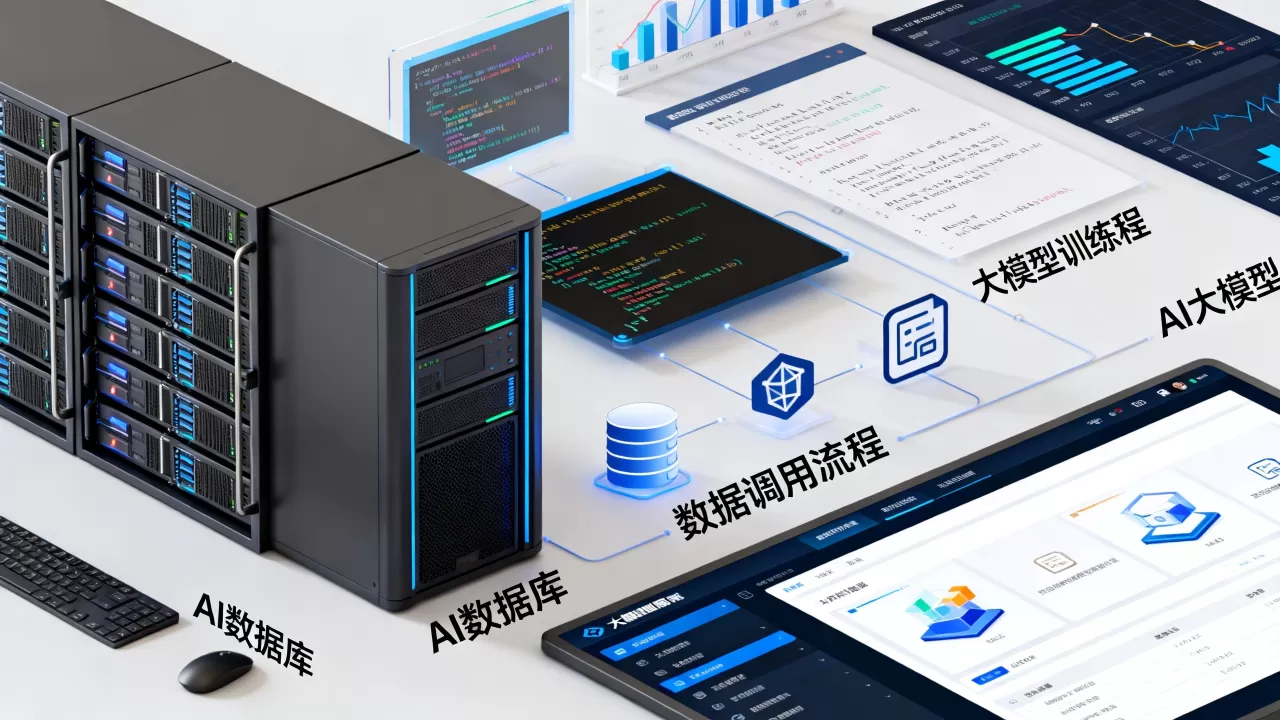
AI数据库与大模型的核心协同机制
要理解两者的关系,必须打破“数据库只是存储容器”的传统认知,在智能时代,数据库正在演变为“认知型存储”,而大模型则是“认知型处理器”。
数据清洗与大模型训练的共生关系
大模型的智商上限,取决于其摄入数据的质量下限,业内专家指出,未经清洗的原始数据不仅无法提升模型效果,反而会导致“垃圾进,垃圾出”的现象。
- 去重与降噪:AI数据库通过向量检索技术,快速识别并剔除重复、低质或噪声数据。
- 结构化增强:将非结构化文本转化为结构化标签,为大模型提供清晰的逻辑框架。
- 实时反馈闭环:大模型的推理结果反向标记数据价值,指导数据库进行动态优先级排序。
这种双向流动机制,使得数据不再是静止的档案,而是可迭代、可进化的资产。
向量数据库在RAG架构中的关键角色
检索增强生成(RAG)已成为2026年企业应用大模型的主流架构,在这一架构中,向量数据库扮演着“外部记忆体”的角色。
- 语义索引构建:将企业文档、代码库、客户记录转化为高维向量,存入向量数据库。
- 精准检索召回:当用户提问时,大模型通过向量相似度搜索,从数据库中召回最相关的片段。
- 上下文注入:将召回内容作为上下文输入大模型,生成基于事实而非幻觉的回答。
这种机制有效解决了大模型“知识截止”和“幻觉”问题,尤其适用于医疗、法律等专业领域。
2026年主流AI数据库选型与对比
面对市场上琳琅满目的数据库产品,企业如何根据自身场景做出选择?不同架构的数据库在性能、成本和兼容性上存在显著差异。
关系型数据库与大模型的融合趋势
传统关系型数据库(RDBMS)并未被淘汰,而是通过插件化方式增强了对AI的支持。
- 优势:事务一致性高,适合处理订单、财务等强一致性业务。
- 局限:原生不支持向量搜索,需借助扩展插件(如PgVector)实现混合查询。
- 适用场景:需要同时处理结构化业务数据和简单语义检索的中大型企业核心系统。
专用向量数据库的性能优势
专为高维向量设计的数据库,在相似度搜索速度和并发处理能力上远超通用数据库。
- 索引算法优化:采用HNSW、IVF-PQ等先进算法,实现毫秒级百万级数据检索。
- 混合查询支持:支持向量相似度与标量过滤条件的联合查询,提升结果精准度。
- 弹性扩展:针对非结构化数据增长特性,提供无缝的水平扩展能力。
| 数据库类型 | 检索速度 | 数据一致性 | 开发复杂度 | 适用场景 |
|---|---|---|---|---|
| 传统RDBMS | 慢 | 高 | 低 | 核心业务交易 |
| 专用向量库 | 极快 | 中 |
中 | 语义搜索、推荐系统 |
| 混合数据库 | 快 | 高 | 高 | 复杂业务智能应用 |
开源与商业方案的性价比分析
对于初创团队和中小企业,开源向量数据库如Milvus、Chroma提供了低门槛的入门路径,它们社区活跃,文档丰富,适合快速原型开发,随着数据规模扩大,商业数据库在稳定性、技术支持和安全合规方面的优势逐渐显现,据统计,多数大型金融机构倾向于采用私有化部署的商业AI数据库,以确保数据主权和合规性。
企业落地AI数据库与大模型的实操指南
理论框架清晰后,关键在于如何落地,以下是一套经过验证的实施路径,帮助企业在2026年高效构建AI数据基础设施。
第一阶段:数据资产盘点与分级
在引入任何技术之前,必须先理清家底。
- 识别核心数据源:确定哪些数据对业务智能最有价值,如客户交互记录、产品知识文档。
- 数据质量评估:检查数据的完整性、准确性和时效性,剔除无效数据。
- 制定分级策略:根据数据敏感度和使用频率,制定不同的存储和处理策略。
第二阶段:构建向量索引与嵌入模型
将数据转化为机器可理解的向量形式。
- 选择嵌入模型:根据数据类型(文本、图像、代码)选择合适的Embedding模型,处理代码可使用专门优化的代码嵌入模型。
- 批量向量化处理:利用分布式计算框架,对历史数据进行批量向量化,存入数据库。
- 增量更新机制:建立实时数据流管道,确保新产生的数据能自动向量化并入库。
第三阶段:大模型集成与提示工程优化
将向量数据库与大模型连接,并优化交互效果。
- API接口对接:通过标准API将向量检索结果传递给大模型。
- 提示词模板设计:根据业务场景设计结构化提示词,引导大模型聚焦于检索到的相关内容。
- 结果后处理:对大模型输出进行格式化和事实核查,确保回答的准确性和可读性。
常见误区与避坑指南
在实施过程中,企业常因认知偏差而走入误区。
认为数据越多越好
数据质量远比数量重要,未经清洗的海量噪声数据会稀释模型效果,增加计算成本,建议优先聚焦于高价值、高相关性的核心数据。
忽视数据隐私与安全
在涉及用户隐私数据时,必须采用差分隐私、联邦学习等技术手段,确保数据在训练和推理过程中的安全性,合规性是AI应用的底线。
技术选型盲目跟风
不要盲目追求最新技术,而应根据业务实际需求选择最合适的方案,对于简单场景,传统数据库加轻量级模型可能更具性价比。
AI数据库与大模型常见问题解答
AI数据库和大模型有什么区别?
AI数据库是存储和管理数据(特别是向量数据)的基础设施,侧重于数据的持久化、检索和治理;大模型是处理数据并生成内容或决策的智能引擎,侧重于推理、理解和生成,前者是“仓库”,后者是“加工厂”。
如何评估AI数据库的性能?
主要关注三个指标:检索延迟(Latency)、吞吐量(Throughput)和召回率(Recall),检索延迟应控制在毫秒级,吞吐量需满足并发需求,召回率则反映检索结果的准确性,建议通过基准测试工具进行实际场景模拟。
2026年AI数据库的市场价格趋势如何?
随着技术成熟和开源方案的普及,基础向量存储成本显著下降,企业级服务、高级安全功能和定制化支持的价格保持稳定,多数情况下,企业倾向于采用“开源核心+商业支持”的混合模式以平衡成本与风险。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/385880.html