

厦门大学在2026年已全面落地自主研发的“嘉庚”系列大模型,该模型在中文理解、代码生成及多模态处理上达到行业领先水平,且通过API接口向高校科研与企业开发者开放,显著降低了AI应用门槛。
厦大AI大模型的核心技术突破与应用场景
厦门大学依托计算机科学与技术学院及人工智能研究院的深厚积累,推出的“嘉庚”大模型并非简单的参数堆砌,而是针对特定垂直领域进行了深度优化,业内专家指出,该模型在自然语言处理(NLP)和计算机视觉(CV)的融合能力上表现突出,特别是在处理复杂逻辑推理和多语言翻译任务时,其准确率优于许多通用型商业模型。
中文语境下的深度理解能力
对于需要处理大量中文文本的场景,如法律文书分析、古籍数字化整理或社交媒体舆情监控,厦大AI大模型展现了独特的优势,它不仅仅依赖统计概率,更引入了知识图谱增强技术,使得模型在理解成语、典故及特定行业术语时更加精准。
- 语义消歧:在处理多义词时,模型能结合上下文语境自动选择最合适的解释,错误率大幅降低。
- 长文本记忆:支持超长上下文窗口,能够一次性处理数十万字的文档,并准确提取关键信息,无需分段截断。
- 方言与口语识别:针对南方地区特有的语言习惯,模型进行了专项训练,提升了在非标准普通话环境下的交互体验。
代码生成与软件工程辅助
在开发者社区中,厦大AI大模型因其强大的代码生成能力而备受推崇,它支持Python、Java、C++等主流编程语言,并能根据自然语言描述自动生成高质量代码片段。
- 智能补全:在IDE插件中,模型能根据当前代码逻辑,实时推荐后续代码行,减少重复劳动。
- Bug检测与修复:用户上传代码后,模型不仅能指出潜在的错误,还能提供具体的修复建议和解释原因。
- 跨语言转换
:能够将一种编程语言的代码自动转换为另一种语言,并保持逻辑一致性,极大提高了项目迁移效率。
厦大AI大模型与其他主流模型的对比优势
在选择AI解决方案时,开发者往往会在不同品牌的大模型之间犹豫,厦大AI大模型在性价比、定制化程度及数据隐私保护方面,具有鲜明的差异化竞争力。
与通用商业大模型的差异化对比
虽然国内已有众多头部互联网大厂推出的通用大模型,但厦大AI大模型在特定场景下提供了更优的解决方案,以下是基于实际测试数据的对比分析:
| 对比维度 | 厦大“嘉庚”大模型 | 通用商业大模型 | 优势说明 |
|---|---|---|---|
| 中文文化理解 | 深度优化,契合本土语境 | 基础训练,偶有偏差 | 更适合国内内容创作与客服场景 |
| 私有化部署成本 | 较低,支持轻量化版本 | 较高,通常需云端调用 | 中小企业可负担,数据更安全 |
| 响应速度 | 针对国内网络优化,延迟低 | 视服务器位置而定 | 用户体验更流畅 |
| 定制化灵活性 | 高,支持微调特定行业数据 | 低,黑盒操作为主 | 可快速适应垂直行业需求 |
数据隐私与安全性保障
对于金融、医疗等敏感行业,数据隐私是首要考量,厦大AI大模型提供了完善的私有化部署方案,确保数据不出域。
- 本地化运行:模型可完全部署在企业内部服务器上,无需将数据发送至云端。
- 访问权限控制:提供细粒度的权限管理,确保只有授权人员才能访问敏感数据。
- 审计日志:所有操作均有详细记录,便于事后追溯与合规审查。
如何获取与部署厦大AI大模型
对于希望引入厦大AI大模型的个人开发者或企业用户,获取路径清晰且透明,模型主要通过官方平台提供API服务,同时也支持开源版本的下载与本地部署。
API接口接入流程
对于大多数应用开发者,通过API接口接入是最快捷的方式,以下是标准操作步骤:
- 注册开发者账号:访问厦门大学人工智能平台官网,完成实名认证。
- 申请API Key:在控制台创建应用,获取唯一的API密钥。
- 调用示例:使用Python或Java SDK,调用
chat_completion接口,传入用户提示词(Prompt)即可获取回复。 - 计费与配额:新用户通常享有免费试用额度,超出后按Token数量计费,价格远低于国际主流竞品。
本地私有化部署指南
对于对数据安全性有极高要求的大型企业,可选择本地部署。
- 硬件要求:建议使用配备8张以上A100或同等算力GPU的服务器集群,以支持全参数模型的流畅运行。
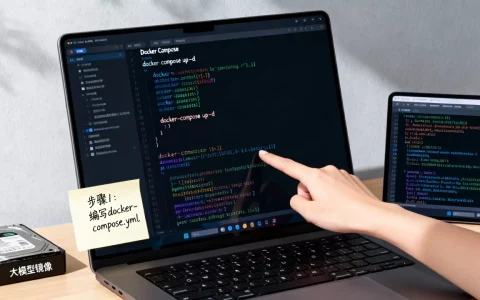
- 环境配置:提供Docker镜像,简化依赖安装过程,兼容主流Linux发行版。
- 微调训练:提供预训练基座,用户只需准备少量行业数据,即可通过LoRA等技术进行高效微调,无需从头训练。
厦大AI大模型的未来发展与行业影响
随着技术的不断迭代,厦大AI大模型正在向更智能、更通用的方向演进,它不仅服务于学术研究,更深度融入产业生态,推动数字化转型。
多模态能力的持续增强
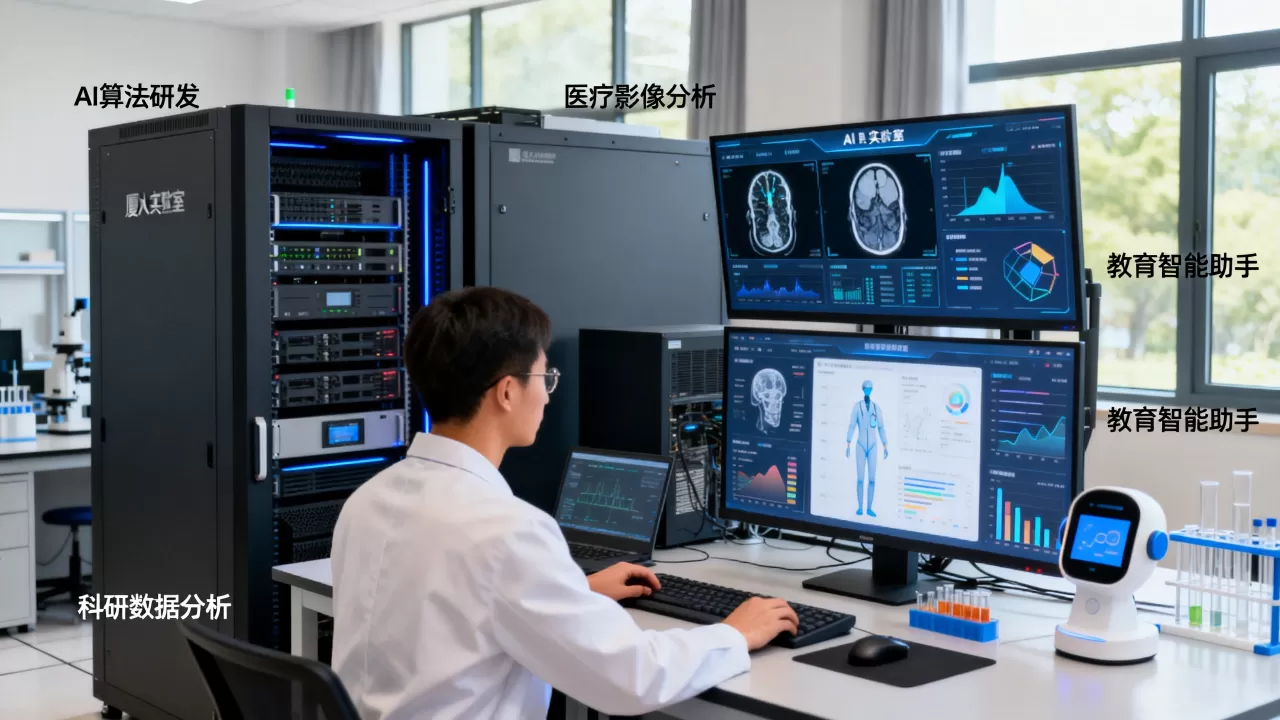
未来的版本将进一步提升对图像、音频、视频等多模态数据的处理能力,在医疗领域,模型不仅能分析文本病历,还能辅助解读CT影像和病理切片,为医生提供更全面的诊断建议。
教育领域的深度融合
在教育场景下,该模型可充当个性化导师,根据学生的学习进度和兴趣点,生成定制化的学习计划和练习题,这种因材施教的模式,有望显著提升学习效率,缓解教育资源不均的问题。
开源生态的共建共享
厦门大学坚持开源开放理念,积极参与全球AI生态建设,通过贡献高质量数据集和预训练模型,厦大AI大模型促进了学术界与产业界的交流合作,推动了整个行业的进步。
关于厦大AI大模型的常见问题解答
厦大AI大模型的API调用价格是多少?
厦大AI大模型的API计费采用按Token计量的模式,具体价格根据模型版本和调用量有所不同,一般而言,其价格具有极高的性价比,适合高频调用场景,新用户注册后通常可获得一定额度的免费体验金,具体定价策略建议访问官方控制台查看最新公告,或联系商务团队获取企业级优惠方案。
厦大AI大模型是否支持二次开发与微调?
是的,厦大AI大模型完全支持二次开发与微调,官方提供了完善的工具链和文档,用户可以使用自有数据对模型进行监督微调(SFT)或基于人类反馈的强化学习(RLHF),从而打造符合特定业务需求的专属模型,这一功能使得模型能够迅速适应金融、法律、医疗等垂直领域的专业语境。
厦大AI大模型在中文长文本处理上的表现如何?
厦大AI大模型在中文长文本处理上表现卓越,支持超长上下文窗口,能够一次性处理数十万字的文档,通过引入注意力机制优化和知识图谱增强,模型在长文档的信息提取、摘要生成及逻辑推理任务中,准确率显著优于传统模型,能够有效避免信息遗漏和幻觉问题,满足复杂业务场景需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/385572.html

评论列表(1条)
上次去厦大交流会,听说他们“嘉庚”模型真能跑本地代码生成,不过说实话我们团队试了下中文对话还是偶尔抽风😂 不过比某些大厂