跑AI大模型的核心在于根据模型规模选择本地硬件或云端算力,对于个人开发者,使用开源模型配合量化技术是平衡成本与性能的最佳方案。
很多人一听到“跑大模型”,脑海里浮现的都是千万级的服务器集群或者昂贵的显卡机房,随着开源生态的爆发,现在连普通用户也能在自己的设备上让AI“动”起来,这不仅仅是技术炫技,更是数据隐私保护和定制化需求下的必然选择。
硬件门槛与算力选择:从消费级到专业级
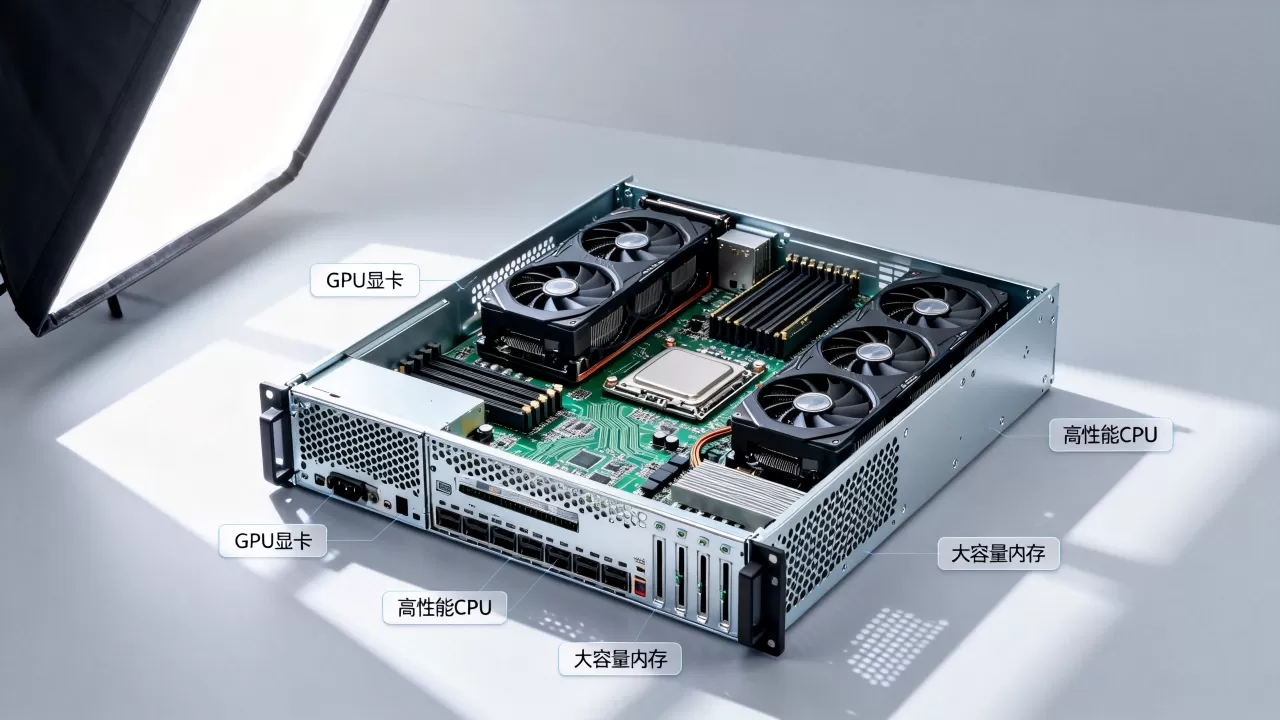
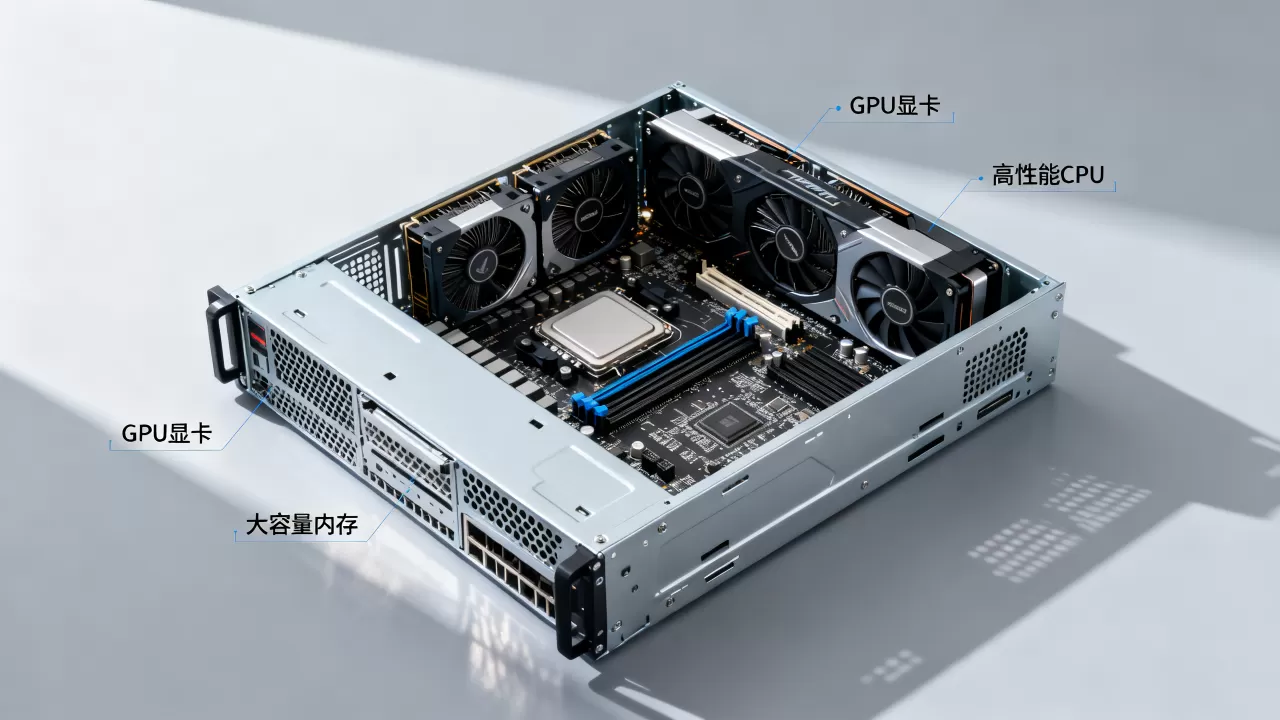
跑模型的第一步,是搞清楚你的电脑能不能扛得住,业内专家指出,显存(VRAM)大小直接决定了你能跑多大的模型,而不仅仅是显卡的核心速度。
消费级显卡的极限在哪里
对于大多数个人用户来说,NVIDIA的RTX系列显卡是首选,这里有一个简单的换算逻辑:模型参数量越大,占用的显存越多。
- 7B参数模型:通常只需要8GB显存即可流畅运行,甚至可以在较低画质下尝试13B模型。
- 13B-30B参数模型:这是目前性价比最高的区间,需要16GB至24GB显存,RTX 3090/4090这类24GB显存的卡是主力军。
- 70B以上超大模型:个人显卡几乎无法单卡运行,需要多卡互联或依赖云端算力。
如果你正在纠结RTX 4090跑大模型性价比,答案是肯定的,它是目前消费级市场的“机皇”,24GB显存让它能本地运行经过量化处理的Llama-3-70B或Qwen-72B模型,虽然价格高昂,但对于需要高频调用私有数据的开发者来说,一次投入,长期受益。
内存与CPU的辅助作用
当显存不够时,系统会调用系统内存(RAM)和CPU进行计算,虽然速度会慢很多,但能跑起来。
-
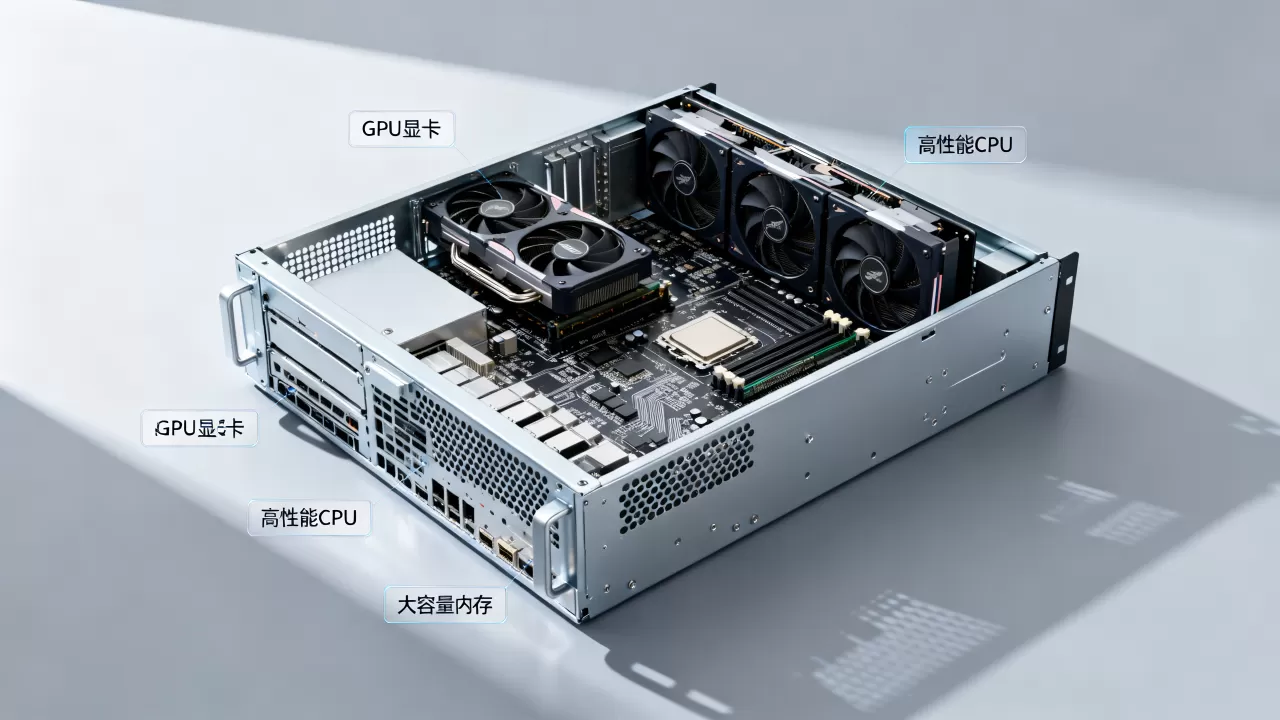
内存容量:建议64GB起步,最好达到128GB,因为大模型加载时会同时占用显存和内存。
- 硬盘速度:必须使用NVMe SSD,模型加载速度受限于硬盘读写带宽,机械硬盘会让加载时间变得不可接受。
软件生态与部署工具:告别代码焦虑
以前跑模型需要写Python脚本、配置虚拟环境、处理依赖冲突,工具链已经高度成熟,甚至实现了“一键部署”。
主流部署工具对比
不同的工具有不同的侧重点,选择适合你的工具能节省大量时间。
| 工具名称 | 适用场景 | 优点 | 缺点 |
|---|---|---|---|
| Ollama | 本地快速测试、API服务 | 安装极简,支持多模型管理,命令行友好 | 自定义程度较低,适合标准用法 |
| LM Studio | 图形界面爱好者、初学者 | 可视化操作,无需命令行,模型库丰富 | 资源占用略高,高级功能有限 |
| Text Generation WebUI | 高级用户、角色扮演 | 插件丰富,支持LoRA微调,界面灵活 | 配置复杂,依赖较多 |
如果你想知道本地部署大模型哪个软件好用,对于新手,强烈推荐从Ollama
开始,它在终端输入一行命令即可下载并运行模型,例如ollama run llama3,对于需要图形界面操作的用户,LM Studio提供了直观的模型浏览和对话界面,无需任何代码基础。
量化技术:小显存的大智慧
量化是将模型参数从高精度(如FP16)转换为低精度(如INT4、INT8)的技术,这能大幅减少显存占用,同时保持较高的推理质量。
- INT4量化:显存占用减少约75%,速度提升明显,质量损失极小,是个人部署的主流选择。
- INT8量化:平衡了速度与精度,适合对准确率要求较高的场景。
- FP16/BF16:原始精度,显存占用大,通常仅在显存充足且追求极致效果时使用。
应用场景与实战技巧:让AI真正为你所用
跑通模型只是开始,如何让它发挥价值才是关键,不同的应用场景对模型的要求截然不同。
代码辅助与开发提效
程序员是本地大模型的最大受益群体之一,将代码库作为上下文输入,模型能提供精准的代码补全、Bug修复和重构建议。
- 操作步骤:
- 安装Ollama并运行CodeLlama或StarCoder模型。
- 配置IDE插件(如Continue或CodeGeeX)。
- 在IDE中直接调用本地API进行代码生成。
这种方式确保了代码不会上传到云端,保护了核心知识产权。
私人知识库与文档问答
结合RAG(检索增强生成)技术,可以让大模型基于你的私有文档进行回答。
- 工具推荐:使用RAGFlow或Dify等开源平台。
- 流程:
- 上传PDF、Word或Markdown文件。
- 系统自动进行分块和向量化。
- 用户提问时,系统先检索相关片段,再交给大模型生成答案。
这种方案解决了大模型“幻觉”问题,确保回答基于事实。
角色扮演与创意写作
本地部署允许你微调模型,使其具有特定的性格或写作风格。
- 微调方法:使用LoRA技术,只需少量数据即可训练出特定风格的模型。
- 优势:相比云端API,本地微调没有频率限制,可以无限次生成内容,且数据完全私有。
常见问题与误区澄清
Q&A:关于本地跑大模型的常见疑问
Q1: 没有NVIDIA显卡,能用AMD或Intel显卡跑大模型吗?
可以,但体验不如NVIDIA,AMD显卡通过ROCm框架支持,Intel显卡通过OpenVINO支持,虽然兼容性在逐步改善,但驱动配置和性能优化仍比NVIDIA复杂,适合愿意折腾的技术爱好者。
Q2: 本地跑大模型和调用API有什么区别?
核心区别在于数据隐私和长期成本,API调用方便,但数据经过第三方服务器,且按Token计费,高频使用成本高,本地部署一次性投入硬件,后续无额外费用,且数据完全留在本地,适合处理敏感信息。
Q3: 为什么我的模型运行速度很慢?
速度瓶颈通常不在显卡,而在内存带宽和硬盘读取速度,当模型大于显存时,系统会在显存和内存之间频繁交换数据,导致速度骤降,确保使用高速NVMe SSD,并尽可能将模型量化以适配显存,是提升速度的关键。
跑AI大模型不再是少数人的特权,通过合理的硬件选择和成熟的工具链,每个人都能构建属于自己的AI助手,关键在于明确需求,选择合适的模型规模,并充分利用量化技术优化性能。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/379067.html