AI大模型的核心架构由“数据预处理-预训练-指令微调-人类反馈强化学习”四阶段构成,其本质是通过Transformer结构让机器从海量文本中习得逻辑与语言规律。
理解大模型并非理解黑盒魔法,而是拆解其工程实现路径,业内专家指出,当前主流架构已高度趋同,差异主要体现在数据质量、算力调度及微调策略上。
Transformer:大模型的底层骨架
所有现代大语言模型都建立在Transformer架构之上,这一架构取代了传统的循环神经网络,解决了长序列依赖和并行计算的难题。
自注意力机制的核心作用
自注意力机制(Self-Attention)是Transformer的灵魂,它让模型在处理每个词时,都能“看”到句子中所有其他词的关系。
- 并行计算优势:传统RNN必须按顺序处理,速度极慢,Transformer允许一次性处理整个序列,大幅缩短训练时间。
- 全局视野:无论词语相隔多远,注意力机制都能捕捉其关联,例如在翻译长难句时,主语和动词即便相距甚远,模型也能精准对齐。
编码与解码的结构分工
在生成式任务中,编码器负责理解输入,解码器负责生成输出。
- 编码器:将输入文本转化为高维向量表示,保留语义信息。
- 解码器:基于编码结果,逐词预测下一个最可能的token。
- 多头注意力:模型同时运行多个注意力头,分别捕捉语法、语义、指代等不同维度的信息,最后融合输出。
数据工程:决定模型上限的关键
算力决定下限,数据决定上限,没有高质量数据,再强的架构也只是空壳。
预训练数据的清洗流程
预训练数据通常来自互联网公开文本,包含大量噪声,清洗流程至关重要。
- 去重:移除重复网页,防止模型过拟合特定内容。
- 过滤:剔除低质量、广告、乱码及有害内容。
- 比例控制:合理分配代码、书籍、对话、百科等数据比例,平衡通用能力与垂直领域能力。
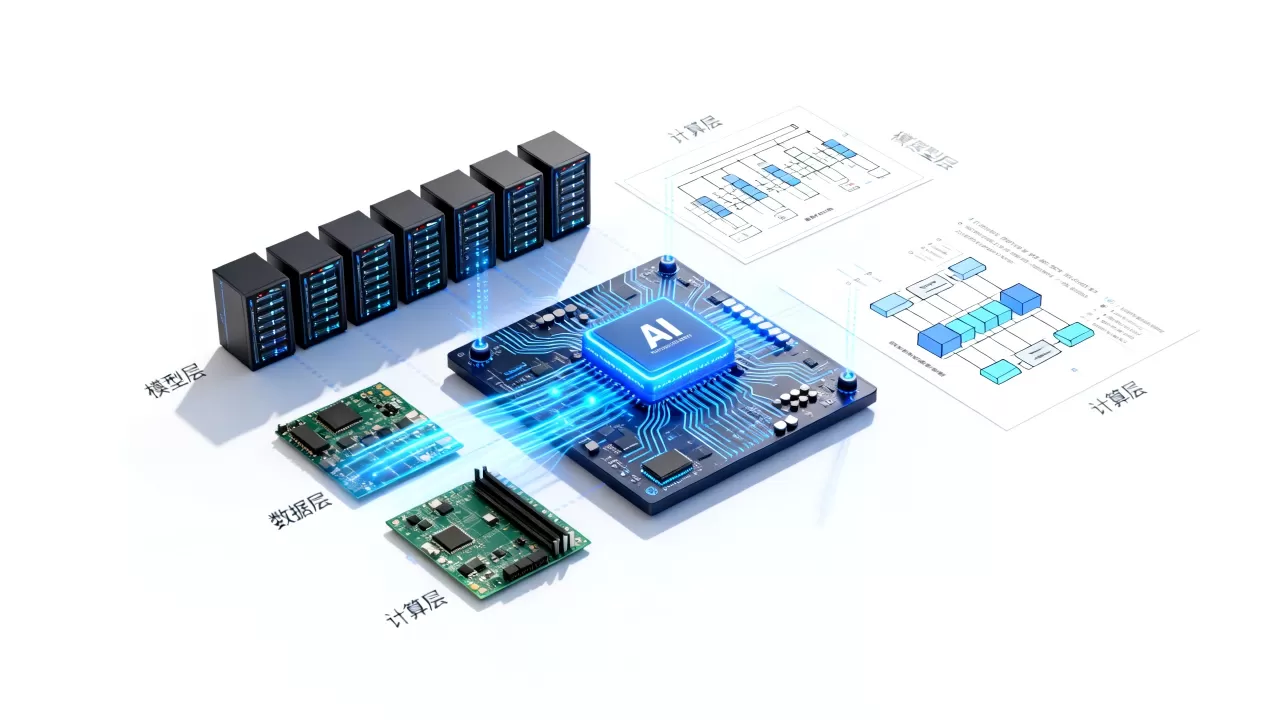
数据对模型能力的影响
- 代码能力:依赖高质量的GitHub代码库,需包含注释和文档。
- 逻辑推理:依赖数学题、逻辑谜题及思维链数据。
- 多语言支持:依赖多语种平行语料,小语种数据稀缺易导致效果下降。
据工信部数据,高质量清洗后的数据占比往往不足原始数据的10%,但贡献了绝大部分模型智能。
训练三阶段:从知识到智能的进化
大模型训练不是一蹴而就,而是分阶段迭代的过程。
无监督预训练
模型通过预测下一个词,学习语言的基本规律和世界知识。
- 目标:最大化语言建模概率。
- 结果:模型获得广泛的常识、语法和事实性知识。
- 局限:无法直接理解人类指令,可能产生幻觉或拒绝回答。
有监督指令微调
使用高质量的人机对话数据,教会模型遵循指令。
- 数据构建:人工撰写或LLM生成“指令-输入-输出”三元组。
- 目标:让模型学会格式化输出,如总结、翻译、代码生成。
- 效果:模型从“续写机器”变为“助手”,具备基本任务完成能力。
人类反馈强化学习
这是让模型对齐人类价值观的关键步骤。
- 奖励模型训练:人类对模型多个输出进行排序,训练奖励模型预测人类偏好。
- PPO优化:基于奖励模型,调整策略模型参数,最大化人类满意度。
- DPO替代方案:近年出现直接偏好优化算法,无需显式奖励模型,简化流程并提升稳定性。
业内专家指出,RLHF阶段往往占据总训练成本的较大比例,因为高质量标注极其昂贵。
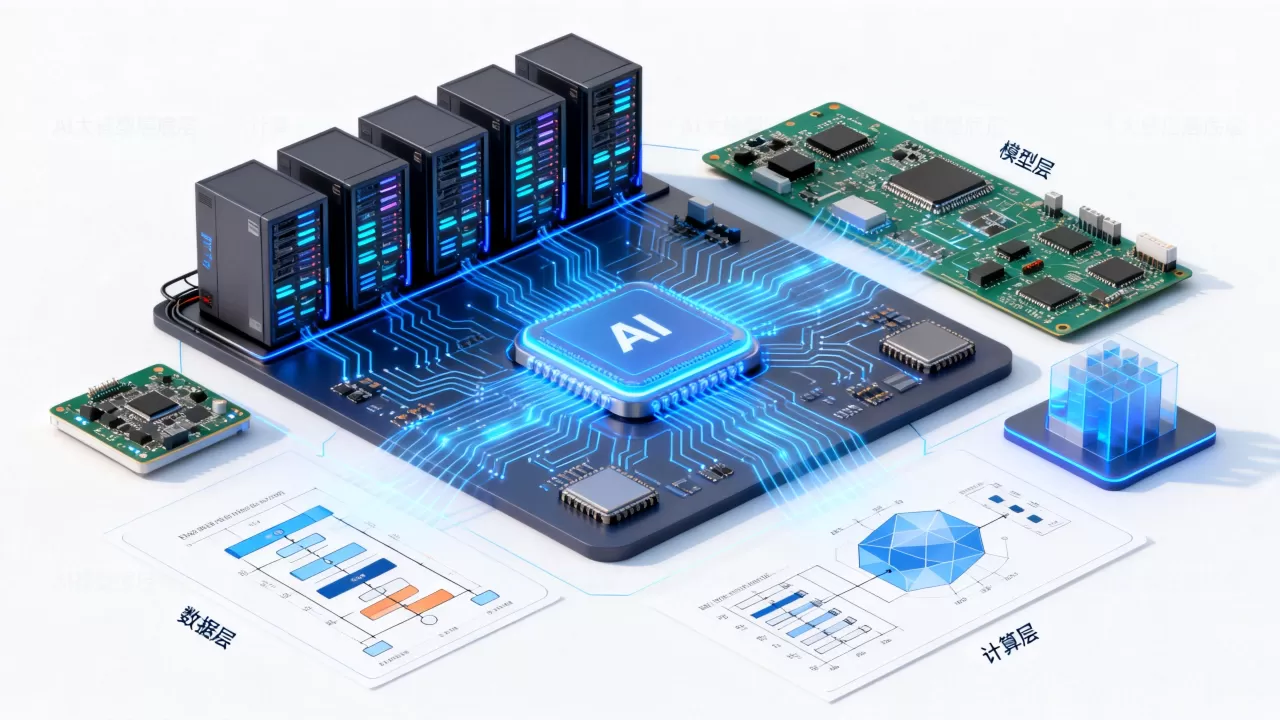
推理优化:降低延迟与成本
训练好的模型需要高效部署才能服务用户,推理优化是落地核心。
量化技术
将模型参数从16位浮点数降低至8位、4位甚至更低,显著减少显存占用。
- INT8量化:精度损失小,兼容性好,适合大多数场景。
- INT4量化:大幅加速,但需仔细校准以避免精度崩溃。
- AWQ/GPTQ:先进量化算法,在低比特下保持较高性能。
KV Cache与连续批处理
- KV Cache:缓存已生成token的键值对,避免重复计算,提升长文本生成速度。
- 连续批处理:动态合并不同长度的请求,提高GPU利用率。
模型压缩与蒸馏
- 知识蒸馏:用大模型指导小模型训练,小模型继承大模型能力。
- 剪枝:移除不重要的神经元或连接,减少模型体积。
架构变体与未来趋势
虽然Transformer主导,但新架构正在探索中。
MoE:混合专家模型
Mixture of Experts通过门控网络,每次仅激活部分专家网络。
- 稀疏激活:计算量与参数量解耦,推理成本大幅降低。
- 容量扩展:可增加总参数量而不增加计算负担,提升模型容量。
- 挑战:负载均衡难,易出现专家崩溃。
状态空间模型
如Mamba架构,旨在解决Transformer线性复杂度问题。
- 线性复杂度:处理超长序列时效率更高。
- 硬件友好:更适合特定硬件加速。
- 现状:目前在长文本和特定任务中表现优异,通用性仍在验证。
选型与部署建议
选择大模型需结合具体场景。
开源 vs 闭源
-
闭源模型:如GPT-4、Claude,性能顶尖,API调用方便,但数据隐私受限,成本随用量增加。
- 开源模型:如Llama、Qwen,可私有化部署,数据可控,定制灵活,但需自建算力团队。
垂直领域微调
通用模型在医疗、法律等专业领域表现有限。
- LoRA微调:低秩适应技术,仅需微调少量参数,成本低,速度快。
- RAG增强:检索增强生成,外挂知识库,解决幻觉问题,无需重新训练。
成本估算参考
部署私有模型需考虑硬件投入。
- 显存需求:7B模型需约14GB显存,70B模型需约140GB显存(INT8量化下)。
- 算力成本:训练千亿参数模型需数千张高端GPU,耗时数周至数月。
- 运维成本:包括集群管理、监控、故障恢复等隐性支出。
常见问题解答
AI大模型架构详解中,如何平衡性能与成本?
平衡性能与成本需采用分层策略,基础查询使用小参数模型或检索增强生成,复杂推理调用大参数模型,利用量化技术和MoE架构降低推理成本,对于高频场景,缓存热门结果;对于低频场景,按需加载。
AI大模型架构详解中,私有化部署的最佳实践是什么?
私有化部署最佳实践包括:选择经过指令微调的开源基座模型,使用LoRA进行领域适配,部署量化版本以节省显存,结合RAG外挂知识库确保事实准确性,并建立完善的监控与反馈机制持续优化。
AI大模型架构详解中,未来架构会取代Transformer吗?
短期内Transformer仍占主导,因其生态成熟、工具链完善,长期看,MoE将成为主流变体,状态空间模型在特定长序列任务中补充,架构演进是渐进式融合,而非彻底取代,多架构共存将是常态。
大模型架构是工程与科学的结合,理解其分层逻辑,方能驾驭智能浪潮。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/373762.html