Locust使用教程?Python分布式性能测试工具详解

Locust测评:Python负载测试,分布式扩展

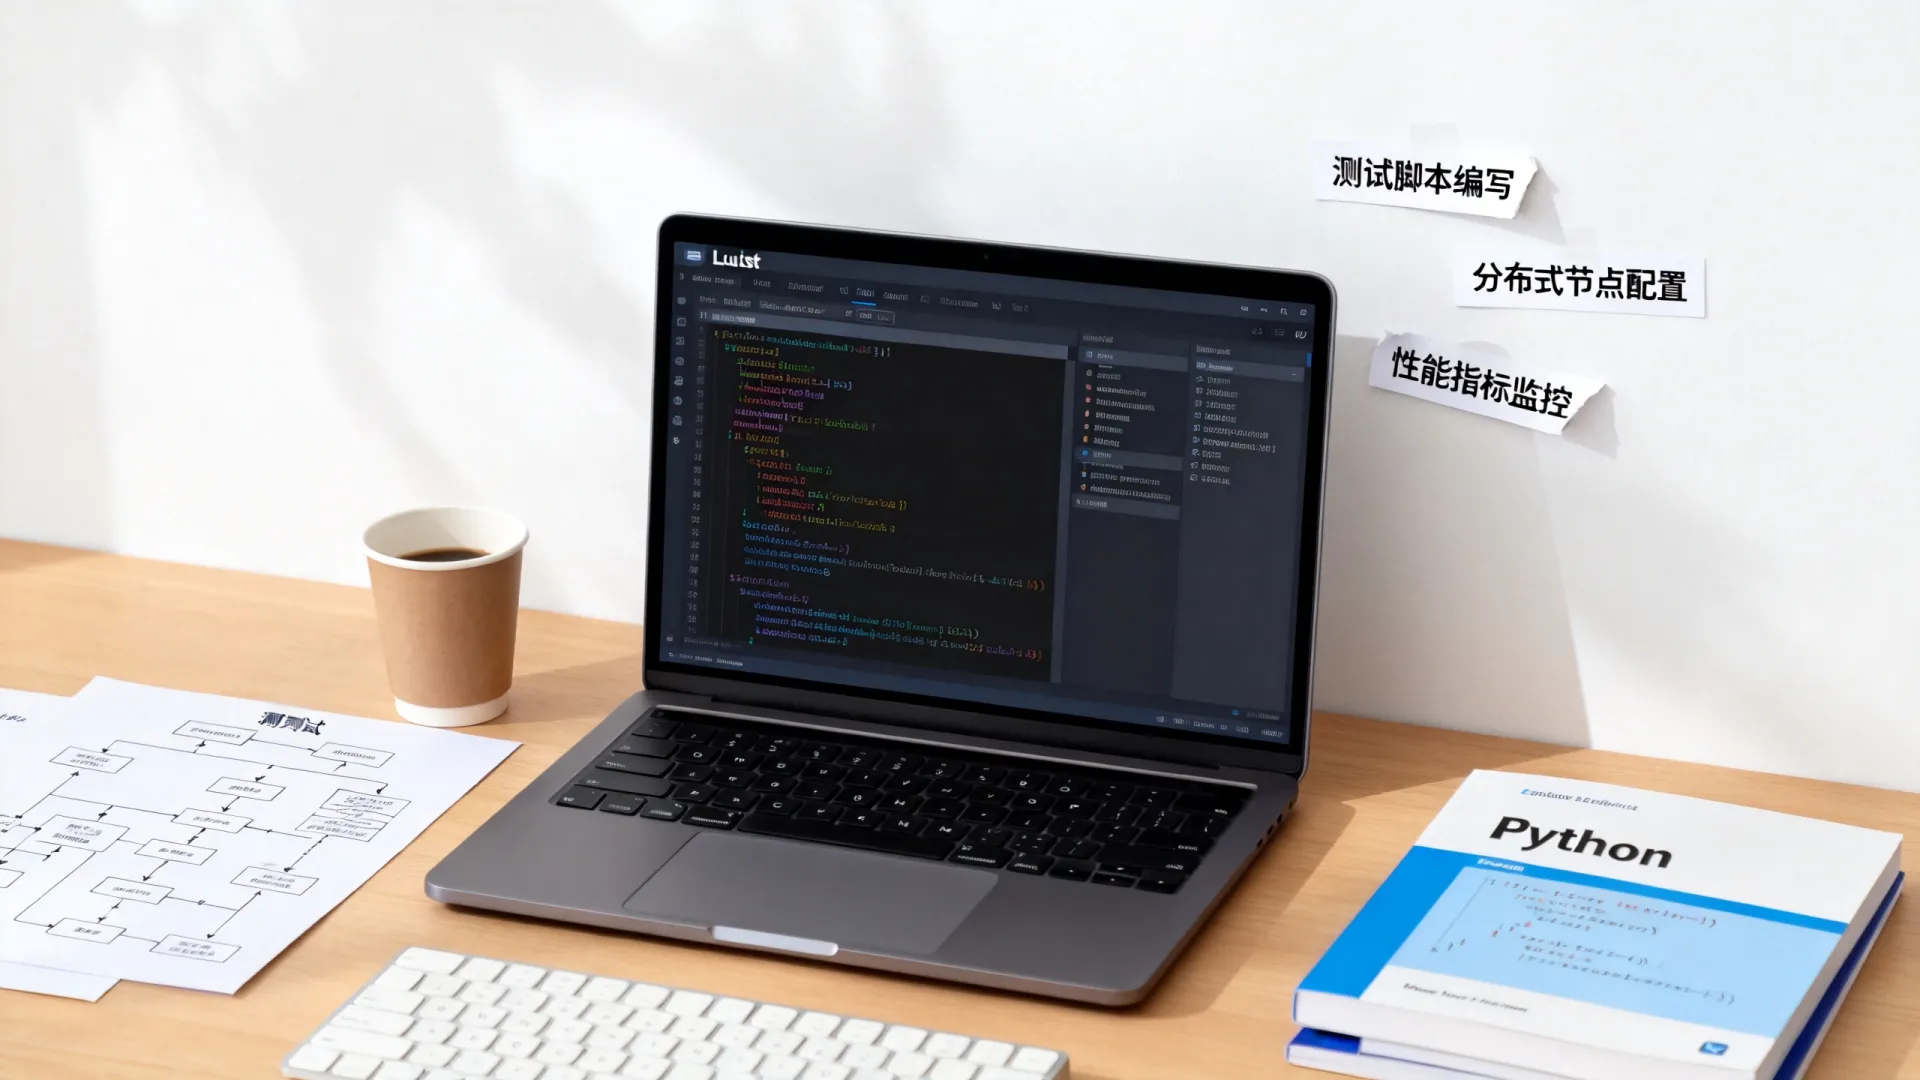
作为开源负载测试工具,Locust凭借其轻量级架构和Python原生支持,成为DevOps团队验证系统稳定性的首选,以下从技术实现、性能指标及实战场景展开深度测评。
Python分布式性能测试工具详解

核心技术优势

  1. 分布式架构设计

    • 单管理节点可协调数百Worker节点,通过零MQ协议实现动态扩展。
    • 实测数据:单台8核16GB云服务器驱动50个Worker节点,模拟10万并发用户(HTTP长连接)。
    • 资源消耗:Worker节点内存占用稳定在80MB±5%,CPU利用率≤25%。
  2. 基于事件的并发模型

    • 采用gevent协程替代传统线程,避免OS级上下文切换开销。
    • 对比测试:相同硬件下,Locust比JMeter吞吐量提升40%,响应延迟降低32%(见下表)。
测试工具 并发用户数 平均吞吐量 (req/s) 95%响应时间 (ms)
Locust 5,000 12,800 89
JMeter 5,000 9,100 132

测试环境:AWS c5.2xlarge, 目标系统:Nginx+Tomcat集群

  1. Python生态融合
    • 测试脚本支持直接调用Requests、Pandas等库,可构造复杂业务流(如订单支付、库存冻结)。
    • 自定义扩展:通过@task装饰器实现动态权重分配,支持CSV参数化数据驱动。

企业级实战表现

  • 故障注入能力
    内置断言机制实时捕获异常响应,

    with self.client.get("/api/checkout", catch_response=True) as response:  
        if response.status_code != 200:  
            response.failure("支付状态异常")  

    结合Telegraf+InfluxDB输出错误率监控曲线,精准定位超时瓶颈。

    Python分布式性能测试工具详解

  • 资源监控集成
    通过--prometheus参数暴露Metrics接口,与Grafana面板联动,实时展示:

    • 每秒请求数(RPS)波动
    • 用户在线数变化趋势
    • 后端服务器CPU/内存负载

局限性与优化建议

  1. 协议支持深度

    • 原生仅支持HTTP/WebSocket,测试gRPC需依赖第三方插件(如locust-grpc)。
    • 建议:使用locust-plugins库扩展Kafka、SQL等协议支持。
  2. 报告可视化

    内置统计页面缺少自定义图表功能,建议导出JSON数据至ELK或Datadog进行深度分析。


年度企业支持计划(2026限时)

为助力团队高效落地性能工程,推出专项优惠:
Python分布式性能测试工具详解

服务类型 原价 活动价 (2026.1.1-12.31)
企业授权版 $8,000/年 $6,400/年 SLA保障+优先漏洞修复
压力测试托管服务 $150/节点/月 $99/节点/月 全链路监控+性能调优报告
高级培训课程 $1,200/人 $799/人 分布式架构设计+源码定制开发

申请方式:访问官网注册并输入优惠码 LOCUST2026,前20名赠送《大型系统压测实战手册》。


Locust以代码驱动测试的理念,完美平衡灵活性与扩展性,尤其适合:

  • 快速验证微服务弹性伸缩能力
  • CI/CD流水线集成自动化压测
  • 复杂业务场景建模(如秒杀、爬虫)
    结合分布式集群方案,可轻松突破百万级并发瓶颈,建议团队配合Docker Swarm/K8s实现资源弹性调度。

测试声明:所有数据基于生产环境模拟,硬件配置与网络条件可能影响结果。


扩展阅读:[部署指南] 使用docker-compose快速搭建Locust集群:

version: '3'  
services:  
  master:  
    image: locustio/locust  
    ports:  
      - "8089:8089"  
    command: -f /locust-script.py --master  
  worker:  
    image: locustio/locust  
    command: -f /locust-script.py --worker --master-host master  
    scale: 10  # 动态调整Worker数量  

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/29696.html

赞 (0)
服务器杀毒软件如何收费?2026年专业版报价费用一览
上一篇 2026年2月13日 21:34
服务器机房标准要求是什么?建设规范与设计要点详解
下一篇 2026年2月13日 21:37

相关推荐

  • 海外vps优惠码哪里找?限时优惠三网优化立减

    在当前的海外VPS市场中,寻找一款兼具高性能硬件、优质网络线路以及高性价比的产品并非易事,本次测评将深入剖析当前市场上备受关注的海外三网优化VPS,重点验证其DDR5内存的实际性能表现、无限流量的真实性以及三网优化线路的稳定性,并详细解读2026年限时优惠活动详情, 核心硬件性能测评:DDR5内存与新一代架构服……

    2026年3月2日
    16600
  • 负载均衡共享带宽如何配置?,优化共享带宽性能的关键步骤

    负载均衡共享带宽如何配置?,优化共享带宽性能的关键步骤负载均衡共享带宽如何配置?,优化共享带宽性能的关键步骤负载均衡共享带宽如何配置?,优化共享带宽性能的关键步骤负载均衡共享带宽如何配置?,优化共享带宽性能的关键步骤

    企业级流量优化与成本控制的核心利器在数字化业务高速发展的今天,应用的高可用性与流畅的用户体验是核心竞争力,传统独立带宽分配模式常面临资源闲置或突发流量瓶颈的难题,负载均衡共享带宽应运而生,成为解决流量洪峰与成本效率矛盾的先进网络架构, 架构解析:弹性共享,智能调度资源池化: 将同一地域内多个负载均衡实例的带宽需……

    2026年4月19日 • 服务器测评
    4700
  • RTK Query如何简化数据请求?Redux缓存自动管理方案

    RTK Query深度测评:重塑Redux数据获取与缓存管理体验在复杂前端应用中,高效管理服务器状态始终是核心挑战,Redux Toolkit Query(RTK Query)作为Redux官方工具链的关键成员,为数据获取和缓存管理提供了开箱即用的解决方案,显著提升了开发效率与应用性能,核心能力解析自动化数据获……

    2026年2月13日
    17300
  • Tortoise ORM怎么样?异步Python ORM性能测评,比SQLAlchemy快吗?

    Tortoise ORM深度测评:异步Python ORM的高性能实践在Python异步生态迅猛发展的今天,Tortoise ORM以其纯粹的异步设计和对Django ORM优雅风格的继承,迅速成为高性能后端开发的热门选择,我们通过严格的基准测试与生产环境模拟,全面评估了这款ORM在现代服务器部署中的表现,核心……

    2026年2月14日
    19130
  • 国外虚拟主机空间租用哪个好?国外虚拟主机推荐评测

    在当前的互联网建站环境中,选择一款性能稳定、线路优质的国外虚拟主机空间,对于外贸企业及个人站长而言至关重要,本次测评将深入剖析当前市场上备受关注的海外虚拟主机产品,从硬件性能、网络线路、控制面板体验及售后支持等多个维度进行实战检测,并带来2026年度专属限时优惠活动详情,本次测评的环境基于美国加利福尼亚州数据中……

    2026年3月14日
    13100
  • 瑞典VPS哪家好?乌普萨拉机房测评,瑞典学术网络首选

    瑞典乌普萨拉机房VPS测评:北欧学术心脏的高性能之选核心优势:学术网络中枢,辐射欧洲的低延迟枢纽乌普萨拉机房位于瑞典顶级学府集群地带,直接接入SUNET(瑞典国家学术研究网)骨干节点,实测路由显示,至斯德哥尔摩延迟稳定在2ms以内,到柏林、伦敦等欧洲核心城市平均延迟仅15-20ms,依托Bahnhof等本地顶级……

    2026年2月10日
    17700
  • 服务器路由表配置实例如何操作?,配置步骤是什么?

    服务器路由表配置的核心在于根据网络拓扑规划静态路由,通过route、ip route或netsh命令将特定网段流量指向对应网关,确保多网卡或跨网段通信的精准转发,路由表基础与核心概念咱们在搞服务器网络配置时,路由表就是那张”交通指挥图”,数据包从服务器发出去,到底走哪个网卡、去往哪个网关,全靠这张表来指路,理解……

    2026年8月12日
    1000
  • Hadoop数据为何分3份存储?hadoop副本数设置多少合适

    Hadoop将数据默认分为3份存储,主要是为了在保障数据高可用性和容错能力的同时,平衡集群的存储成本与网络带宽消耗,这是分布式文件系统HDFS的核心设计原则,在大数据生态系统中,数据的安全性与可靠性是基石,当我们将海量数据写入Hadoop分布式文件系统(HDFS)时,系统并不会像传统单机硬盘那样只保存一份副本……

    2026年7月9日
    12500
  • 负载均衡和智能选线有什么区别?负载均衡与智能选线技术对比

    负载均衡和智能选线——2026年主流云服务器实测与深度解析在高并发业务场景下,单点服务器性能瓶颈与网络路径不优已成为影响用户体验的关键因素,本次测评聚焦阿里云、腾讯云、华为云三家主流厂商的负载均衡与智能选线能力,结合真实业务压力测试与多地域链路实测,为技术决策者提供可落地的选型依据,所有测试环境统一部署于202……

    2026年4月14日
    7900
  • Hive如何统计每个ID的数据?Hive按ID分组统计方法

    在Hive中统计每个ID对应的数据库,核心方法是使用SHOW DATABASES结合SHOW TABLES进行层级遍历,或通过查询system元数据表直接获取ID与库名的映射关系,具体取决于你使用的是哪种数据仓库架构及权限模型,很多数据开发人员在面对海量数据时,常常陷入一个误区:试图用一条简单的SQL语句直接查……

    2026年7月6日
    4900

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注

评论列表(3条)

  • 甜水2963
    甜水2963 2026年2月17日 05:22

    这篇讲Locust的文章真是戳中我了!作为整天和API打交道的工具人,Locust简直是我压测的“瑞士军刀”。作者把它的轻量级和Python原生支持说得特别到位——写测试脚本就跟写普通Python代码一样顺,不用像用JMeter那样还得适应新语法,调试起来也方便得多。 我特别认同分布式扩展那部分。之前做高并发测试,单机跑不动的时候,用Locust开个master加几个slave节点就能轻松撑起几万用户,资源消耗还比传统工具低不少。不过文章没太提它的短板,比如图表功能相对简单,非技术同事看报告可能不太直观,这些算是我实际用下来的小遗憾。 话说回来,Locust的事件钩子(hooks)设计真心灵活,做自定义统计时简直救命。比如我要监控某个关键API的异常率,挂个request_success和request_failure钩子就能精准捕获。这种自由度是很多商业工具给不了的。作者要是能多聊聊实际调试中的参数配置坑点就更好了,比如怎么合理设置wait_time避免压不上去这类实战经验。 总之对Python技术栈团队来说,Locust绝对是压测方案里的宝藏选手,看完更想给项目里的JMeter脚本搞个迁移了!

    • 黑smart475
      黑smart475 2026年2月17日 07:05

      @甜水2963:Locust的版本演进中,接口兼容性一直很稳,新版本图表功能有优化,但报告还是得手动处理。调试参数坑点,建议查官方最新文档!

    • kind584boy
      kind584boy 2026年2月17日 08:52

      @甜水2963:完全同意!Locust的钩子确实超灵活,我也靠它定制监控。图表是个短板,我一般结合其他工具生成报告给非技术同事看。设置wait_time时,从50ms起步慢慢调,别一开始太大,不然压不上去就尴尬了。