在Hive中统计每个ID对应的数据库,核心方法是使用SHOW DATABASES结合SHOW TABLES进行层级遍历,或通过查询system元数据表直接获取ID与库名的映射关系,具体取决于你使用的是哪种数据仓库架构及权限模型。
很多数据开发人员在面对海量数据时,常常陷入一个误区:试图用一条简单的SQL语句直接查出“哪个ID属于哪个库”,Hive本身是一个基于Hadoop的数据仓库工具,它的元数据(Metadata)存储在关系型数据库(如MySQL)中,而不是直接在HDFS文件里,统计ID与数据库的关系,本质上是在查询元数据或者解析日志。
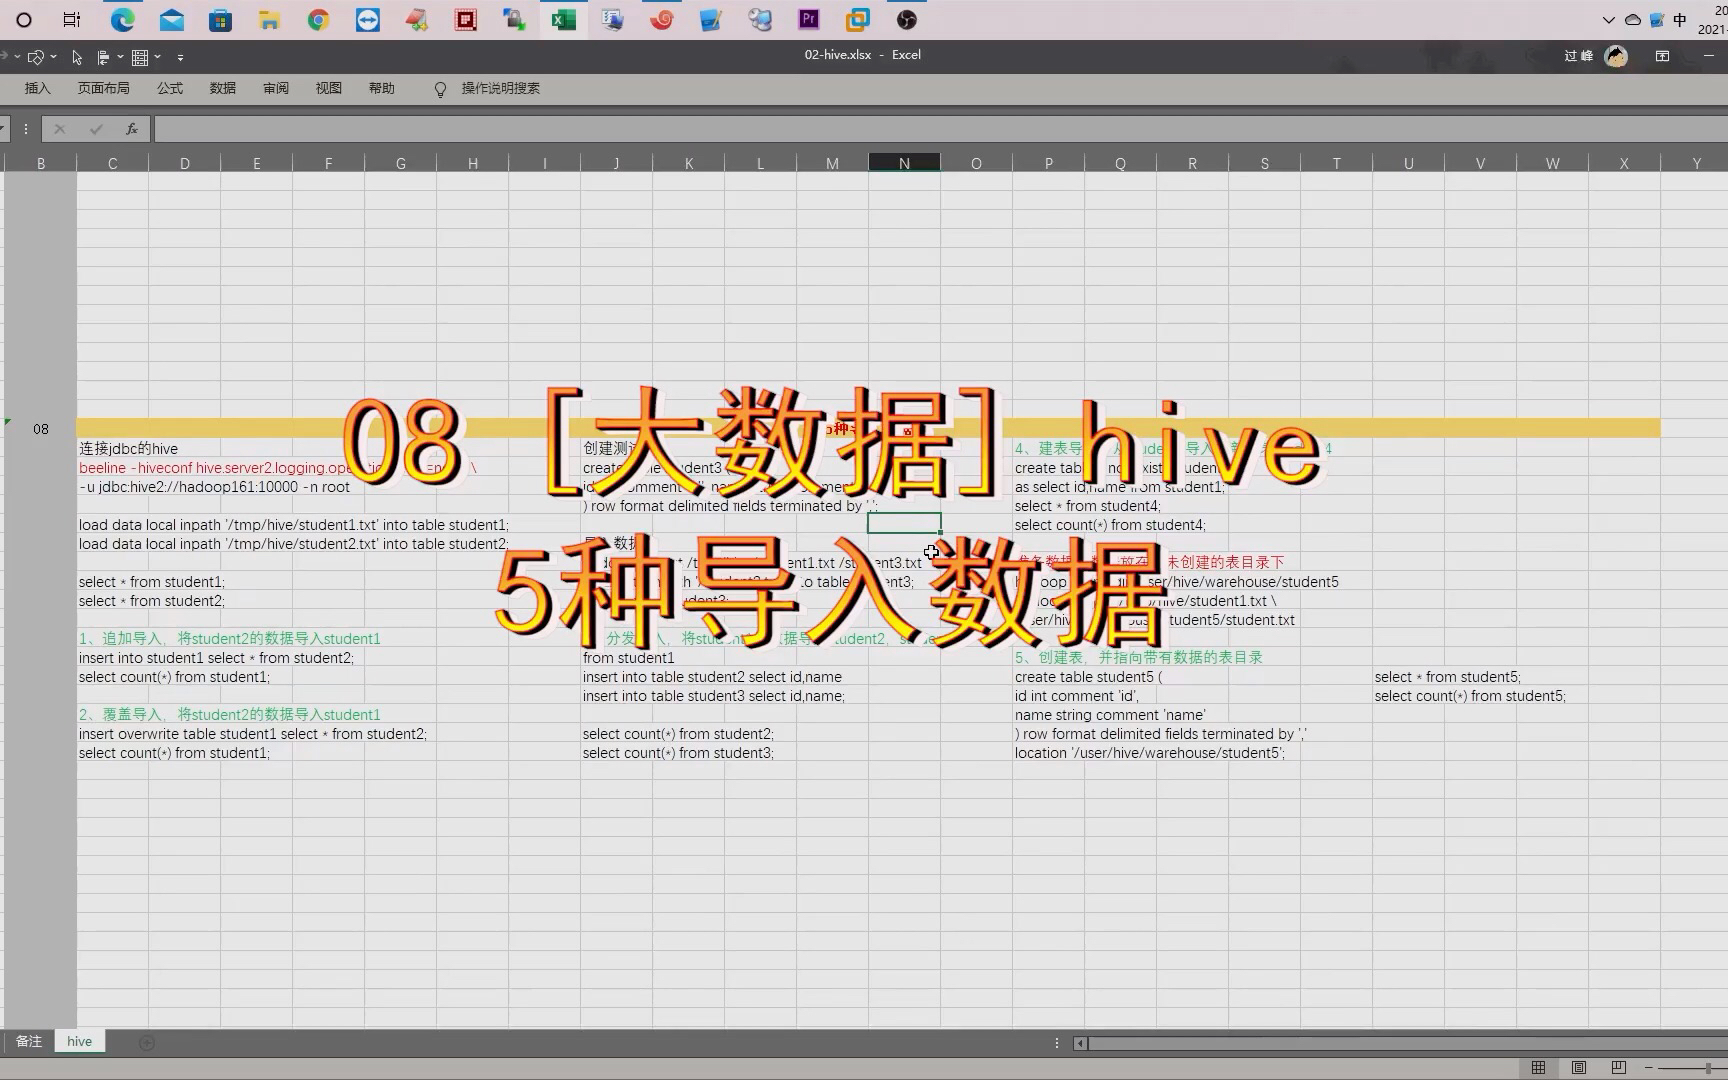
Hive元数据查询实战路径
要精准定位ID归属,首先需要理解Hive的存储结构,Hive的元数据通常保存在RDBMS中,最常见的后端存储是MySQL,业内专家指出,直接操作元数据表虽然高效,但存在风险,因此官方更推荐通过Hive CLI或Beeline接口进行查询。
利用系统视图获取库表映射
对于大多数标准Hive集群,我们可以通过查询系统内置的视图来获取数据库和表的信息,这种方法无需接触底层数据库,安全性高,且符合Hive的最佳实践。
- 查询所有数据库列表:使用
SHOW DATABASES;命令可以列出当前用户有权限访问的所有数据库。 - 查询特定库下的表:切换到目标库后,使用
SHOW TABLES;查看该库下的所有表。 - 关联查询技巧:虽然Hive没有直接的
JOIN元数据表的语法,但可以通过脚本自动化实现,编写一个Shell脚本,循环执行SHOW DATABASES,然后在每个库中执行SHOW TABLES,将结果输出到CSV文件中,最后通过Spark或Python进行ID匹配。
直接查询元数据表的进阶方案
如果你拥有MySQL的访问权限,并且希望一次性获取所有ID与库名的映射,直接查询Hive元数据表是最高效的方式,这是许多资深数据工程师在处理大规模元数据治理时的首选方案。
- 定位元数据表:在MySQL中,找到Hive配置中指定的数据库,通常名为
metastore或hive。 - 关键表解析:
DBS表:存储数据库的基本信息,包括DB_ID和NAME。TBLS表:存储表的信息,包括
TBL_ID
DB_ID和TBL_NAME。SDS表:存储存储描述,关联表与底层HDFS路径。
- SQL示例:
SELECT d.NAME AS database_name, t.TBL_NAME AS table_name, t.TBL_ID AS table_idFROM DBS dJOIN TBLS t ON d.DB_ID = t.DB_IDWHERE d.NAME NOT LIKE 'tmp%'; -- 排除临时库
这段代码能直接返回数据库名与表ID的对应关系,如果你的“ID”指的是业务主键而非Hive内部ID,则需要进一步关联业务表数据,这超出了元数据查询的范畴。
不同场景下的ID统计策略
在实际工作中,“ID”的定义千差万别,是Hive内部的表ID?是用户ID?还是分区ID?不同的场景需要不同的统计逻辑,行业共识认为,明确业务场景是选择技术方案的前提。
统计每个数据库下的数据量(ID作为表计数)
当我们需要评估每个数据库的负载情况时,通常统计的是库下的表数量或分区数量。
- 操作步骤:
- 登录Hive CLI。
- 执行
SHOW DATABASES;获取库列表。 - 对每个库执行
SHOW TABLES;并计数。 - 使用
DESCRIBE FORMATTED table_name;获取分区信息,统计分区ID数量。
- 优化建议:对于拥有数百个库的大型集群,手动操作不现实,建议使用Hive Metastore的REST API或编写Python脚本调用JDBC连接元数据数据库,批量获取
DBS和TBLS表数据,并在内存中进行聚合统计。
统计每个用户ID对应的数据访问库
在数据权限管理中,经常需要知道某个用户ID访问了哪些数据库,这通常涉及Hive的权限模块(如Ranger或Sentry)。
- 权限表关联:如果启用了Apache Ranger,需要查询Ranger的元数据库,而非Hive Metastore,Ranger将用户、策略和资源(数据库/表)进行关联。
- 查询路径:
- 确定Ranger后端存储(通常是PostgreSQL或MySQL)。
- 查询
x_policy表获取策略ID。 - 查询
x_service表获取服务名称(对应Hive数据库)。 - 查询
x_user或x_group表关联用户ID。
- 注意:不同版本的Ranger表结构差异较大,建议查阅对应版本的官方文档,避免直接套用旧版SQL。
统计分区ID与数据库的关系
在数据治理中,分区(Partition)是重要的管理单元,每个分区都有唯一的分区ID。
- 元数据表:
PARTITIONS表存储了分区信息,包括PART_ID、DB_ID、TBL_ID和PART_NAME。 - 统计SQL:
SELECT
    d.NAME AS database_name,
    p.PART_ID,
    p.PART_NAME
FROM
    PARTITIONS p
JOIN
    TBLS t ON p.TBL_ID = t.TBL_ID
JOIN
    DBS d ON t.DB_ID = d.DB_ID;
此查询可精确列出每个分区ID所属的数据库,这对于清理过期分区或优化存储成本至关重要。
常见误区与性能优化
在处理大规模元数据时,初学者容易陷入性能陷阱,以下是一些常见的错误做法及优化建议。
避免全表扫描元数据
直接SELECT FROM TBLS在表数量超过十万级时会导致元数据数据库负载飙升,甚至引发Hive服务不可用。
- 解决方案:
- 增加索引:确保元数据数据库中的
DB_ID和TBL_ID字段有适当索引。 - 分页查询:在应用层实现分页逻辑,避免一次性加载所有数据。
- 缓存机制:对于不频繁变化的元数据,建议在应用层引入Redis缓存,减少数据库查询压力。
- 增加索引:确保元数据数据库中的
权限隔离导致的查询失败
很多用户发现无法查询某些数据库的元数据,这是因为Hive的权限控制机制。
- 原因分析:Hive默认使用
DefaultAuthorizer,即所有用户可见所有库,但如果启用了RangerAuthorizer或SentryAuthorizer,用户只能看到其有权限的数据库。 - 解决路径:
- 确认当前使用的权限插件。
- 联系管理员申请相应库的
SELECT权限。 - 在查询前使用
USE database_name;切换上下文,确保查询在正确的权限范围内执行。
自动化监控与日常维护
将ID与数据库的统计工作自动化,是数据平台成熟度的重要标志。
构建元数据监控看板
- 数据抽取:编写定时任务(如Airflow DAG),每天凌晨抽取Hive元数据快照。
- 数据存储:将抽取的数据存入ClickHouse或Elasticsearch,便于快速聚合查询。
- 可视化展示:使用Grafana或Superset展示每个数据库的表数量、分区数量、增长趋势等指标。
- 告警机制:当某个数据库的表数量异常增长或分区数超过阈值时,自动发送告警通知。
定期清理无效元数据
随着时间推移,元数据中会积累大量已删除表或库的残留信息。
- 清理策略:
- 软删除:在Hive中删除表时,确保
DROP TABLE命令成功执行,元数据会自动更新。 - 硬清理:对于因异常中断而未清理的元数据,需手动在MySQL中删除
TBLS和SDS表中的对应记录。 - 验证:清理后,重启Hive Metastore服务或刷新缓存,确保元数据一致性。
- 软删除:在Hive中删除表时,确保
Q&A:关于Hive ID统计的常见问题
Hive中如何快速找到某个业务ID所属的数据库?
如果业务ID是表名的一部分或字段名,无法直接通过元数据表关联,建议先通过业务系统文档或数据字典查找该ID对应的表名,然后使用SHOW DATABASES遍历或查询TBLS表,通过TBL_NAME字段匹配找到所属的DB_ID,再关联DBS表获取数据库名,若表名不固定,需结合Hive日志或数据血缘工具进行反向追踪。
使用MySQL直接查询Hive元数据会影响Hive性能吗?
在正常查询频率下,直接查询MySQL元数据表对Hive性能影响极小,因为Hive Metastore服务本身就会频繁读取这些表,如果执行全表扫描或复杂的多表JOIN查询,尤其是在表数量巨大的情况下,会显著增加MySQL的CPU和IO负载,进而导致Hive Metastore响应变慢,甚至超时,建议仅在必要时进行小范围查询,或采用分页、索引优化等手段。
Hive元数据中的ID与HDFS文件ID有什么关系?
Hive元数据中的ID(如TBL_ID、DB_ID)是Hive内部用于管理元数据的逻辑标识符,与HDFS的文件ID(Block ID或File Inode ID)没有直接对应关系,HDFS文件ID由NameNode分配,用于标识物理文件;而Hive ID用于标识逻辑表或库,两者通过SDS表中的LOCATION字段间接关联,该字段存储了表数据在HDFS上的路径。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/461961.html