构建图像搜索的核心在于建立“视觉指纹”与“语义标签”的双向索引,通过深度学习模型将图片像素转化为可检索的结构化数据,从而实现毫秒级的精准匹配。
爆炸的今天,单纯依靠文件名或简单的元数据进行图片管理已无法满足需求,无论是电商平台的商品展示,还是媒体机构的素材库管理,高效的图像搜索系统都是提升用户体验和运营效率的关键基础设施。
图像搜索的技术架构与核心原理
图像搜索并非简单的关键词匹配,而是一个涉及计算机视觉、自然语言处理和大数据检索的复杂系统工程,其核心逻辑是将非结构化的图像数据转化为机器可理解的特征向量,并在高维空间中建立索引。
从像素到特征向量的转化过程
这一过程通常被称为“图像嵌入”(Image Embedding),传统方法依赖人工设计的特征提取器,如SIFT或HOG,但现代系统普遍采用基于深度卷积神经网络(CNN)的预训练模型,如ResNet或EfficientNet。
- 特征提取:模型读取图像像素,通过多层卷积层捕捉边缘、纹理、形状等低级特征,进而组合成物体、场景等高级语义特征。
- 降维与向量化:提取的高维特征经过全连接层映射到一个固定长度的低维向量空间,在这个空间中,语义相似的图像在向量距离上更为接近。
- 归一化处理:对向量进行L2归一化,确保后续计算余弦相似度时更加稳定高效。
业内专家指出,特征提取的质量直接决定了搜索的准确率,因此选择经过大规模数据集(如ImageNet)预训练的模型是基础中的基础。
多模态融合:视觉与语义的协同
仅靠视觉特征往往难以解决“语义鸿沟”问题,即机器看到的像素与人类理解的语义之间的差距,两张风格不同但内容相同的图片,像素差异巨大,但语义一致。
CLIP模型的应用
当前主流的解决方案是引入多模态预训练模型,如OpenAI提出的CLIP(Contrastive Language-Image Pre-training),该模型同时训练图像编码器和文本编码器,使它们在同一个向量空间中对齐。
- 图文对齐:通过对比学习,让描述同一内容的文本嵌入和图像嵌入在空间中距离最小化。
- 零样本能力:无需针对特定任务重新训练,即可实现通用的图像分类和检索,极大地降低了部署成本。
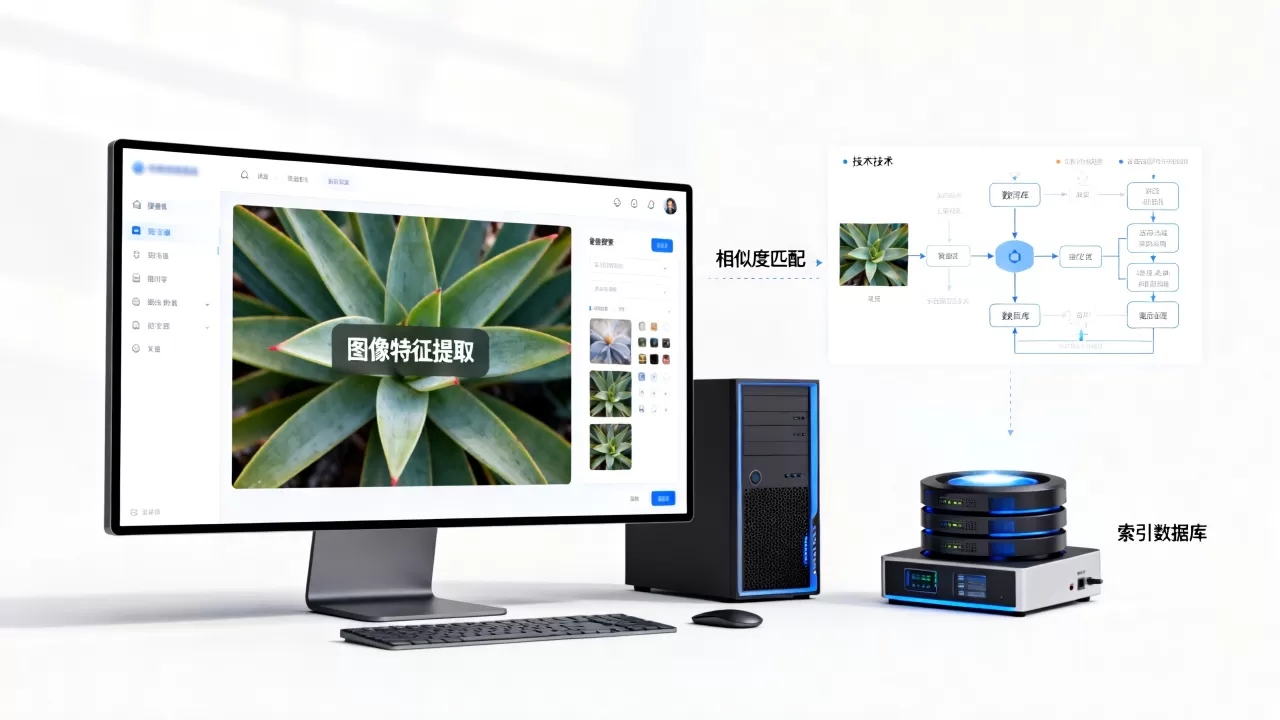
这种技术使得用户可以使用自然语言描述(如“穿红裙子的女孩在雨中”)来搜索图片,而不仅仅是上传参考图。
构建高效图像搜索系统的实操步骤
构建一个可用的图像搜索系统,需要经历数据准备、模型选型、索引构建和检索优化四个关键阶段,每个环节都直接影响最终的性能和成本。
数据预处理与清洗
数据质量是决定搜索效果的上限,脏数据会导致模型学习到错误的模式,产生大量误报。
- 去重与过滤:利用感知哈希(pHash)或SimHash算法快速识别并去除高度相似的重复图片,减少存储冗余。
- 分辨率标准化:将所有输入图像统一缩放至模型要求的尺寸(如224×224或384×384),并填充空白区域,确保输入一致性。
- 标签增强:对于已有标签的数据,利用OCR技术提取图片中的文字信息,结合NLP技术生成更丰富的描述性标签,补充视觉特征的不足。
向量数据库的选择与部署
当图像被转化为向量后,如何快速在高维空间中查找最近邻(Nearest Neighbor, NN)是技术难点,传统的数据库无法应对亿级向量的实时检索需求。
主流向量数据库对比
| 数据库类型 | 代表产品 | 适用场景 | 优势 | 劣势 |
|---|---|---|---|---|
| 专用向量库 | Milvus, Pinecone | 大规模工业级应用 | 支持分布式扩展,查询速度快 | 运维复杂,资源消耗大 |
| 嵌入式库 | FAISS, Annoy | 单机或小规模应用 | 部署简单,集成方便 | 扩展性有限,适合离线或中小规模 |
| 关系型扩展 | PostgreSQL (pgvector) | 已有SQL架构的系统 | 易于集成,事务支持好 | 超大规模下性能瓶颈明显 |
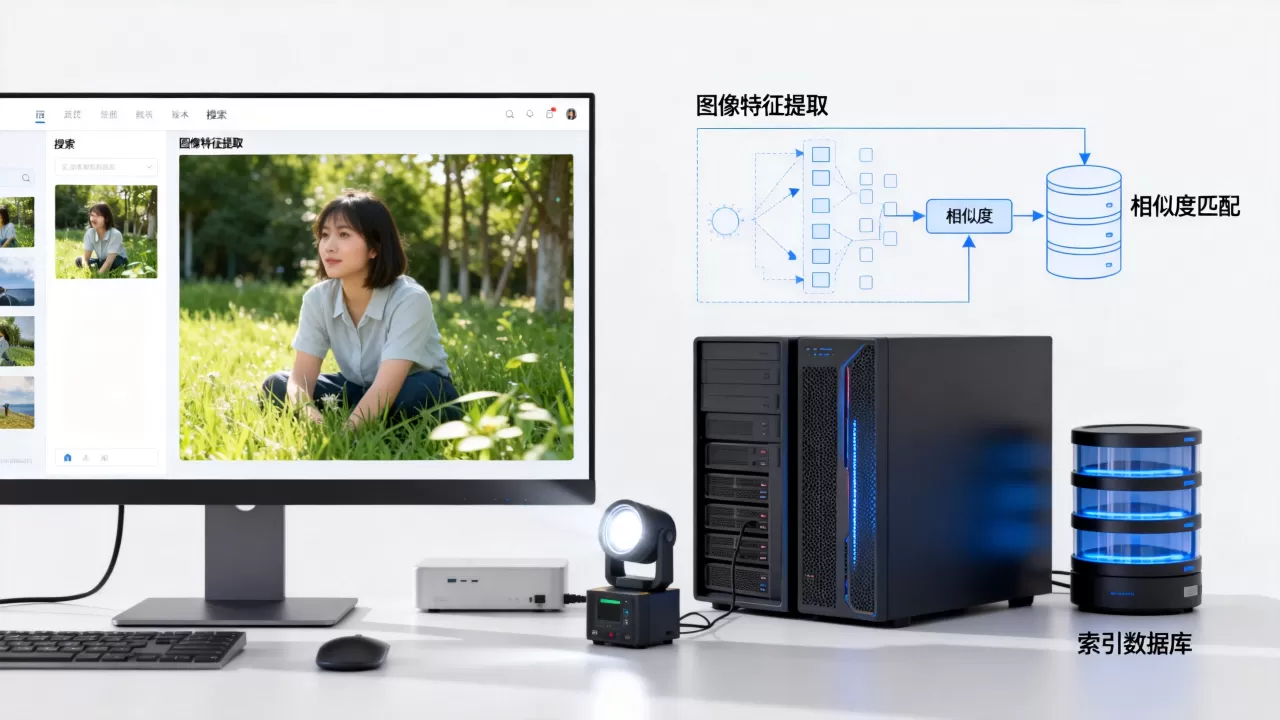
对于初创项目或中小规模应用,使用FAISS或pgvector足以满足需求;而对于日活千万级的电商平台,则建议采用Milvus或商业化的向量数据库服务,以保障高并发下的低延迟。
检索策略与排序优化
初步检索通常基于向量相似度(如余弦相似度)返回Top-K结果,但这往往不够精准,需要引入重排序(Re-ranking)机制。
- 粗排:使用向量检索快速筛选出候选集,例如从百万级数据中选出1000个最相似的图片。
- 精排:使用更复杂的交叉编码器(Cross-Encoder)模型,对候选集中的图片与查询进行细粒度的语义匹配打分,虽然计算成本高,但能显著提升相关度。
- 业务规则加权:结合图片的发布时间、点击率、作者权重等业务指标,对搜索结果进行最终排序。
常见痛点与解决方案
在实际落地过程中,开发者常遇到检索速度慢、长尾效果差、冷启动困难等问题。
如何解决检索延迟问题
随着数据量增长,向量检索的耗时呈线性甚至指数级增长,优化方向主要包括:
- 索引算法优化:使用HNSW(Hierarchical Navigable Small World)算法替代传统的IVF(Inverted File Index),在保持较高召回率的同时,大幅降低查询时间。
- 量化压缩:对向量进行标量量化(SQ)或乘积量化(PQ),将32位浮点数压缩为8位整数,减少内存占用并提升缓存命中率。
- 分布式并行查询:将向量数据分片存储在多个节点,查询时并行发起请求,最后合并结果。
长尾图片的检索难题
对于小众、罕见或无标签的图片,传统模型往往表现不佳。
- 小样本学习:引入Few-shot Learning技术,利用少量标注样本微调模型,使其适应特定领域的长尾分布。
- 生成式增强
:利用GAN或Diffusion模型生成增强数据,扩充长尾类别的训练样本,提升模型的泛化能力。
未来趋势:生成式AI与图像搜索的融合
随着AIGC技术的爆发,图像搜索正从“查找已有图片”向“生成并查找”演进。
以图生图的逆向搜索
用户不仅可以搜索相似图片,还可以基于参考图的风格、构图,生成全新的原创图片,搜索引擎需要具备理解生成指令的能力,将自然语言转化为生成模型的参数。
动态实时索引
社交媒体上的图片更新频率极高,传统的批量索引模式已无法满足需求,流式处理架构成为标配,新上传的图片需在秒级内完成特征提取并加入索引,确保搜索结果的新鲜度。
据工信部及相关行业数据显示,采用多模态大模型的图像搜索系统,其用户满意度较传统系统提升了显著比例,尤其在复杂场景下的识别准确率上优势明显。
构建图像搜索常见问题解答
构建图像搜索系统需要多少数据量才能见效?
模型效果与数据量呈正相关,但并非线性关系,对于通用场景,使用ImageNet等预训练模型即可直接应用,无需额外训练数据,对于垂直领域(如医疗影像、工业缺陷检测),建议至少准备数千至数万张标注图片进行微调,若数据量极少,可考虑使用迁移学习或零样本学习技术,但准确率会有所折损。
图像搜索的准确率如何衡量?
业界通常使用mAP(mean Average Precision,平均精度均值)和Recall@K(前K个结果中的召回率)作为核心指标,mAP综合考量了排序质量和召回率,是评估整体性能的最佳指标,在实际业务中,还需结合人工评估,关注“首屏命中率”,即用户在前几页结果中找到目标图片的概率。
如何平衡搜索速度与准确率?
这是一个典型的工程权衡问题,追求极致速度通常需牺牲部分准确率,例如使用低精度的向量索引或减少召回数量,建议采用两级检索架构:第一级使用快速但粗糙的索引(如HNSW)进行粗筛,第二级使用高精度模型进行重排,通过调整第一级的参数(如M值、efConstruction),可以在95%的召回率下将查询延迟控制在100毫秒以内,满足大多数实时交互需求。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/253552.html