MapReduce的核心价值在于将大规模分布式计算任务自动拆分为Map(映射)和Reduce(归约)两个阶段,通过并行处理实现海量数据的离线分析,是构建大数据底层架构的基石。
在2026年的今天,虽然流式计算和实时引擎如Flink、Spark Streaming占据了实时场景的半壁江山,但MapReduce依然是处理PB级历史数据、进行复杂离线ETL(抽取、转换、加载)任务时的“定海神针”,很多初学者容易混淆MapReduce与Spark的区别,MapReduce的设计哲学更偏向于“简单可靠”,它不依赖内存缓存,而是通过磁盘I/O来保证数据的持久性和容错性,对于预算有限、数据规模巨大且对实时性要求不高的场景,基于Hadoop生态的MapReduce方案依然具有极高的性价比和稳定性。

MapReduce工作原理与核心机制解析
理解MapReduce不能只停留在概念层面,必须深入其数据流转的每一个环节,业内专家指出,MapReduce之所以能处理海量数据,关键在于其“分而治之”的思想,它将一个巨大的计算任务分解成数千甚至数万个小的子任务,分发到集群中的不同节点并行执行。
Map阶段:数据的拆分与预处理
Map阶段是数据处理的第一站,在这个阶段,输入数据被切分成固定的大小(默认通常是128MB或256MB,具体取决于HDFS块大小),每个切片由一个Map任务负责。
- 输入格式解析:框架读取HDFS上的文件,按行或按记录格式解析数据。
- 键值对生成:Map函数接收输入键值对(如<offset, line>),经过业务逻辑处理后,输出新的键值对(如<word, 1>)。
- 分区与排序:输出的键值对会根据Key的哈希值被分配到不同的分区(Partition),并在本地进行排序,这一步至关重要,它决定了后续Reduce任务如何合并数据。
Shuffle阶段:数据的中转与重组
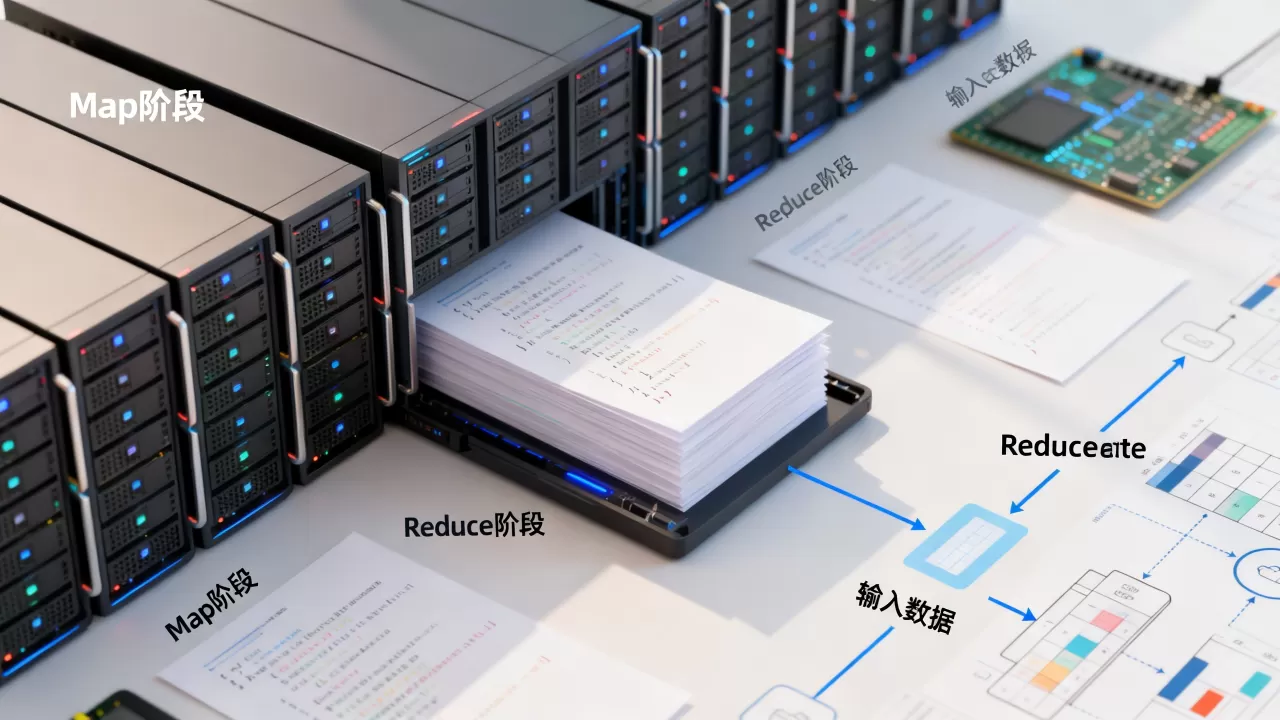
Shuffle是MapReduce中最复杂、最耗时的部分,也是性能优化的核心瓶颈所在,它连接了Map和Reduce两个阶段,负责将Map的输出传输到Reduce节点。
- 溢写(Spill):当Map任务的内存缓冲区达到阈值(默认100MB的80%)时,数据会被写入磁盘,形成临时文件。
- 合并(Merge):所有Map任务完成后,框架会对这些临时文件进行归并排序,确保相同Key的数据聚集在一起。
- 拉取(Fetch):Reduce任务从各个Map节点拉取属于自己的数据分区。
Reduce阶段:数据的聚合与输出
Reduce阶段接收来自Shuffle阶段的数据,进行最后的聚合操作。
- 合并输入:Reduce任务拉取所有Map输出的对应分区数据,并进行最终的合并排序。
- 业务逻辑处理:Reduce函数接收一个Key和该Key对应的所有Value列表,执行计数、求和、平均等聚合逻辑。
- 结果写入:最终结果写入HDFS,完成整个作业。
MapReduce与Spark对比:场景选择与性能差异
在实际工程选型中,MapReduce和Spark哪个更适合你的业务是一个高频问题,两者虽然都基于分布式计算模型,但在底层实现和适用场景上有显著差异。
| 维度 | MapReduce | Spark |
|---|---|---|
| 计算模型 | 基于磁盘的迭代计算 | 基于内存的DAG执行引擎 |
| 处理速度 | 较慢(大量磁盘I/O) | 快10-100倍(内存计算) |
| 容错机制 | 通过日志记录(WAL)恢复 | 通过血统线(Lineage)重算 |
| 适用场景 | 超大规模离线批处理、ETL | 交互式查询、实时流处理、机器学习 |
| 资源开销 | 较低(无需常驻内存) | 较高(需预留大量内存) |
对于MapReduce在离线数据分析中的应用,其优势在于稳定性极高,由于数据主要存储在磁盘上,即使节点故障,数据也不会丢失,且恢复成本可控,而在需要快速迭代、交互式查询的场景下,Spark的内存计算优势则无可替代。
实操指南:MapReduce开发与环境配置
对于想要上手MapReduce的开发者来说,搭建环境和编写第一个WordCount程序是必经之路,近年来,多数情况下企业倾向于使用云原生Hadoop服务,但本地搭建对于理解底层原理依然不可或缺。
环境搭建步骤
- 安装Java环境:确保JDK 8或JDK 11已安装,并配置JAVA_HOME环境变量。
- 配置Hadoop集群:下载Hadoop二进制包,修改
etc/hadoop/hadoop-env.sh中的Java路径,配置core-site.xml和hdfs-site.xml以指定NameNode和DataNode的地址。 - 格式化HDFS:执行
hdfs namenode -format命令初始化文件系统。 - 启动集群:运行
start-dfs.sh和start-yarn.sh启动HDFS和YARN资源调度器。
编写WordCount程序
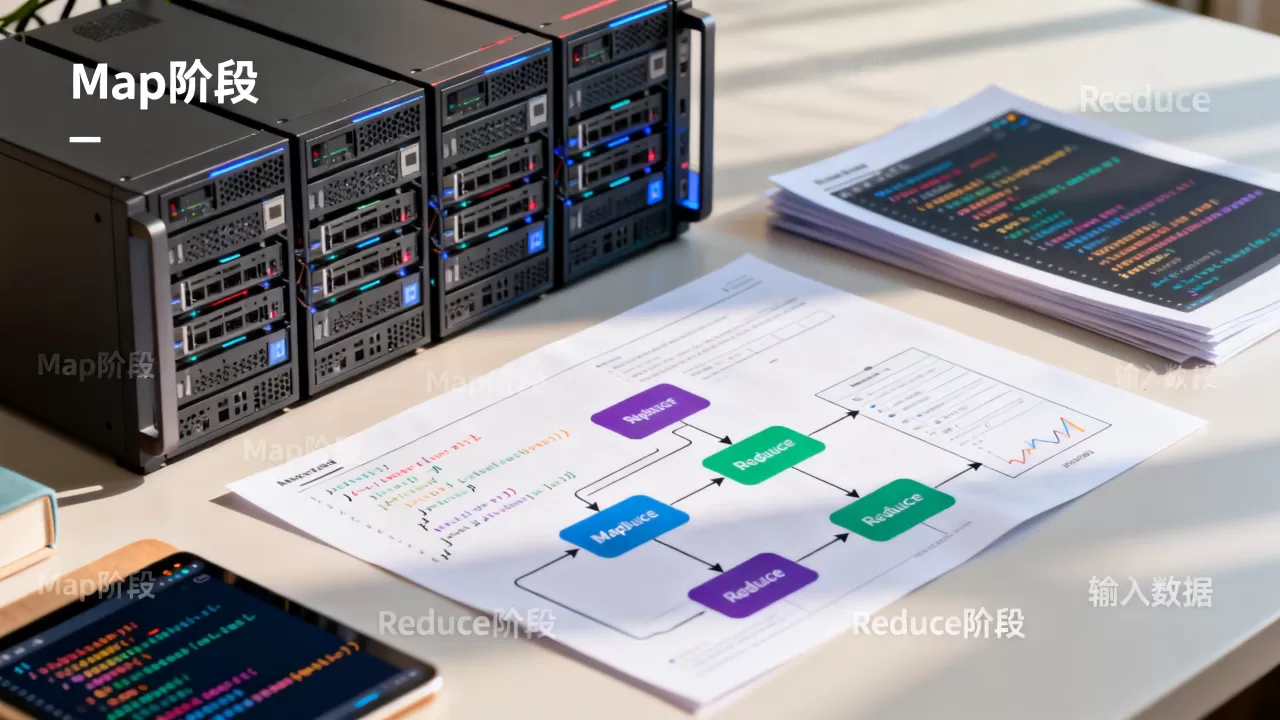
MapReduce程序通常由Mapper、Reducer和Driver三部分组成。
- Mapper类:继承
Mapper<LongWritable, Text, Text, IntWritable>,重写map方法,将每行文本拆分为单词,输出<word, 1>。 - Reducer类:继承
Reducer<Text, IntWritable, Text, IntWritable>,重写reduce方法,对相同Key的Value列表进行求和。 - Driver类:配置作业参数,指定Mapper、Reducer类,输入输出路径,并提交作业到YARN集群。
常见错误排查
- OutOfMemoryError:通常是因为Map或Reduce任务处理的数据量过大,导致内存溢出,可通过调整
mapreduce.map.memory.mb和mapreduce.reduce.memory.mb参数解决。 - DataNode节点丢失:检查防火墙是否关闭,SSH免密登录是否配置正确,以及时间同步是否准确。
性能优化策略与最佳实践
MapReduce的性能优化主要集中在减少I/O开销、提高并行度和平衡数据倾斜三个方面。
减少I/O开销
- 使用压缩格式:在Map输出和Reduce输出阶段使用Snappy或LZO压缩算法,可以显著减少磁盘I/O和网络传输量。
- Combine函数:在Map端引入Combine函数,先进行局部聚合,减少传输到Reduce端的数据量。
解决数据倾斜
数据倾斜是指某些Reduce任务处理的数据量远大于其他任务,导致整体作业等待慢节点完成。
- 加盐处理:在Key前添加随机前缀,将热点Key分散到多个Reduce任务中,最后再进行二次聚合。
- 自定义分区器:根据业务数据分布特征,自定义Partitioner,确保数据均匀分布。
调整并行度
- Map并行度:根据输入数据的大小和HDFS块大小,合理设置Map任务数,通常建议每个任务处理128MB-256MB数据。
- Reduce并行度:根据聚合后的数据量和集群资源,设置合适的Reduce任务数,避免任务过多导致调度开销过大。
MapReduce常见问题解答
MapReduce和Spark哪个更适合你的业务
如果业务场景是超大规模的离线日志分析、历史数据归档或复杂的ETL流程,且对实时性要求不高,MapReduce因其稳定性和低内存占用是更经济的选择,若业务需要交互式查询、实时流处理或机器学习迭代,Spark的内存计算优势则更为明显。
如何解决MapReduce中的数据倾斜问题
数据倾斜通常通过加盐(Salting)技术解决,即在Key中添加随机前缀,将热点数据分散到多个Reduce节点,还可以使用自定义分区器,根据数据分布特征手动控制数据分配,确保各节点负载均衡。
MapReduce在离线数据分析中的应用
MapReduce广泛应用于用户行为日志分析、搜索引擎索引构建、推荐系统离线特征工程等场景,在电商场景中,MapReduce可用于统计每日各商品的销售排行,或计算用户的历史购买偏好,为实时推荐系统提供基础数据支持。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/238324.html