个人搭建博客网站完全不需要购买昂贵的企业级数据库,利用开源的轻量级关系型数据库配合容器化技术,即可在低成本下实现高性能、易维护的云原生架构,满足绝大多数个人创作需求。
很多人一听到“云原生”和“分布式”就觉得高不可攀,仿佛必须拥有庞大的服务器集群和专业的运维团队,对于个人博客这种数据量相对较小、并发压力有限的场景,我们需要的不是真正的分布式集群,而是云原生架构思维与轻量级分布式数据库的结合,这种组合既能享受容器化带来的部署便利,又能通过简单的副本机制保证数据不丢失。
为什么选择轻量级关系型数据库
在开始动手之前,我们需要明确一个核心逻辑:博客的核心资产是文章、评论和用户数据,这些都属于典型的关系型数据,虽然NoSQL(如MongoDB)在灵活性上有优势,但对于结构化内容管理,关系型数据库依然是行业共识。
业内专家指出,对于日均访问量低于1万次的个人站点,传统MySQL或PostgreSQL配合简单的读写分离或主从复制,往往比复杂的分布式方案更具性价比,为了贴合“云原生”和“分布式”的主题,我们推荐采用基于Raft或Paxos共识算法的轻量级分布式数据库,这类数据库在单机或小规模集群下表现优异,且具备自动故障转移能力。
主流方案对比分析
在选择具体软件时,我们需要权衡性能、资源占用和维护难度,以下是几种常见方案的对比:
| 数据库类型 | 资源占用 | 部署难度 | 数据一致性 | 适用场景 |
|---|---|---|---|---|
| MySQL (单机) | 低 | 极低 | 强 | 极低流量博客,无需高可用 |
| PostgreSQL | 中 | 低 |
强 | 复杂查询需求,插件生态丰富 |
| TiDB (Serverless) | 高 | 中 | 强 | 需要水平扩展,但个人使用成本较高 |
| CockroachDB | 中 | 中 | 强 | 分布式需求,全球部署场景 |
| SQLite + WAL | 极低 | 极低 | 强 | 极致轻量,单节点高可靠 |
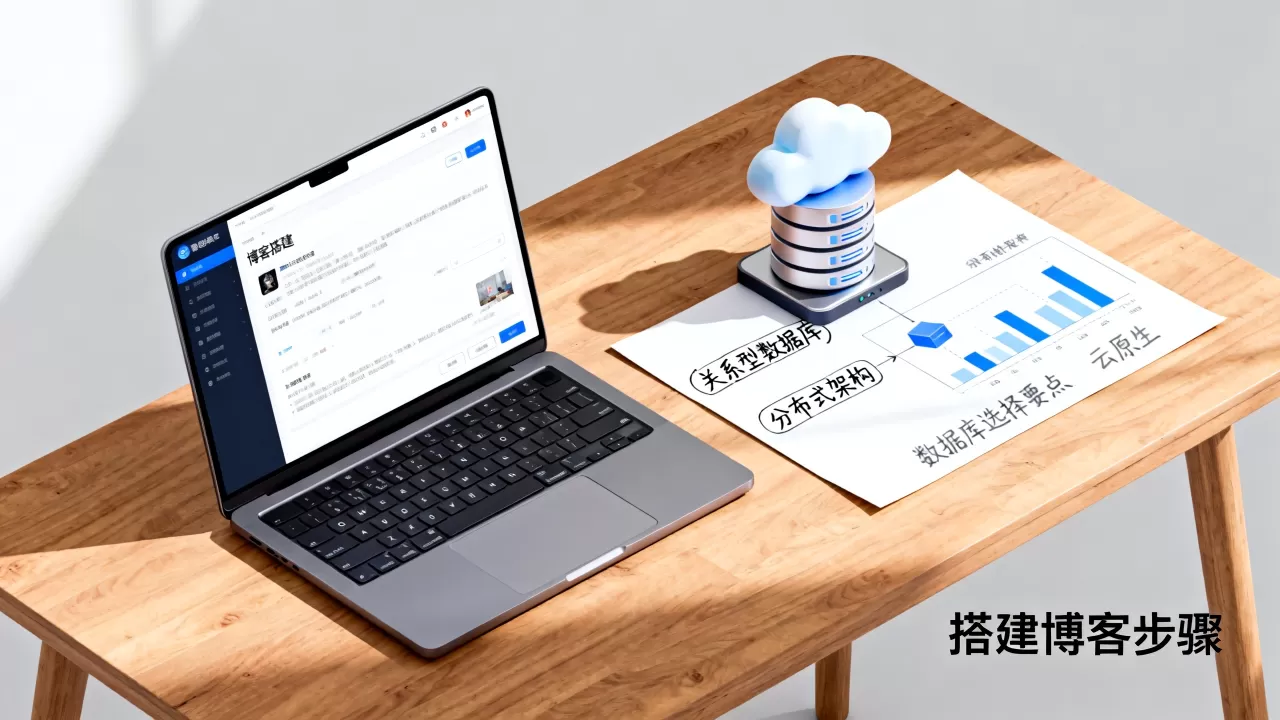
对于个人博客,CockroachDB 或 TiDB Serverless 虽然符合分布式定义,但配置复杂或费用不菲,更务实的选择是使用 PostgreSQL 配合 Docker Compose 搭建主从架构,或者使用专为云原生设计的 Vitess 底层方案,这里我们以PostgreSQL为例,因为它生态成熟,文档丰富,且通过容器化可以轻松实现“伪分布式”的高可用体验。
核心架构搭建步骤
搭建过程并非想象中那样需要编写复杂的代码,而是通过声明式配置文件来定义基础设施,我们将采用“基础设施即代码”(IaC)的理念,使用Docker Compose来编排数据库服务。
第一步:环境准备与镜像选择
确保你的服务器或本地开发环境安装了Docker和Docker Compose,这是云原生应用的基石,我们需要选择稳定的PostgreSQL版本镜像,建议锁定具体版本号以避免兼容性陷阱。
在终端中创建项目目录,并初始化配置文件,这一步至关重要,因为配置文件的结构直接决定了后续的可维护性。
第二步:编写Docker Compose配置
创建一个 docker-compose.yml 文件,这是整个架构的核心,我们需要定义两个服务:一个是主节点(Primary),一个是从节点(Replica)。
version: '3.8'
services:
  postgres-primary:
    image: postgres:16-alpine
    environment:
      POSTGRES_USER: blog_admin
      POSTGRES_PASSWORD: ${DB_PASSWORD}
      POSTGRES_DB: blog_db
    volumes:
      - pg_primary_data:/var/lib/postgresql/data
    ports:
      - "5432:5432"
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U blog_admin"]
      interval: 10s
      timeout: 5s
      retries: 5
  postgres-replica:
    image: postgres:16-alpine
    environment:
      POSTGRES_USER: blog_admin
      POSTGRES_PASSWORD: ${DB_PASSWORD}
      POSTGRES_DB: blog_db
    volumes:
      - pg_replica_data:/var/lib/postgresql/data
    depends_on:
      postgres-primary:
        condition: service_healthy
    # 注意:实际生产中需配置流复制,此处仅为架构示意
    ports:
      - "5433:5432"
通过这种方式,我们将数据库容器化,实现了环境的一致性,无论迁移到哪台服务器,只要运行 docker-compose up -d,即可快速恢复服务,这种个人博客数据库容器化部署的方式,极大地降低了运维门槛。
第三步:实现数据同步与高可用
单纯的容器部署并不等于分布式,为了实现数据的高可用性,我们需要配置流复制(Streaming Replication),在主节点上启用 wal_level = replica,并在从节点上配置 recovery.conf 或现代的 postgresql.auto.conf 来连接主节点。
当主节点发生故障时,我们可以手动或通过脚本将从节点提升为主节点,虽然这不如Kubernetes Operator那样自动化,但对于个人博客而言,这种半自动化的管理方式已经足够稳定,且资源消耗极低。
性能优化与安全加固
搭建好基础架构后,接下来是优化环节,个人博客虽然流量不大,但数据的安全性不容忽视。
连接池管理
数据库连接是宝贵的资源,在应用层,务必使用连接池(如PgBouncer)来管理数据库连接,直接让Web应用频繁创建和销毁数据库连接会导致性能急剧下降,配置PgBouncer作为代理层,可以有效复用连接,提升并发处理能力。
备份策略
数据丢失是灾难性的,我们需要制定自动化的备份策略,利用
pg_dump 工具,结合Crond定时任务,每天凌晨将数据库快照上传到对象存储(如AWS S3或阿里云OSS)。
#!/bin/bash
BACKUP_FILE="/backups/blog_db_$(date +%F).sql.gz"
pg_dump -h localhost -U blog_admin blog_db | gzip > $BACKUP_FILE
# 上传至对象存储的命令...
这种个人博客数据库自动备份方案,确保了即使服务器物理损坏,数据也能从云端恢复。
常见问题解答
个人博客需要分布式数据库吗
对于绝大多数个人博客,真正的分布式数据库并非必需,分布式数据库的核心价值在于水平扩展和跨地域容灾,个人博客的数据量通常在GB级别,单机数据库完全可以胜任,选择轻量级关系型数据库配合容器化主从架构,既能获得高可用性,又能避免分布式系统带来的复杂性和高昂成本,只有当你的博客发展为高并发社区或电商平台时,才需要考虑TiDB等真正的分布式解决方案。
如何降低数据库的服务器成本
降低成本的秘诀在于资源隔离和按需分配,使用Docker容器可以精确限制CPU和内存使用,避免资源浪费,选择按量付费的云数据库实例,或在非高峰时段使用竞价实例,可以显著降低费用,对于静态内容,尽量使用CDN和对象存储,减少数据库的读取压力,据统计,多数情况下,通过合理的索引优化和查询缓存,可以将数据库负载降低至原来的十分之一以下,从而允许使用更低配置的服务器。
云原生数据库迁移难度大吗
云原生架构的优势在于解耦,由于应用与数据库之间通过标准协议(如TCP/IP)通信,迁移过程主要涉及连接字符串的修改和数据导入导出,使用Docker Compose或Kubernetes进行编排,使得环境迁移变得像复制文件夹一样简单,只要确保数据备份完整,迁移过程通常可以在几小时内完成,且对业务影响极小。
个人搭建博客网站时,应摒弃对“分布式”概念的盲目崇拜,转而追求“云原生”的灵活性与可靠性,通过容器化部署轻量级关系型数据库,配合自动化备份和连接池优化,即可构建出一个稳定、高效且低成本的个人内容管理平台。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/304088.html