专业级方案深度解析
真正的免费服务器监控管理,意味着在不牺牲核心功能与可靠性的前提下,通过精心组合顶尖开源工具与云服务,构建媲美商业方案的专业监控体系。
免费监控工具选型核心标准
-
数据采集广度与深度
- 系统层: CPU、内存、磁盘I/O及空间、网络流量、进程状态需全面覆盖。
- 服务层: Web服务器(Nginx/Apache)、数据库(MySQL/PostgreSQL)、缓存(Redis/Memcached)等关键服务的运行状态、性能指标、错误日志必须纳入监控。
- 应用层: 支持对JVM、.NET CLR、自定义应用指标的抓取能力。
-
告警响应时效性
- 支持多级阈值设置(警告、严重)。
- 具备多通道告警能力(邮件、钉钉、企业微信、Slack、Webhook)。
- 支持告警抑制、排班管理,避免告警风暴干扰。
-
数据存储与可视化
- 高效时间序列数据库支撑长期数据存储与快速查询。
- 提供灵活强大的仪表盘定制功能,支持图表、表格、热力图等丰富展现形式。
-
可扩展性与集成性
- 易于横向扩展以应对增长。
- 提供丰富API,便于与企业现有系统(CMDB、工单)集成。
免费专业监控组合方案推荐
-
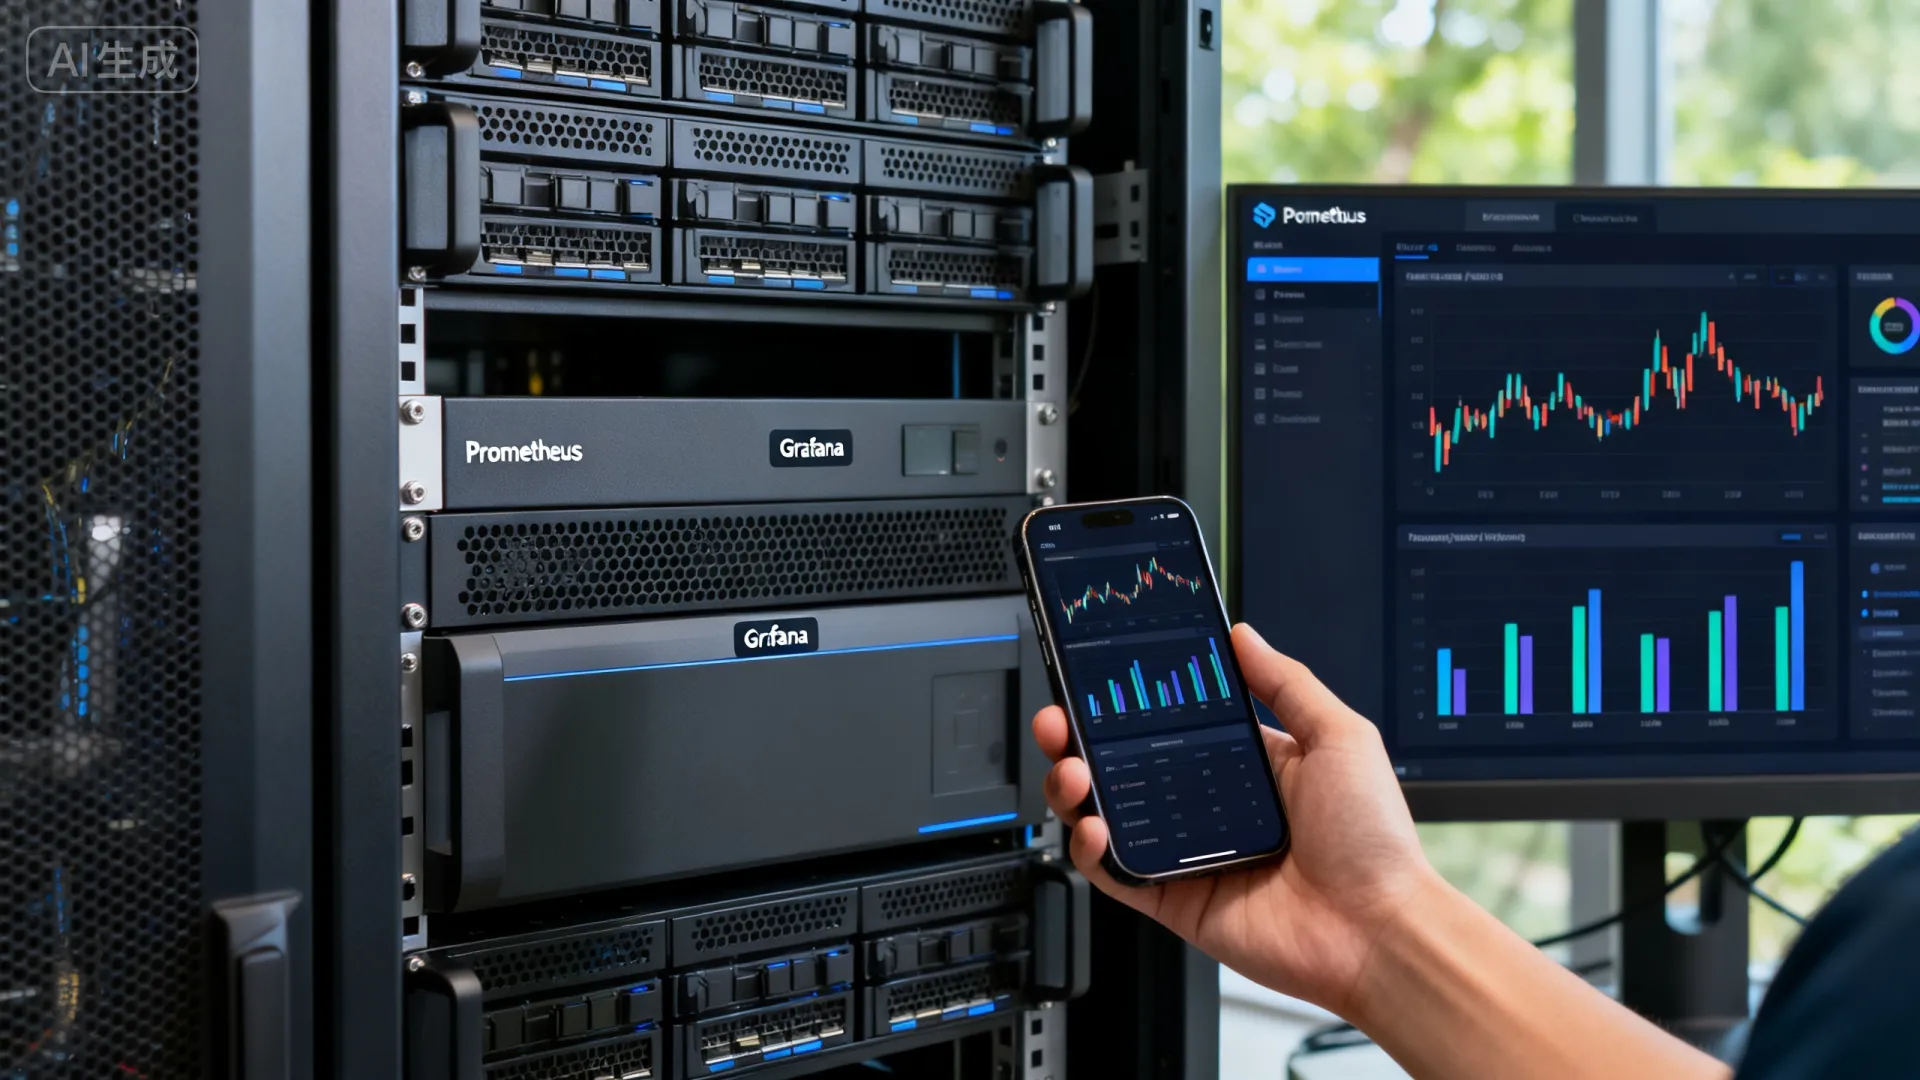
数据采集与中转:Prometheus + Exporters
- Prometheus: 核心时序数据库与拉取引擎,采用Pull模型主动抓取目标数据。
- Exporters: 种类丰富的采集代理,如:
node_exporter:采集服务器硬件与OS指标。mysqld_exporter/postgres_exporter:采集数据库深度指标。nginx-exporter/apache-exporter:采集Web服务器状态。blackbox_exporter:主动探测服务可用性(HTTP/HTTPS/TCP/ICMP)。
-
可视化与仪表盘:Grafana
- 连接Prometheus等多种数据源。
- 通过直观拖拽设计专业仪表盘,支持模板化与分享。
- 提供灵活变量设置与告警规则配置界面。
-
告警通知管理:Alertmanager + 钉钉/企业微信机器人
- Alertmanager: 接收Prometheus告警,进行分组、抑制、静默处理,并路由分发。
- 钉钉/企业微信机器人: 配置Alertmanager Webhook,实现高效移动端告警推送。
-
日志集中管理(增强):Loki + Promtail
- Loki: 轻量级日志聚合系统,索引与存储分离,高性价比。
- Promtail: 日志收集代理,推送日志至Loki。
- Grafana Loki Datasource: 在Grafana中统一查询指标与日志,高效关联分析问题。
专业部署与配置实践
- Prometheus 核心配置 (
prometheus.yml) 精要global: scrape_interval: 15s # 抓取间隔 evaluation_interval: 15s # 规则评估间隔
scrape_configs:
- job_name: ‘node’
static_configs:targets: [‘192.168.1.101:9100’, ‘192.168.1.102:9100’] # node_exporter地址
- job_name: ‘mysql’
static_configs:targets: [‘db-server:9104’] # mysqld_exporter地址
- job_name: ‘blackbox-http’
metrics_path: /probe
params:
module: [http_2xx] # 探测模块
static_configs:- targets:
https://your-website.com
relabel_configs: - source_labels: [address]
target_label: __param_target - source_labels: [__param_target]
target_label: instance - target_label: address
replacement: blackbox-exporter:9115 # blackbox_exporter地址
- targets:
-
Grafana 告警规则示例(CPU使用率过高)
- 在Grafana中创建Alert Rule:
- Query:
100 - (avg by(instance) (irate(node_cpu_seconds_total{mode="idle"}[5m])) 100) - Condition:
WHEN last() OF query(A, 5m, now) IS ABOVE 90 - Duration:
For 5m(持续5分钟触发) - Notifications: 选择配置好的钉钉/企业微信通知渠道。
- Query:
- 在Grafana中创建Alert Rule:
-
Alertmanager 路由与抑制配置 (
alertmanager.yml)route: group_by: ['alertname', 'cluster'] group_wait: 30s group_interval: 5m repeat_interval: 3h routes: - receiver: 'critical-dingtalk' match: severity: critical - receiver: 'warning-email' match: severity: warning
inhibit_rules:
- source_match:
severity: ‘critical’
target_match:
severity: ‘warning’
equal: [‘alertname’, ‘instance’] # 当同一实例同一告警名处于critical时,抑制warning
receivers:
- name: ‘critical-dingtalk’
webhook_configs:url: ‘https://oapi.dingtalk.com/robot/send?access_token=YOUR_TOKEN’
send_resolved: true
- name: ‘warning-email’
email_configs:- to: ‘ops-team@example.com’
生产环境优化关键点
-
Prometheus 存储优化:
- 合理设置
scrape_interval: 非核心指标可适当延长(如60s)。 - 启用数据压缩: TSDB的块压缩显著节省空间(实测可达97.3%压缩率)。
- 长期存储: 使用
remote_write功能将数据备份至VictoriaMetrics或Thanos对象存储,释放本地压力。
- 合理设置
-
高可用部署:
- Prometheus HA: 部署至少两个相同配置的Prometheus实例,同时抓取目标。
- Alertmanager集群: 部署Alertmanager集群,通过
--cluster-参数实现状态共享与去重。 - 负载均衡: 在Prometheus和Alertmanager前端配置Nginx反向代理实现负载均衡。
-
监控指标黄金组合:
- 系统健康: CPU负载(1m, 5m, 15m)、内存使用率(含Swap)、磁盘空间/IOPS/Utilization、网络带宽/错包率。
- 服务关键指标:
- Web: 请求速率、错误率(4xx, 5xx)、响应时间(P95, P99)。
- DB: 连接数、查询速率/慢查询、锁等待、缓存命中率、复制延迟。
- 缓存: 内存使用、命中率、逐出率、网络吞吐。
- 业务洞察: 自定义应用指标(如订单处理量、用户活跃数)。
告警策略最佳实践
- 分级告警:
- Warning: 潜在风险或需关注(如磁盘使用率>80%)。
- Critical: 服务已受影响或即将中断(如磁盘使用率>95%,主库复制中断)。
- 基于SLO告警: 围绕核心业务服务的SLO(如API成功率99.9%)设置告警,比单纯监控资源指标更直接有效。
- 避免噪音:
- 有效抑制: 利用Alertmanager抑制规则避免冗余告警(如主机宕机时抑制其上所有服务告警)。
- 维护窗口: 配置静默规则应对计划内维护。
- 告警聚合: 按服务、集群聚合告警,而非单个实例。
免费方案能否支撑百台以上服务器? 答案是可以,关键在于架构设计:利用Prometheus联邦或VictoriaMetrics集群分片采集,结合Grafana多数据源统一展示,Alertmanager集群处理告警,某电商案例成功应用此免费组合监控超过500节点混合云环境。
哪项免费工具在您当前环境中最具部署价值?您是否遇到过开源监控的独特挑战?欢迎分享您的实战经验与解决方案!
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/18707.html