

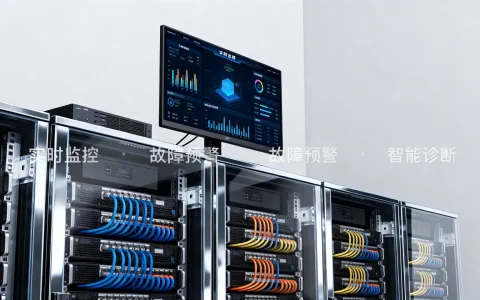
服务器监控系统图是现代IT基础设施管理的核心神经系统,它并非简单的仪表盘集合,而是一个精心设计的架构蓝图,直观映射了服务器及其运行环境的健康状态、性能指标与关键依赖关系,为运维团队提供实时洞察、故障预警与性能优化的关键依据。
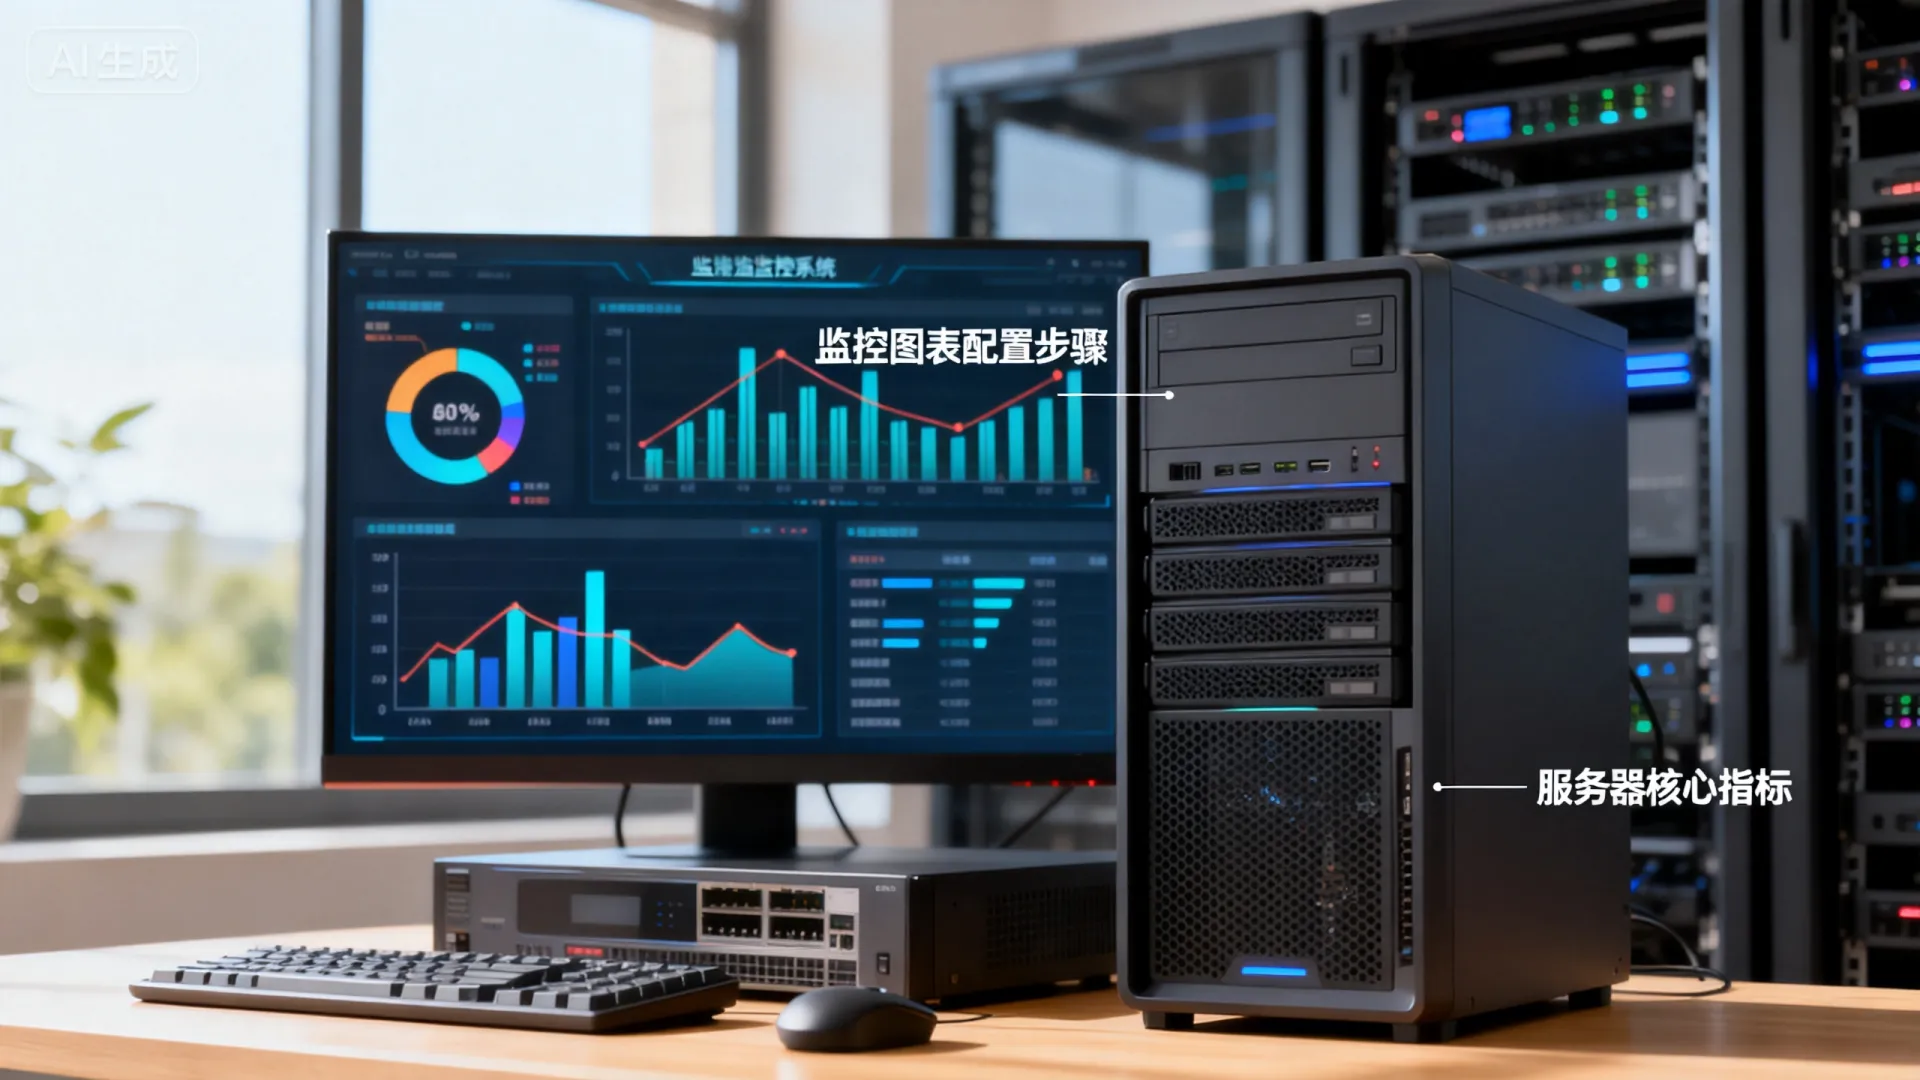
系统图的核心构成要素
一个完善的服务器监控系统图通常包含以下关键层次和组件:
-
基础设施层监控:
- 硬件状态: CPU使用率(核心级、整体)、内存利用率(已用、缓存、交换)、磁盘I/O(读写速率、延迟、队列深度)、磁盘空间使用率(分区级)、网络接口流量(入/出带宽、错包率)、RAID状态、电源状态、风扇转速、温度传感器(CPU、主板、环境)。
- 虚拟化层(如适用): 宿主机资源使用(CPU Ready、内存Ballooning/压缩)、虚拟机资源分配与消耗、存储性能(Datastore I/O、延迟)、网络性能(虚拟交换机)。
-
操作系统层监控:
- 核心指标: 系统负载(Load Average)、进程总数、运行/阻塞进程数、上下文切换频率、中断频率。
- 关键服务状态: SSH、NTP、Syslog、Cron等基础服务的运行状态(Up/Down)。
- 日志监控: 系统关键日志(syslog, messages)的实时采集、解析与告警(如内核错误、硬件故障日志、认证失败)。
-
应用服务层监控:
- 中间件/数据库: Web服务器(Apache, Nginx:活动连接数、请求速率、错误率)、应用服务器(Tomcat, JVM:堆内存、GC频率与时长、线程池状态)、数据库(MySQL, PostgreSQL:连接数、查询速率、慢查询、锁等待、缓存命中率、复制状态)。
- 自定义应用: 应用内部关键业务指标(如订单处理速率、API响应时间、错误计数)、内部队列深度、缓存状态(Redis/Memcached:内存使用、命中率、连接数)。
- 容器化环境(如适用): 容器状态(运行/停止)、资源限制(CPU/Memory Requests/Limits)、重启次数、Pod状态(Kubernetes)、服务端点(Service Endpoints)健康检查。
-
网络与依赖监控:
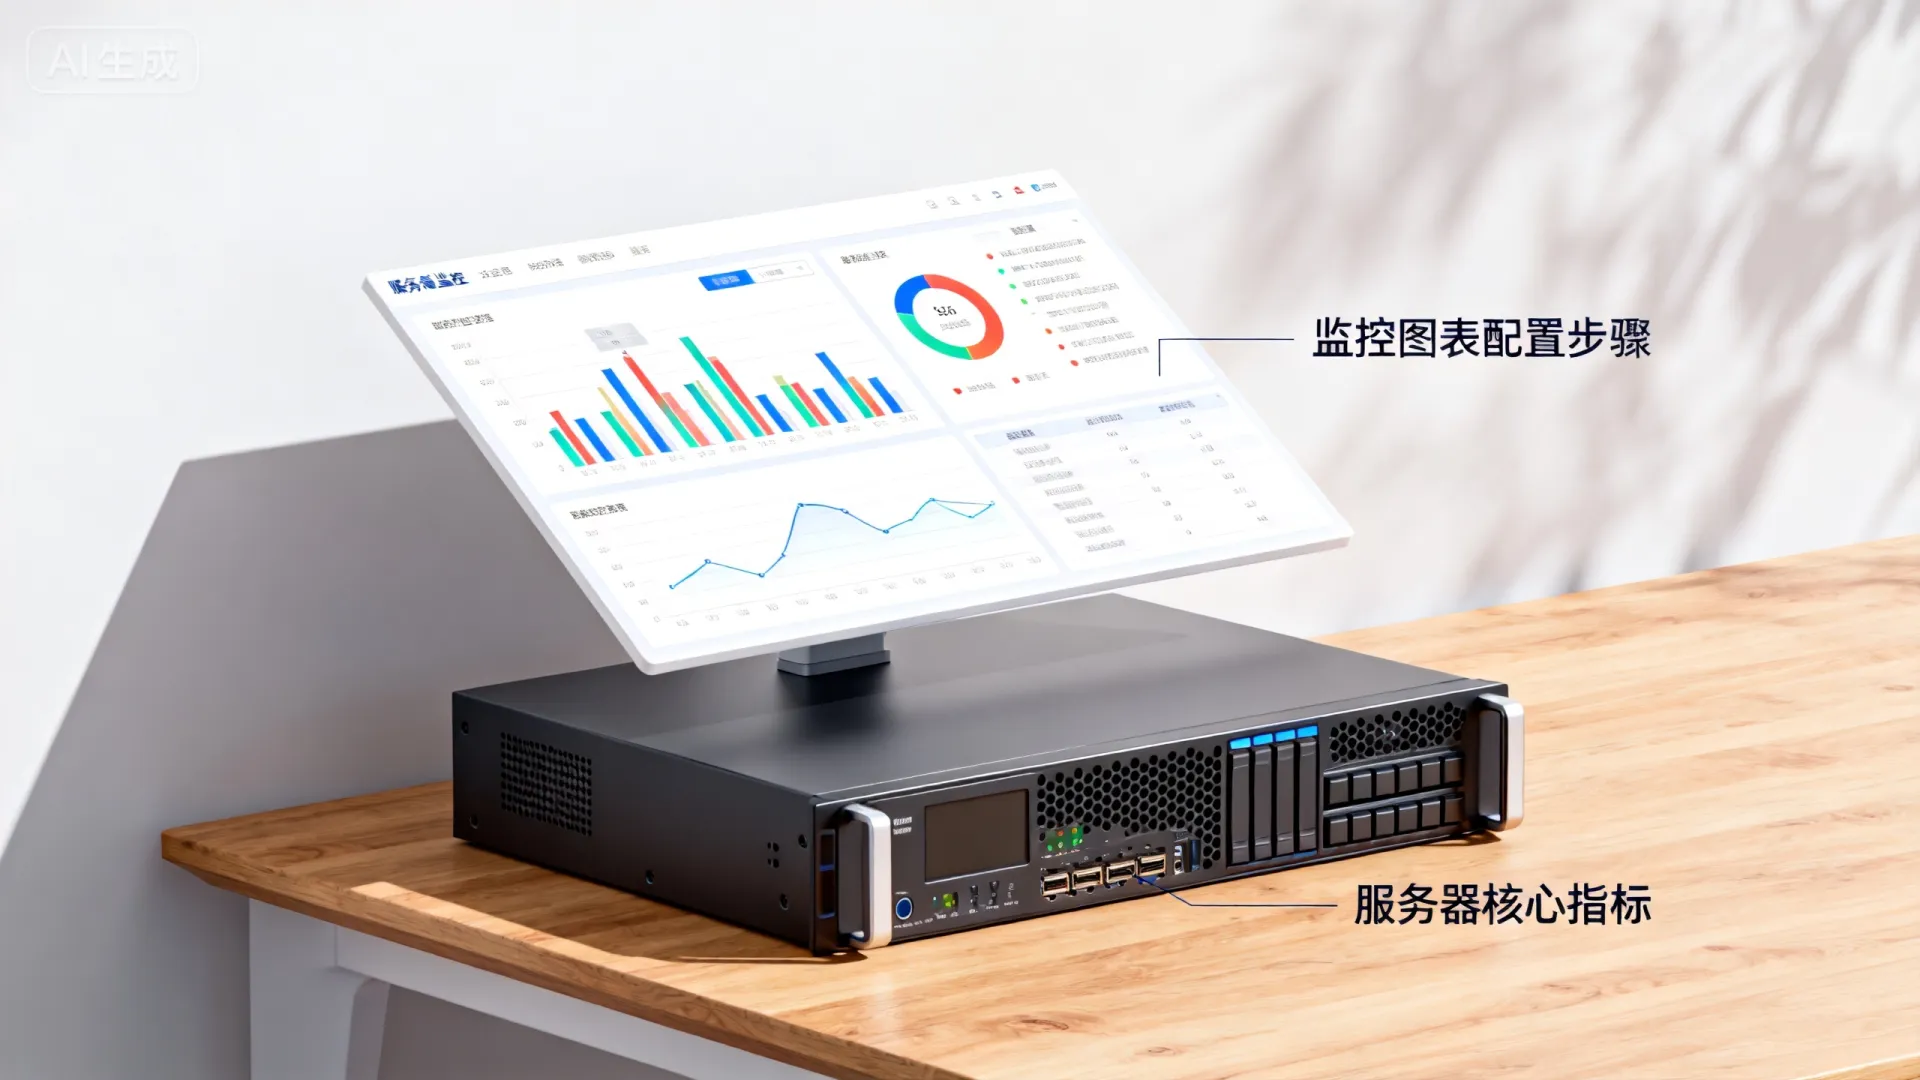
- 网络连通性: ICMP Ping(节点可达性)、TCP端口检测(服务可用性)。
- 网络性能: 端到端延迟(如应用节点到数据库节点)、丢包率、路由追踪。
- 外部依赖: API第三方服务状态、CDN性能、外部数据库连接状态。
-
可视化与告警层:
- 统一仪表盘: 将以上各层指标汇聚,按业务逻辑、物理位置或技术栈分类展示,形成全局视图(如Grafana、Kibana)。
- 智能告警: 基于阈值(静态/动态基线)、异常检测算法、事件关联规则,触发多级告警(邮件、短信、IM、电话),包含清晰的故障定位信息(如“主机A的磁盘 /data 使用率 > 90%”)。
- 拓扑视图: 动态展示服务器、网络设备、应用服务之间的逻辑与物理连接关系,直观呈现故障影响范围。
设计高效监控系统图的关键原则
构建真正有价值的服务器监控系统图,需遵循以下核心原则:
- 目标驱动,聚焦核心: 监控指标必须服务于核心业务目标(如可用性、性能、成本),避免“监控一切”导致噪音淹没关键信号,优先监控影响用户感知和业务连续性的核心指标(黄金指标:延迟、流量、错误、饱和度)。
- 分层解耦,关联清晰: 清晰划分基础设施、OS、应用层,并建立层间指标的关联(如高应用错误率是否由底层数据库慢查询或网络延迟引起),拓扑图是体现关联的关键。
- 指标标准化与元数据: 统一指标命名规范(如Prometheus的
metric_name{label=value})、单位、采集频率,为指标添加丰富的元数据(如所属业务线、责任人、环境),便于过滤、聚合与定位。 - 动态基线,智能异常检测: 超越静态阈值,利用机器学习算法建立指标动态基线(如一天中不同时段、一周中不同日期的正常范围),自动识别与基线显著偏离的异常行为,减少误报漏报。
- 告警精准化与抑制: 告警必须包含足够上下文(哪个对象、什么指标、当前值、阈值、可能影响),并实现告警抑制(如网络设备宕机时,抑制其下游所有服务器的不可达告警,避免告警风暴)。
- 可视化即洞察: 仪表盘设计应直观、信息密度适中,善用图表类型(时间序列图、热力图、状态图、拓扑图),突出趋势对比与异常点,避免华而不实的装饰。
- 可扩展性与集成性: 系统架构需支持轻松添加新的监控目标(服务器、服务、自定义指标)和集成外部系统(CMDB、工单系统、自动化运维平台)。
专业解决方案与最佳实践
-
技术栈选型:
- 采集端: Prometheus Exporters, Telegraf, Datadog Agent, Zabbix Agent,优先选择轻量级、高扩展性的方案。
- 时序数据库: Prometheus, InfluxDB, TimescaleDB,处理海量时间序列数据的核心。
- 可视化与告警: Grafana(强大的可视化、数据源支持),Alertmanager(Prometheus生态告警管理),PagerDuty/Opsgenie(告警路由与排班)。
- 日志管理: ELK Stack (Elasticsearch, Logstash, Kibana), Loki,集中日志分析是根因定位的关键。
- 分布式追踪: Jaeger, Zipkin,用于监控微服务架构中请求的端到端链路性能。
-
实施关键点:
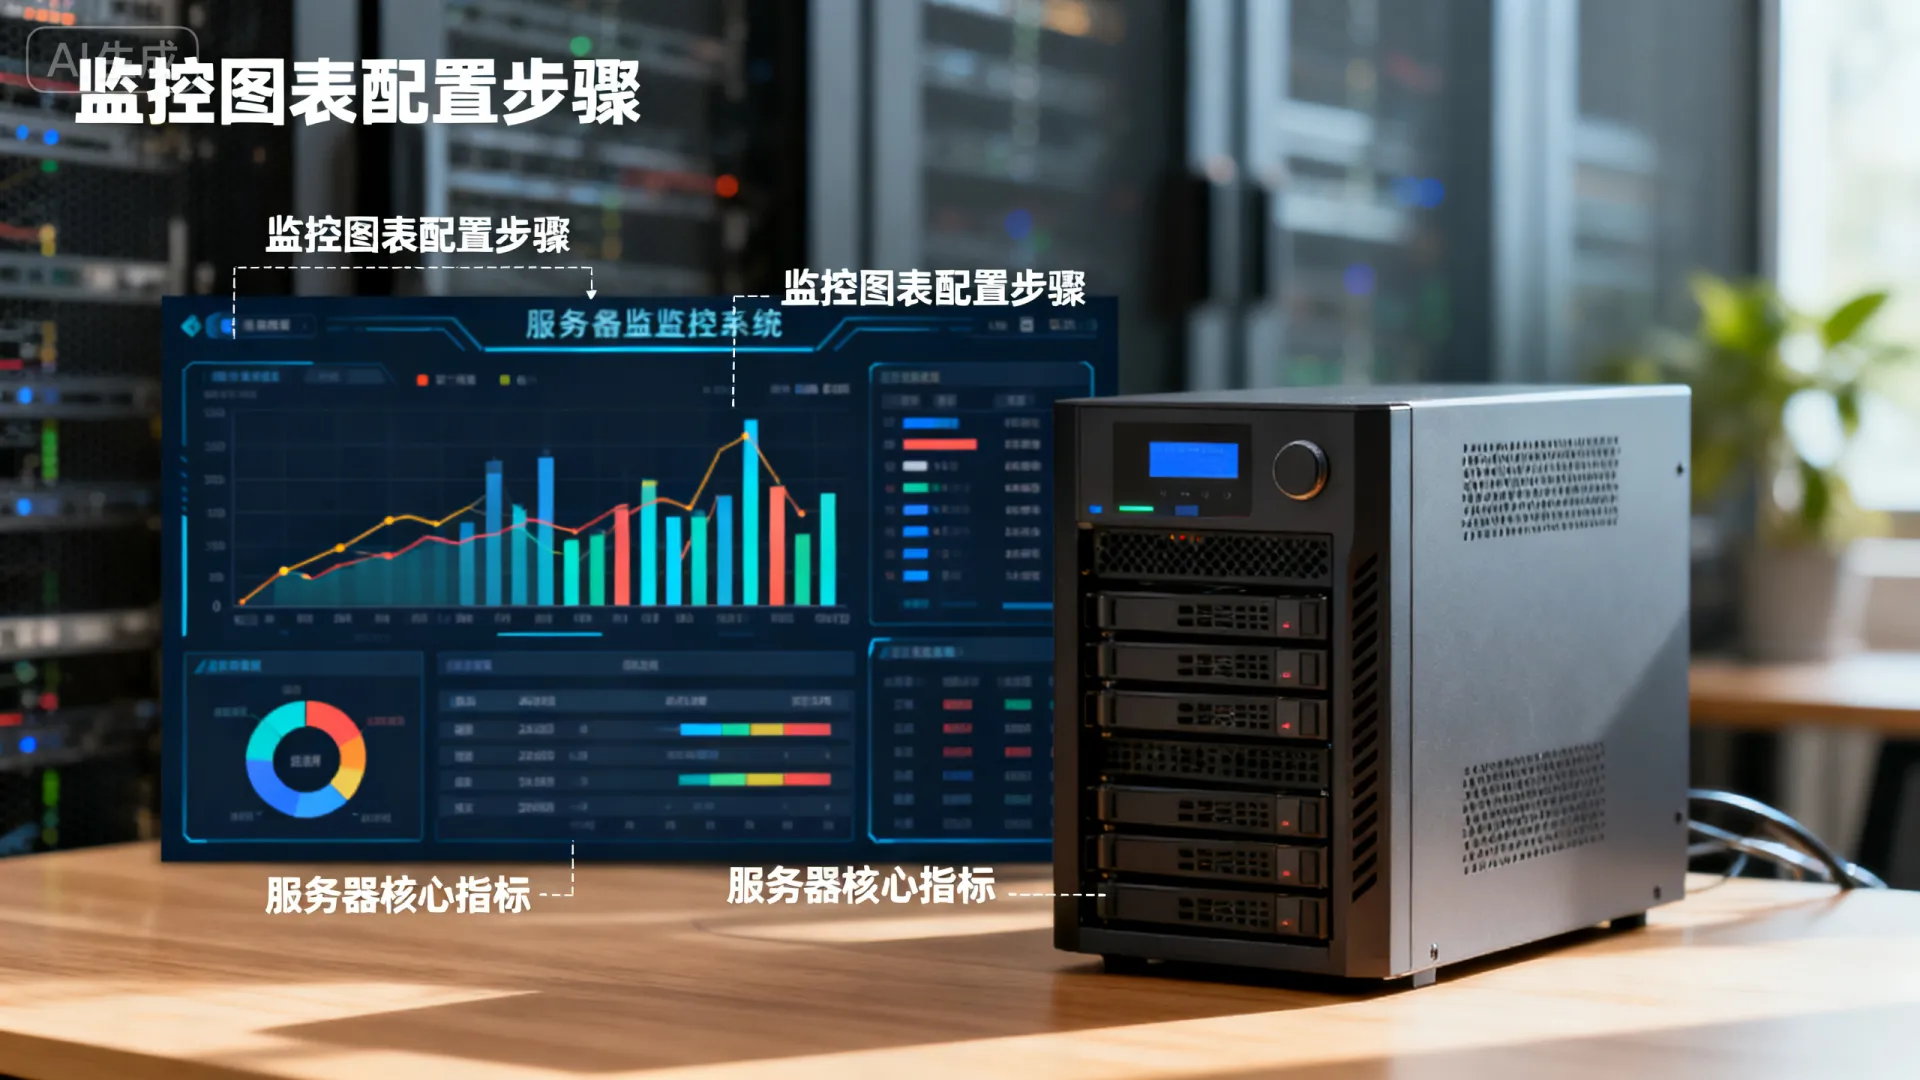
- 建立监控即代码(Monitoring as Code): 使用配置文件(如Prometheus的
prometheus.yml, Grafana的JSON Dashboard)定义监控目标、告警规则、仪表盘,版本控制、代码审查,确保一致性、可审计性和自动化部署。 - 关注指标基数: 高基数指标(如按每个用户ID、每个URL路径标签的指标)可能压垮存储和查询系统,谨慎设计标签维度。
- 监控监控系统自身: 确保监控采集器、数据库、告警组件的健康状态,避免“灯下黑”。
- 定期审查与优化: 定期评估监控项的有效性(哪些告警从未触发?哪些经常误报?哪些关键问题未被覆盖?),清理无用指标,调整阈值和告警策略。
- 与SLO/SLI结合: 将系统监控指标与服务的SLO(服务水平目标)和SLI(服务水平指标)直接关联,监控真正影响用户体验和业务承诺的部分。
- 建立监控即代码(Monitoring as Code): 使用配置文件(如Prometheus的
价值与应用场景
一个设计精良的服务器监控系统图是:
- 故障快速定位与恢复的利器: 通过拓扑关联和精确告警,大幅缩短MTTR(平均修复时间)。
- 性能瓶颈洞察与优化的指南: 识别资源热点(CPU、内存、磁盘I/O、网络瓶颈),为容量规划和性能调优提供数据支撑。
- 保障业务连续性的基石: 7×24小时守护核心业务服务的可用性,预防潜在风险。
- 自动化运维的触发器: 基于监控事件(如磁盘空间不足)自动触发扩容、清理或故障转移脚本。
- IT决策的数据支撑: 提供硬件资源利用率、服务性能趋势的客观数据,指导采购、架构优化和成本控制。
结语与互动
服务器监控系统图不是一成不变的静态展示,而是一个随着业务发展、技术演进持续迭代优化的动态工程,它凝结了运维团队对系统架构的深刻理解和对业务目标的精准把握,投入精力构建和维护一个清晰、精准、智能的监控视图,是保障IT系统稳定、高效、可控运行的必要投资。
您目前的服务器监控系统图是否清晰地展现了关键指标间的关联性?在应对复杂故障定位或性能瓶颈分析时,您认为系统图中哪个环节的优化能带来最大的效率提升?欢迎分享您的实战经验或面临的挑战。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/17705.html





评论列表(3条)
这篇文章写得真不错!作为一个在服务器监控领域摸爬滚打十多年的老手,我得说它抓住了监控系统的精髓——那不只是个花哨的仪表盘,而是整个IT基础设施的神经中枢。文章里对系统图的详解,比如如何直观映射服务器的健康状态和依赖关系,讲得特别到位,我在实际搭建中就遇到过类似挑战,比如配置图表时容易信息过载,导致关键故障被淹没。优化攻略这部分很实用,分享的技巧比如精简指标和预判故障点,帮我在工作中少走弯路。整体上,内容既全面又接地气,新手能快速入门,老手也能挖出新思路。强烈推荐给运维同行们,读完绝对能提升你的监控效率!
看到这篇文章真是一语惊醒梦中人啊!去年我们团队就踩过坑,照着默认模板搭监控,结果磁盘写满的告警居然漏配了。半夜数据库崩了才发现,开发同事顶着黑眼圈抢救数据。现在想想,要是早看到这种讲透配置逻辑的攻略,哪至于搞到焦头烂额?血的教训证明,监控图真不是随便拖几个组件就能用的。
这篇文章写得挺实在的!服务器监控图在IT领域普遍都是命脉,但我觉得具体搭建时得看公司大小或场景,比如小团队和云环境优化策略就不一样。灵活调整才能真正高效预防故障,亲测能省心不少。