大语言模型数据哪来的?大语言模型训练数据来源揭秘

大语言模型的数据来源并非单一渠道,而是涵盖了互联网公开文本、书籍转录、代码仓库以及高质量人工标注数据的混合体,其核心逻辑在于“海量广度”与“精准质量”的博弈。数据决定了模型能力的上限,算法只是逼近这个上限的手段。目前主流大模型的数据构建,本质上是一场针对全球数字化知识的“清洗与提纯”工程。

关于大语言模型数据哪来

公开互联网数据:基石与噪音并存

这是大模型训练的底座,占据了训练数据的绝大部分比例。

  1. Common Crawl(通用爬虫数据): 这是一个包含数十亿网页的海量数据集。它是大模型“知识广度”的来源,但也被称为“数据垃圾场”。 其中包含了大量的广告、垃圾邮件、低质量内容。
  2. 数据清洗的残酷真相: 原始网页数据无法直接使用,工程师需要通过去重、去毒、隐私过滤等流程,将数据“提纯”。从PB级别的原始数据中,最终可能只有10%-20%能进入训练环节。
  3. WebText与Wiki数据: 相比通用爬虫,维基百科和Reddit等社区经过人工筛选的高质量链接,提供了逻辑更严密、事实更准确的知识片段。这部分数据虽然占比小,但对模型语言组织能力的贡献极大。

高质量文本与书籍:逻辑与深度的源泉

为了让模型具备逻辑推理和长文本理解能力,书籍和专业文献不可或缺。

  1. 书籍语料库: 模型需要学习长距离的上下文依赖。书籍提供了连贯的逻辑链条和深度的知识体系,这是碎片化网页无法替代的。 GPT系列模型大量使用了Gutenberg项目等电子书库。
  2. 学术论文与专业文档: ArXiv等论文库不仅提供专业知识,更重要的是提供了严密的论证逻辑。模型通过学习论文结构,能够显著提升“一本正经胡说八道”时的逻辑自洽性。
  3. 垂直领域数据: 法律、医疗、金融等领域的专业数据,是构建行业大模型的关键壁垒。这些数据往往不公开,需要通过授权或合作获取,构成了商业模型的护城河。

代码数据:逻辑推理的隐形推手

一个反直觉的事实是:大语言模型之所以聪明,很大程度上是因为它们“写代码”。

关于大语言模型数据哪来

  1. 代码即逻辑: 代码具有严格的语法规则和逻辑结构。训练模型写代码,实际上是在训练模型的逻辑思维能力和纠错能力。
  2. GitHub的贡献: 开源代码仓库是大模型的重要训练源,代码数据帮助模型学会了“….”的因果推理模式。
  3. 思维链的雏形: 代码中的函数调用和模块化思想,直接促进了模型“思维链”能力的涌现。没有代码数据的训练,大模型的数学和推理能力将大打折扣。

人工标注与合成数据:从“野蛮生长”到“对齐人类意图”

这是大模型训练中最昂贵、也是最关键的环节,直接决定了模型是否“好用”。

  1. RLHF(人类反馈强化学习): 单纯的海量数据只能让模型“续写文本”,无法让它“回答问题”。通过人工标注员对模型回答进行打分,模型学会了什么是“有帮助的”和“安全的”。
  2. 指令微调: 原始数据是杂乱的,指令数据是结构化的。高质量的问答对数据,教会了模型如何听懂指令并按格式输出。
  3. 合成数据的崛起: 随着高质量自然数据的枯竭,利用强模型生成数据训练弱模型成为趋势。合成数据可以无限生成,且质量可控,正在成为数据来源的新增长极。

关于大语言模型数据哪来,说点大实话,数据来源的本质是对人类数字化文明的一次重新编码。 这个过程并非简单的“复制粘贴”,而是涉及复杂的版权博弈、隐私保护和技术清洗。

  1. 版权的黑箱: 大部分模型厂商对具体数据来源讳莫如深。虽然使用了公开数据,但是否构成侵权,目前在全球法律界仍是巨大的争议点。
  2. 数据孤岛效应: 高质量数据正在向封闭流转,Twitter、Reddit等平台开始对API收费,未来大模型获取数据的成本将急剧上升,免费午餐时代已经结束。
  3. 隐私泄露风险: 训练数据中可能混入个人隐私信息。虽然厂商会进行脱敏处理,但模型在特定提示词下仍可能“记忆”并泄露隐私,这是数据清洗的难点。

相关问答

问:大语言模型的数据会定期更新吗?还是一直使用旧数据?

答:大模型的知识截止日期是一个硬伤,模型训练完成后,其参数就固定了,无法像数据库一样实时更新,为了解决这个问题,目前主要有两种方案:一是利用搜索引擎工具(如联网搜索功能),让模型在回答前实时检索最新信息;二是通过微调,定期注入新数据。彻底解决“遗忘”和“实时性”问题,是下一代模型的技术重点。

关于大语言模型数据哪来

问:既然使用了全网数据,为什么大模型有时会一本正经地胡说八道?

答:这被称为“幻觉”现象,模型本质上是概率预测机器,它预测的是下一个字出现的概率,而不是检索事实,当模型遇到知识盲区时,为了最大化“概率合理性”,它会编造看似通顺但违背事实的内容。这通常是因为训练数据中存在噪声,或者模型过度拟合了某些错误模式,目前主要通过RAG(检索增强生成)技术来缓解这一问题。

对于大模型的数据来源,您认为版权问题应该如何解决?欢迎在评论区留下您的看法。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/98372.html

赞 (0)
服务器怎么弄负载均衡?负载均衡配置教程详解
上一篇 2026年3月17日 03:07
AIoT电源是什么?AIoT电源芯片选型指南
下一篇 2026年3月17日 03:13

相关推荐

  • 如何获取CDN IP地址?获取CDN IP地址的方法

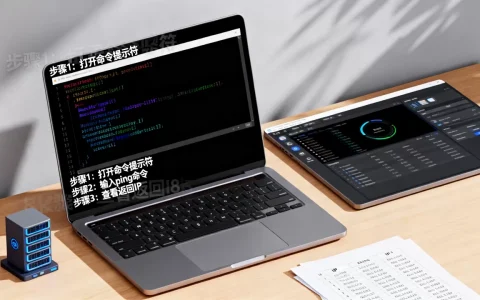
    通过命令行执行 nslookup 或 ping 命令解析域名,结合 CDN 厂商控制台查看节点分布,是获取 CDN IP 最直接且准确的方法,在数字化转型的浪潮中,内容分发网络(CDN)已成为网站加速和安全防护的标配,对于开发者、运维人员甚至普通用户而言,了解 CDN 背后的 IP 地址并非易事,很多时候,我们……

    2026年6月22日
    4500
  • 康乐cdn实际加速效果怎么样?康乐cdn怎么使用

    康乐CDN凭借其针对医疗健康行业的深度优化,在2026年已成为国内医疗机构首选的CDN加速服务,其低延迟、高安全性和定制化节点覆盖,显著优于通用CDN,康乐CDN核心优势解析超低延迟的边缘网络全球部署超过2000个加速节点,国内节点覆盖所有省份,尤其强化三线及以下城市医疗接入,智能路由算法基于实时网络质量数据……

    2026年7月18日
    1100
  • 服务器在哪里看服务器?揭秘服务器追踪与监控的秘密

    要查看服务器的物理位置或网络位置,可以通过以下几种核心方法:对于您自己管理的服务器,直接联系托管服务商或查看服务合同;对于远程服务器,使用IP地址查询工具;对于云服务器,登录云服务商的管理控制台查看,理解“服务器位置”的不同含义在查找服务器位置前,需明确您想了解的是哪种“位置”:物理位置:指服务器硬件实际存放的……

    2026年2月3日
    17400
  • 如何防止过快点击问题发生,有哪些有效的预防措施?

    防止过快点击的核心是通过防抖、节流、按钮禁用和后端幂等性校验等组合手段,确保每次操作在时间窗口内唯一生效,避免重复提交、数据错乱或系统负载异常,为什么防止过快点击是刚需用户或程序在短时间内反复触发同一个操作,带来的后果远不止界面卡顿这么简单,在电商支付、活动抢票、表单提交等场景中,一次点击对应一次业务请求,一旦……

    2026年8月6日
    1000
  • cdn缓存如何实现,cdn缓存配置方法

    CDN缓存通过在全球边缘节点存储静态资源副本,利用智能调度系统将用户请求就近分发,从而降低源站负载并显著提升访问速度,其核心机制在于“缓存命中”与“回源”的协同运作,CDN缓存的核心运作逻辑请求调度与边缘分发分发网络)并非单一服务器,而是一个分布式的服务器集群,当用户发起访问请求时,DNS解析系统会根据用户的地……

    2026年7月5日
    10600
  • CDN购买服务商怎么选?cdn购买服务商怎么选

    对于2026年cdn购买,建议优先选择阿里云、腾讯云等头部云厂商的CDN服务,其节点覆盖广、计费灵活且安全性高,中小业务可考虑网宿科技或白山云等专业厂商,预算充足则选择全站加速方案,CDN服务商选择标准节点覆盖与质量国内节点数量:阿里云2800+,腾讯云2000+,网宿1500+(2026年Q1数据)海外节点覆……

    2026年7月22日
    1400
  • cdn在我,cdn是什么

    CDN(内容分发网络)的核心价值在于通过边缘节点就近分发内容,显著降低延迟、提升加载速度并保障高并发下的稳定性,是企业构建高性能互联网应用的必备基础设施,在2026年的数字化语境下,CDN已不再仅仅是加速工具,而是云原生架构中不可或缺的数据流转枢纽,随着5G普及与AI应用爆发,用户对毫秒级响应的期待成为常态,C……

    2026年6月22日
    4900
  • 数智AI大模型真相是什么?大模型落地难、成本高、效果差?

    关于数智AI大模型,说点大实话:当前行业正从“技术炒作”转向“价值落地”,真正能跑通商业闭环的模型,已从百模竞发进入“精耕时代”,核心结论:2024年起,AI大模型的竞争焦点已从参数规模转向三个硬指标——垂直场景适配度、推理成本控制力、企业级可集成性,以下分三层展开:现实差距:大模型落地的三大认知误区“参数越大……

    云计算 2026年4月18日
    6400
  • cdn.gog.com是什么?gog平台cdn加速地址怎么设置

    cdn.gog.com 是 GOG 平台的静态资源分发网络,通过全球节点加速游戏文件下载与更新,解决国内玩家访问慢、连接不稳定的核心痛点,在数字娱乐日益普及的今天,流畅的游戏体验不再仅仅取决于硬件配置,网络环境的稳定性同样至关重要,对于许多热衷于 PC 单机游戏特别是 DRM-Free(无数字版权管理)游戏的玩……

    2026年5月29日
    4400
  • WordPress伪静态CDN怎么设置?WordPress配置CDN加速教程

    WordPress开启伪静态并配合CDN加速,是提升网站加载速度、优化移动端体验及提高百度收录权重的核心手段,能有效解决服务器响应慢和静态资源加载阻塞的问题,很多站长在搭建好WordPress博客或企业站后,发现页面打开缓慢,尤其是图片多、文章长的页面,首屏加载时间常常超过3秒,这不仅影响用户体验,更会让百度爬……

    2026年5月30日
    3800

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注