能跑大模型的机器,核心真相只有一个:显存大小决定生死,算力决定快慢,预算决定上限,从业多年,见过太多企业和个人在硬件选型上踩坑,盲目堆砌CPU和内存,却忽略了GPU显存这一核心瓶颈。真正决定你能否跑起来大模型的,是显存容量;决定你跑得快不快的,是显存带宽和算力;决定你能否长期稳定运行的,是散热与电源。 别被营销话术忽悠,大模型训练和推理对硬件的要求有着严格的物理定律,任何试图绕过这些定律的“性价比方案”,最终都会以项目失败告终。

显存:不可逾越的物理护城河
很多人问,为什么我的显卡跑不动7B模型?答案往往在显存上。
- 容量是硬指标。 模型参数加载到GPU中进行计算,需要占用显存,以FP16精度为例,每10亿参数大约需要2GB显存,一个70亿参数(7B)的模型,仅权重就需要14GB显存,加上推理过程中的KV Cache和上下文占用,至少需要16GB甚至24GB的显存才能流畅运行,如果你只有8GB显存,要么只能量化到INT4精度牺牲智商,要么直接爆显存报错。
- 带宽决定速度。 显存容量决定了能不能跑,显存带宽决定了跑得快不快,大模型推理是典型的“访存密集型”任务,GPU大部分时间都在从显存搬运数据。高端卡之所以贵,不仅是因为算力强,更是因为HBM高带宽显存极其昂贵。 同样是24GB显存,RTX 4090的带宽远超老旧的专业卡,生成速度会有数量级的差异。
算力与精度:被误解的“性能过剩”
在选购能跑大模型的机器时,算力往往被过度关注,而精度支持被严重忽视。
- 算力不是万能的。 对于推理场景,中高端消费级显卡的算力已经过剩,除非你进行大规模训练或微调,否则盲目追求双路、四路显卡服务器,性价比极低。
- FP8与Transformer引擎。 新一代显卡(如RTX 40系列、H100等)支持FP8精度,这能让吞吐量翻倍。如果你的显卡不支持FP8,在未来的模型迭代中将处于劣势。 从业者必须关注硬件对新精度标准的支持,这比单纯的CUDA核心数量更重要。
关于能跑大模型的机器,从业者说出大实话:消费级显卡是目前性价比最高的选择,但企业级应用必须考虑多卡互联。 消费级卡如RTX 4090虽然性价比极高,但无法通过NVLink互联,多卡通信走PCIe通道,延迟高、带宽低,做多机多卡训练效率极低,如果你是做单机推理或单卡微调,消费级卡是神;如果是做大模型训练集群,必须上企业级A800/H800系列。
配套设施:木桶效应的短板
很多团队花了大价钱买GPU,却在CPU、内存和硬盘上省钱,导致系统整体性能被拖垮。

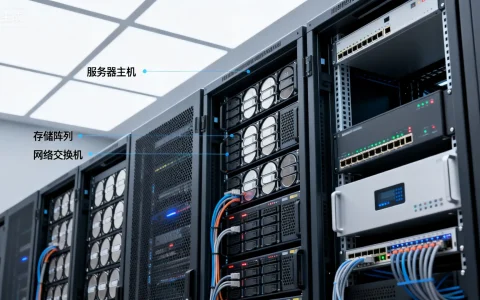
- 内存带宽与CPU。 数据预处理需要CPU参与,如果CPU单核性能太弱,数据喂给GPU的速度就跟不上,导致GPU空转。建议配置至少是GPU显存2倍大小的系统内存,且必须使用DDR5高频内存,保证数据吞吐。
- PCIe通道数。 主板的PCIe通道数至关重要,如果你插多张显卡,每张卡都需要足够的通道数(通常x16或x8)。通道数不足会导致显卡降速,严重影响多卡并行效率。 选购主板和CPU时,必须确认PCIe Lane的数量是否充足。
- 存储I/O。 模型加载动辄几十GB,机械硬盘直接淘汰。必须使用NVMe SSD,且最好是企业级或带有DRAM缓存的型号,读取速度要在7GB/s以上,否则每次加载模型都要等待数分钟,严重影响开发效率。
散热与电源:稳定性的隐形杀手
大模型通常是长时间高负载运行,这与打游戏间歇性负载完全不同。
- 电源余量。 高端GPU瞬间功耗峰值可能超过额定功率。电源额定功率建议比整机满载功耗高出30%-50%,且必须通过80 Plus金牌或白金认证,劣质电源在长时间满载下会电压不稳,导致训练中断甚至硬件烧毁。
- 散热风道。 机箱风道设计不合理,会导致GPU过热降频。涡轮风扇显卡适合密集多卡部署,开放式风扇显卡适合单卡或双卡。 很多个人开发者买了开放式风扇的卡塞进狭窄机箱,结果温度飙升,性能减半。
不同场景的硬件配置方案
基于上述原则,给出具体的配置建议:
-
入门尝鲜/个人学习。
- 显卡:RTX 3060 (12GB) 或 RTX 4060 Ti (16GB)。12GB显存是入门门槛,能跑INT4量化的Llama-3-8B。
- 内存:32GB DDR5。
- 用途:学习原理,跑小参数模型推理。
-
进阶开发/小微企业部署。
- 显卡:RTX 3090 (24GB) 或 RTX 4090 (24GB)。24GB显存是性价比黄金线,能跑13B-34B模型,甚至微调7B模型。
- 内存:64GB-128GB DDR5。
- 用途:本地知识库部署、小规模微调、应用开发测试。
-
企业级生产/大模型训练。

- 显卡:A800/H800/A100 (40GB/80GB)。必须支持NVLink和多卡互联,大显存支持长上下文。
- CPU:服务器级EPYC或Xeon,多通道内存。
- 用途:全参数微调、大规模并发推理、长文本处理。
相关问答
问:我想在本地跑Llama-3-70B模型,需要什么样的显卡配置?
答:Llama-3-70B模型参数量巨大,如果是FP16精度,仅模型权重就需要约140GB显存,这意味着你需要两张A100 80GB或四张RTX 4090(通过模型并行切分),对于个人或小团队,最现实的方案是使用INT4量化版本,大约需要40GB-48GB显存,可以通过两张RTX 3090/4090(24GB x 2)并联运行,推理速度尚可,但显存依然是最大瓶颈。
问:为什么我的RTX 4060 Ti 16GB跑大模型比RTX 3090 24GB还慢?
答:这涉及显存位宽,RTX 4060 Ti的显存位宽被阉割至128-bit,而RTX 3090是384-bit,虽然4060 Ti显存够大能装下模型,但数据传输通道窄,导致显存带宽低,数据搬运慢,大模型推理极度依赖显存带宽,因此显存带宽更大的老旗舰卡(如3090)往往比显存大但带宽小的新中端卡(如4060 Ti 16G)跑得更快。
如果你在搭建大模型硬件环境过程中遇到具体的瓶颈,或者有更具性价比的配置方案,欢迎在评论区留言交流。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/95731.html