服务器响应时间
服务器响应时间(Server Response Time),也称为首字节时间(Time to First Byte, TTFB),是指从用户浏览器发起一个HTTP请求到接收到服务器返回的第一个数据字节所经历的时间,这是衡量网站性能、用户体验和搜索引擎优化(SEO)的关键核心指标。专业的网站性能优化实践表明,将服务器响应时间稳定控制在200毫秒以内是保障用户体验和SEO竞争力的基准线。
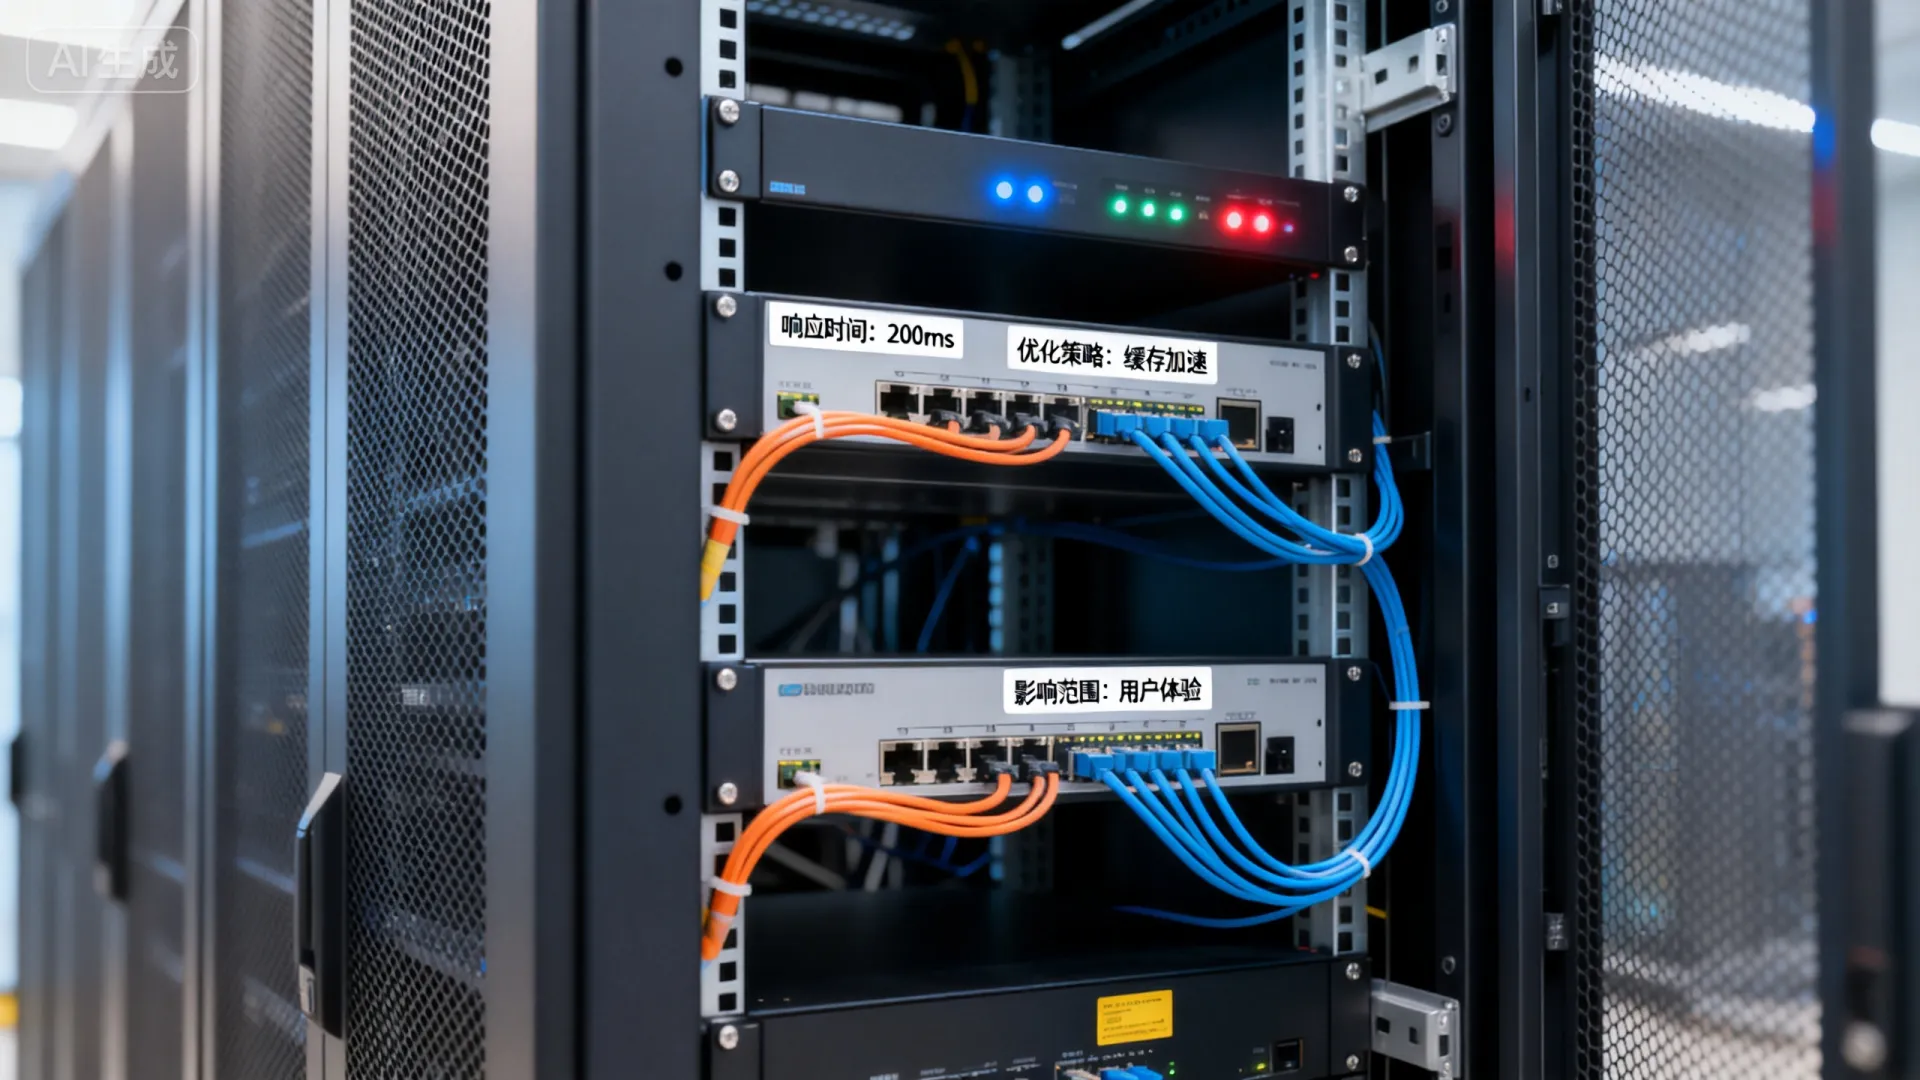
为什么服务器响应时间如此重要?
- 用户体验的核心: 用户对网站速度极其敏感,缓慢的响应会立即导致挫败感,增加跳出率(Bounce Rate),并显著降低转化率(Conversion Rate),用户期望的是即时反馈。
- SEO排名的关键因素: 谷歌、百度等主流搜索引擎明确将页面加载速度(其中服务器响应时间是首要环节)作为重要的排名信号,较长的TTFB会直接影响网站在搜索结果中的可见度,谷歌的Core Web Vitals中的LCP(最大内容绘制)指标也受到TTFB的直接影响。
- 网站承载能力的体现: 快速的响应时间意味着服务器能更高效地处理请求,从而在相同硬件资源下支撑更高的并发用户量和访问流量。
- 业务成功的基石: 无论是电商、内容平台还是企业官网,快速的响应直接关联用户满意度、留存率和最终的业务收入,研究一致表明,即使是毫秒级的延迟也会对业务指标产生可量化的负面影响。
深入剖析:服务器响应时间由哪些环节构成?
理解TTFB的内部构成是优化的基础,它主要包含以下阶段:
-
请求传输时间:
- 用户请求从浏览器出发,经过本地网络、互联网骨干网,最终到达你的服务器。
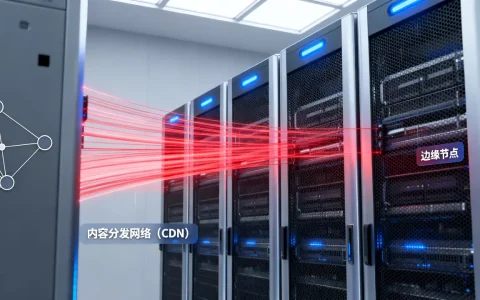
- 影响因素: 用户地理位置与服务器的物理距离、网络路由质量、本地网络状况(WiFi/蜂窝信号)、ISP质量,CDN的核心价值之一就是缩短此距离。
-
服务器处理时间:
- 服务器接收到请求后,执行必要操作以生成响应所花费的时间。这是优化潜力最大的部分。
- 关键子过程:
- Web服务器处理: (Nginx/Apache) 接收请求、解析请求头、匹配虚拟主机配置、应用重写规则等。
- 应用逻辑执行: (PHP/Python/Java/Node.js/Ruby等) 这是核心耗时点,包括框架初始化、路由解析、数据库查询、调用外部API、执行业务逻辑、渲染模板等。
- 数据库交互: (MySQL/PostgreSQL/MongoDB等) 执行SQL查询或NoSQL操作,查询复杂度、索引效率、数据量、连接池管理是核心因素。
- 外部服务调用: 调用支付网关、CRM、ERP、缓存服务(如Redis/Memcached)、搜索引擎(如Elasticsearch)等第三方API或内部微服务,这些调用的延迟会累加到总响应时间中。
-
响应首字节传输时间:
- 服务器生成响应(至少是HTTP响应头)后,将第一个数据包发送回用户浏览器所需的时间。
- 影响因素: 服务器出口带宽、网络拥塞情况、服务器本身的网络栈处理效率(如TCP协议栈优化)。
专业级优化策略:如何有效缩短服务器响应时间?
优化TTFB需要系统性思维,覆盖基础设施、应用架构和代码层面,以下策略经过专业实践验证:
-
基础设施与网络优化:
- 分发网络(CDN): 这是应对地理距离和网络延迟的黄金标准。 将静态资源(图片、CSS、JS、字体)甚至动态内容缓存到离用户更近的边缘节点,大幅缩短请求传输时间和后端服务器压力,选择覆盖广泛、性能优异的CDN供应商(如Cloudflare、Akamai、阿里云CDN、腾讯云CDN)。
- 升级服务器硬件/规格: 确保服务器拥有足够的CPU、内存(RAM)资源处理预期负载,使用更快的SSD存储能显著提升数据库和文件读写速度,对于高并发场景,考虑更高主频的CPU。
- 优化服务器位置: 将服务器部署在靠近目标用户群体的主要数据中心或云区域(Region),利用云服务商的多区域部署能力。
- 启用HTTP/2或HTTP/3: 这些新一代协议在连接复用、头部压缩、传输效率上比HTTP/1.1有质的飞跃,能降低延迟提升整体性能。
- 配置高效Web服务器: (Nginx通常比Apache更轻量高效)
- 调整工作进程/线程数 (
worker_processes,worker_connections)。 - 启用Gzip/Brotli压缩减少传输量。
- 优化连接超时设置 (
keepalive_timeout)。 - 设置合理的缓冲区大小。
- 调整工作进程/线程数 (
-
应用层深度优化:
- 代码性能剖析与优化:
- 使用专业工具(如Xdebug for PHP, Py-Spy for Python, VisualVM for Java, Node.js Profiler)找出应用中的性能瓶颈(慢函数、高CPU消耗、内存泄漏)。
- 优化算法复杂度,避免低效循环和嵌套。
- 减少不必要的计算和I/O操作。
- 利用缓存机制:
- 对象缓存: 大量使用Redis或Memcached缓存数据库查询结果、API响应、复杂计算结果,这是应对高读取负载最有效的手段之一,确保合理的缓存失效策略。
- 操作码缓存: (PHP) 启用并优化OPcache,避免每次请求都重新解析和编译PHP脚本。
- 页面缓存: 对于变化不频繁的页面(如文章页、产品页),使用Varnish、Nginx FastCGI Cache或应用级缓存(如WordPress的W3 Total Cache/WP Super Cache)生成静态HTML,对于动态内容,考虑ESI(Edge Side Includes)。
- 数据库优化:
- 索引优化: 这是数据库性能的命脉,使用
EXPLAIN分析慢查询,确保查询有效利用索引,避免全表扫描,建立覆盖索引。 - 查询优化: 精简查询,只选择必要的字段(避免
SELECT),优化JOIN操作,使用批处理减少查询次数,利用数据库连接池。 - 架构优化: 考虑读写分离(主从复制),对于超大规模数据,合理分库分表(Sharding)。
- 定期维护: 清理碎片、优化表、更新统计信息。
- 索引优化: 这是数据库性能的命脉,使用
- 异步处理: 将非即时必要的任务(如发送邮件、生成报告、图片处理)放入消息队列(如RabbitMQ, Kafka, Redis Streams, AWS SQS)由后台工作进程异步处理,避免阻塞Web请求响应。
- 优化外部服务调用:
- 设置合理的连接超时和读取超时。
- 实现熔断机制(Circuit Breaker)防止故障服务拖垮整个应用。
- 对多个可并行调用的外部服务使用并发请求(如Python的
asyncio/aiohttp, PHP的Guzzle异步请求)。
- 精简框架与依赖: 评估框架和第三方库的必要性及其性能开销,移除未使用的组件和依赖。
- 代码性能剖析与优化:
-
架构演进:
- 微服务架构: 将大型单体应用拆分为松耦合、独立部署的小型服务,每个服务可以独立优化、扩展,避免单体臃肿导致的性能瓶颈和资源竞争,需要配套的服务发现、API网关、监控等基础设施。
- 自动伸缩: 利用云平台(AWS Auto Scaling, Kubernetes HPA)根据CPU、内存、请求量等指标自动增加或减少服务器实例,应对流量波动,优化资源利用和成本。
- 分布式计算/存储: 对于计算密集型或海量数据存储需求,采用分布式方案。
不可或缺:监控、测量与告警
优化不是一劳永逸的,需要持续监控:
-
核心监控工具:
- 服务器/应用性能监控(APM): Datadog, New Relic, Dynatrace, Prometheus+Grafana, 阿里云ARMS, 腾讯云应用性能观测,提供代码级性能剖析、数据库查询分析、请求链路追踪(Trace)。
- 合成监控: Simulated User Monitoring (SUM),使用工具(如Google Lighthouse, WebPageTest, Pingdom, Synthetic Monitors in APM tools)在预设地点和频率模拟用户访问,持续测量TTFB等关键指标,生成性能报告,Lighthouse的TTFB诊断非常直接。
- 真实用户监控(RUM): Real User Monitoring,通过嵌入前端代码(如Google Analytics 4的Site Speed报告、Cloudflare Web Analytics、专门的RUM工具)收集真实用户的性能体验数据,反映实际用户体验。
- 服务器指标监控: 使用Zabbix, Nagios, Cloud Provider Monitoring (CloudWatch, Cloud Monitor) 监控服务器CPU、内存、磁盘I/O、网络流量、负载等基础设施健康指标。
- 日志分析: 集中收集和分析Nginx/Apache访问日志、错误日志、应用日志(ELK Stack – Elasticsearch, Logstash, Kibana 或 Loki+Grafana),排查错误和性能问题。
-
设定基准与告警: 建立性能基线,为关键指标(如TTFB P95值)设置合理的告警阈值,当TTFB持续超出目标(如>500ms)时,立即触发告警通知团队排查。
常见问题排查思路
当TTFB异常升高时,按以下步骤排查:
- 定位范围: 通过APM工具或链路追踪,确定是普遍问题还是特定接口/服务问题,查看监控仪表盘,是否伴随CPU、内存、磁盘、网络飙升?
- 检查基础设施/网络: 服务器负载是否过高?网络带宽是否打满?CDN是否正常回源?DNS解析是否有问题?云服务商是否有故障公告?
- 分析慢请求: 利用APM工具精确定位耗时最长的请求,查看Trace详情,瓶颈在应用代码?数据库查询?外部API调用?缓存未命中?
- 检查数据库: 数据库负载是否高?是否存在慢查询?表是否被锁?连接池是否耗尽?检查慢查询日志 (
slow_query_log),使用SHOW PROCESSLIST查看当前活动。 - 审查应用日志: 查找错误、异常、超时记录,是否有内存溢出(OOM)?是否有死锁?是否有外部服务调用频繁失败?
- 检查变更: 近期是否有代码发布、配置更改、流量突增(营销活动)?
总结与行动指南
服务器响应时间是网站性能的命脉,将其优化至200毫秒以内是专业运维和开发团队的核心目标,这需要:
- 优先应用CDN 解决地理延迟问题。
- 深度优化应用代码和数据库,特别是高效利用缓存(对象缓存、操作码缓存)。
- 建立全面的性能监控体系(APM + 合成监控 + RUM + 基础设施监控),设定告警。
- 持续进行性能测试和分析,优化永无止境。
- 根据业务规模和复杂度,适时考虑架构演进(微服务、自动伸缩)。
忽视服务器响应时间的优化,意味着在用户体验和搜索引擎竞争中主动落后,投入资源进行系统性的性能优化,是保障网站成功的关键技术投资。
您的网站服务器响应时间表现如何?在使用哪些工具监控和优化?在TTFB优化实践中,您遇到过最具挑战性的问题是什么?又是如何解决的?欢迎在评论区分享您的经验和见解!
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/9200.html