高通跑大模型怎么样?从业者揭秘真实体验

高通跑大模型并非简单的“端侧AI普及”,其核心本质是在算力、功耗与模型精度之间寻找极致平衡的工程艺术,从业者必须清醒认识到,高通芯片运行大模型并非万能解药,它是一场针对内存带宽和能效比的极限突围,真正的行业大实话是:硬件算力往往不是瓶颈,内存墙和散热限制才是决定落地成败的关键,只有深入理解NPU架构特性与量化压缩技术,才能在端侧设备上实现真正可用的智能体验。

关于高通跑大模型

硬件架构真相:算力表象下的内存困局

很多开发者初次接触高通端侧AI时,容易被峰值算力数据误导,在跑大模型场景下,内存带宽才是那道难以逾越的“墙”。

  1. 算力过剩与带宽不足的矛盾
    以骁龙8 Gen系列为例,其Hexagon NPU提供的TOPS数值看似亮眼,但在运行70亿参数(7B)级别的大模型时,数据搬运的速度远低于计算单元的处理速度,这导致NPU常常处于“等米下锅”的状态,实际推理速度被内存带宽死死卡住。从业者必须关注内存规格,LPDDR5x的带宽利用率直接决定了Token生成速率。

  2. 功耗墙是悬在头顶的达摩克利斯之剑
    在手机等移动端设备上,跑大模型最大的挑战不是跑不起来,而是跑得久不久、烫不烫手,持续高负载运行大模型会迅速触发热管理机制,导致降频,一旦降频,推理延迟瞬间飙升,用户体验崩塌。真正的专业优化,是在TDP(热设计功耗)限制内,压榨出每一滴有效算力,而非追求短时间的峰值跑分。

软件栈博弈:从“能跑”到“好用”的鸿沟

高通的AI软件栈(QAIS)虽然日益成熟,但在实际落地中,模型量化带来的精度损失是从业者无法回避的痛点。

  1. INT4量化的残酷取舍
    为了塞进有限的显存,将FP16模型量化为INT4甚至INT8是常规操作。量化并非简单的数学转换,它是对模型智能的“有损压缩”,在某些复杂的逻辑推理任务中,INT4模型可能会出现严重的“降智”现象,从业者说出的大实话是:不要迷信官方展示的Demo效果,实际业务场景中的Corner Case(边缘情况)往往在量化后惨不忍睹。

    关于高通跑大模型

  2. 推理引擎的碎片化挑战
    虽然高通大力推行QNN(Qualcomm Neural Network)SDK,但在实际开发中,开发者往往需要在ONNX Runtime、TFLite以及QNN之间反复横跳。不同后端对不同算子的支持程度参差不齐,一个看似简单的自定义算子,可能需要花费数周时间进行底层适配。构建一套稳定、跨平台的推理管线,比单纯训练模型更考验工程能力。

落地实战策略:打破幻想,回归工程理性

关于高通跑大模型,从业者说出大实话的核心在于:必须针对端侧特性进行端到端的定制化设计,而非直接搬运云端模型。

  1. 模型架构的端侧适配
    不要试图在端侧硬推稠密大模型。应优先选择MoE(混合专家)架构或通过蒸馏技术得到的小模型,MoE架构在推理时仅激活部分参数,极大地降低了计算量和显存占用,非常适合高通NPU的稀疏计算优化特性。

  2. KV Cache的极致优化
    在长文本生成场景中,KV Cache会随着对话轮次线性增长,迅速吃光内存。必须实施KV Cache的重计算或分页管理技术,这是区分“Demo级应用”与“商用级产品”的分水岭,只有解决了上下文长度受限的问题,端侧大模型才具备真正的实用价值。

  3. 异构计算资源的合理调度
    高通平台拥有CPU、GPU和NPU三种计算单元。盲目将所有负载都扔给NPU并非最优解,对于某些控制流密集、并行度低的算子,CPU反而更高效;对于某些高吞吐的矩阵运算,GPU可能具备更好的兼容性。专业的做法是进行算子级的异构调度,让合适的算子跑在合适的单元上。

行业未来展望:端云协同才是终局

关于高通跑大模型

高通在端侧AI的投入巨大,但这并不意味着端侧将完全取代云端。未来的主流形态必然是“端侧处理敏感数据与高频请求,云端处理复杂逻辑与长尾知识”。

对于开发者而言,关于高通跑大模型,从业者说出大实话的价值在于打破了对“本地运行百亿模型”的过度神话,它要求我们从算法设计之初就具备“硬件感知”的能力,将量化误差、内存带宽、散热功耗纳入模型设计的考量范围,只有尊重物理限制,才能在方寸之间通过工程智慧释放AI的真正潜力。


相关问答

问:为什么我的模型在高通开发板上跑通了,但在真机上推理速度慢且发热严重?
答:这通常是因为开发板拥有主动散热和充足的电源供应,而真机处于被动散热且电池供电的严苛环境中,你需要检查模型是否触发了温控降频策略,建议降低模型参数规模,使用更激进的量化策略(如INT4),并利用高通的Performance Profile API将设备锁定在低功耗模式运行,牺牲部分速度换取稳定性。

问:高通NPU运行大模型时,如何解决精度下降的问题?
答:精度下降主要源于量化误差,建议采用“量化感知训练(QAT)”而非训练后量化(PTQ),在训练阶段就模拟量化噪声,使模型适应低精度环境,可以利用高通AI引擎提供的模型优化工具,对敏感层进行混合精度处理,保留关键层的FP16精度,在精度与性能之间找到最佳平衡点。

您在端侧部署大模型时,遇到过哪些意想不到的“坑”?欢迎在评论区分享您的实战经验。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/87285.html

赞 (0)
airflow dag依赖如何配置?airflow任务依赖设置方法
上一篇 2026年3月13日 05:52
花了时间研究ai大模型的车,哪款智能驾驶最值得买?
下一篇 2026年3月13日 05:53

相关推荐

  • 大模型在金融领域有哪些应用场景?盘点最实用趋势

    大模型正在重塑金融行业的核心生产力,其应用已从早期的简单交互式问答,全面渗透至投研分析、风险控制、客户服务及代码开发等关键业务环节,大模型金融应用趋势使用场景盘点,太实用了,这不仅体现在效率的指数级提升,更在于它正在重构金融机构的决策逻辑与服务边界,金融机构若能精准把握这一技术红利,将在激烈的市场竞争中占据先机……

    2026年3月3日
    15100
  • 服务器安全管理比赛怎么参加?服务器安全大赛报名条件

    在数字化威胁指数级攀升的2026年,参与服务器安全管理比赛已成为企业淬炼防御体系、选拔顶尖攻防人才的最短路径,其核心价值在于通过极限实战检验将安全漏洞拦截在真实泄露之前,服务器安全管理比赛的核心价值与行业重塑威胁演进下的实战刚需根据国家计算机网络应急技术处理协调中心(CNCERT)2026年初发布的《网络安全态……

    2026年4月26日
    4800
  • 联通cdn价格

    2026年联通CDN价格并非固定单一数值,而是基于“带宽峰值+流量阶梯+节点类型”的动态计费模式,综合成本通常比传统IDC低30%-50%,具体单价需根据业务场景(如视频点播、Web加速)及月结量级在0.15元/GB至0.45元/GB区间浮动,联通CDN定价体系深度解析在2026年的数字基础设施市场中,中国联通……

    2026年6月22日
    2100
  • 大模型预测中国未来会怎样?最新版本预测结果解析

    中国未来十年的发展轨迹将呈现“技术驱动型高质量增长”态势,核心特征是人工智能与实体经济的深度融合,以及人口结构变化带来的产业重构,基于大模型预测中国未来_新版本的综合数据分析,我们可以明确判断:中国经济不再单纯追求GDP增速的绝对值,而是转向全要素生产率的提升,这一转型将伴随阵痛,但最终将确立中国在全球产业链中……

    2026年3月12日
    12800
  • CDN手动刷新缓存不生效?如何快速清除CDN缓存

    CDN手动刷新缓存是解决网站内容更新后用户仍看到旧页面的最快手段,通常能在1-3分钟内生效,优先用于紧急修复或重大活动上线,当你的网站刚刚更新了核心文章、替换了Banner图片,或者修复了严重的Bug,但用户访问时依然显示旧内容,这种“数据不同步”的焦虑感非常折磨人,别慌,这通常是因为CDN节点的缓存机制在“保……

    2026年6月11日
    3100
  • 服务器怎么开启CDN,具体有哪些配置步骤?

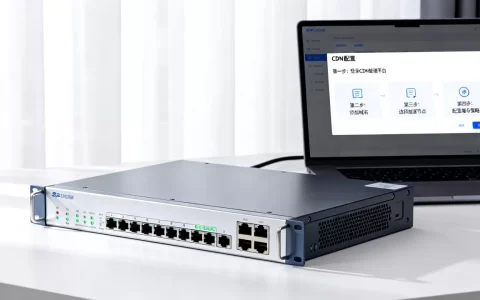
    服务器开启CDN的核心在于将域名解析到CDN节点,并配置源站信息和缓存规则,通过分发节点实现内容加速与防护,服务器怎么配置cdn?分步操作指南很多站长在服务器上搭好网站后,发现访问速度不够理想,尤其是跨地区用户,这时候就需要给服务器开CDN,下面这套流程是业内通用的标准做法,按步骤操作就能完成配置,第一步:选择……

    2026年7月25日
    1100
  • 蚌埠域名服务器是什么?域名服务器基本概念详解

    蚌埠域名服务器并非独立存在的物理实体,而是指部署在蚌埠地区的DNS解析节点或本地化DNS服务方案,其核心价值在于通过缩短物理距离降低解析延迟,提升本地用户访问速度及企业内网解析的安全性,蚌埠DNS解析服务的底层逻辑与核心价值很多人对“域名服务器”存在误解,认为它像电脑主机一样是一个看得见摸得着的黑色盒子,域名系……

    2026年7月4日
    11200
  • 2C8g服务器能跑多少线程?,线程数多少合适

    2核8G服务器在常规Web应用场景下,建议的线程数(或进程数)范围在50至150之间,具体数值取决于业务类型、代码效率以及系统资源开销, 对于大多数轻量级应用,这个配置足以应对日均数千到数万次请求,但若设置不当,反而会拖垮性能,2核8G服务器到底能跑多少线程?线程数的决定因素线程数没有固定值,它由几个核心变量共……

    2026年8月4日
    1100
  • 千问音频大模型怎么用?一篇讲透千问音频大模型

    千问音频大模型的核心逻辑并非遥不可及的黑科技,而是一套基于“统一建模思想”的高效音频理解与生成系统,其本质是将听觉信号转化为机器能读懂的语言,再通过强大的语言模型大脑进行处理,最终实现听、说、想的一体化, 许多开发者认为音频模型复杂,是因为被繁琐的信号处理流程劝退,但千问通过架构创新,大幅降低了这一门槛,它不再……

    2026年3月27日
    10400
  • 阿里云cdn挖矿是怎么回事?阿里云cdn被挖矿怎么处理

    阿里云CDN被用于挖矿是严重的违规滥用行为,不仅会导致账号被封禁、产生高额账单,更可能涉及法律风险,用户应立即停止此类操作并检查服务器安全,阿里云CDN挖矿的本质与危害解析什么是CDN资源滥用分发网络)的核心设计初衷是加速静态资源的加载速度,通过边缘节点缓存内容,减少源站压力,部分不法分子或安全意识薄弱的用户……

    2026年5月30日
    4100

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注