大数据开发的工具生态体系庞大且复杂,但核心逻辑始终围绕着数据的采集、存储、计算与展现四个环节展开。构建高效的大数据开发架构,关键在于根据业务场景选择合适的工具栈,而非盲目追求技术的新颖性。 一个成熟的大数据开发体系,必须具备高吞吐量的数据接入能力、高可靠性的分布式存储能力以及高性能的并行计算能力,当前主流的技术选型已从单一的Hadoop生态演变为Lambda架构与Kappa架构并存的混合模式,工具的选择直接决定了数据价值的挖掘效率与落地成本。

数据采集与传输层:数据流动的动脉
数据采集是大数据开发的第一公里,决定了数据的时效性与完整性,这一层的工具主要分为离线批处理和实时流处理两类。
- Apache Sqoop:作为传统关系型数据库(如MySQL、Oracle)与Hadoop生态之间数据迁移的桥梁,Sqoop利用MapReduce并行计算能力,高效实现了数据的批量导入与导出,虽然架构较老,但在T+1离线数仓场景中依然稳定可靠。
- Apache Flume:专为海量日志数据设计。Flume基于流式架构,具备强大的容错机制, 能够实时收集来自应用服务器、网络设备的海量日志,并将其下沉至HDFS或Kafka,其事务机制保证了数据在传输过程中不丢失,是日志收集的事实标准。
- Apache Kafka:Kafka是大数据架构中不可或缺的消息中间件。 它不仅作为数据缓冲区削峰填谷,解耦了生产者与消费者,更是构建实时数仓的核心组件,其高吞吐、低延迟的特性,支撑了实时推荐、实时监控等关键业务。
数据存储层:海量数据的基石
存储层解决了“数据放哪里”的问题,主要分为分布式文件存储和NoSQL数据库。
- HDFS(Hadoop Distributed File System):大数据存储的基石。 HDFS采用主从架构,将大文件切分成数据块分散存储在集群节点上,其高容错性通过多副本机制实现,即使部分节点故障,数据依然可访问,它是离线批处理场景下性价比最高的存储方案。
- HBase:基于HDFS构建的分布式列式存储数据库。HBase支持海量数据的随机实时读写, 弥补了HDFS只能顺序读写的短板,适用于明细查询、时序数据存储等场景,如金融交易记录、物联网设备状态追踪。
- 对象存储与数据湖技术:随着云原生技术的发展,AWS S3、阿里云OSS等对象存储逐渐替代HDFS,成为新的存储载体,结合Delta Lake、Apache Hudi等数据湖技术,实现了流批一体的存储管理, 解决了数据更新、ACID事务支持等痛点。
数据计算层:挖掘价值的核心引擎
计算层是大数据开发的大脑,负责对数据进行清洗、转换、聚合与分析。
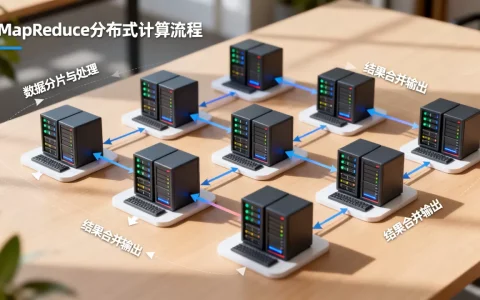
- MapReduce:第一代分布式计算框架,编程模型复杂,磁盘I/O开销大。目前主要用于离线数据清洗和归档, 在交互式分析场景中已逐渐被淘汰。
- Apache Spark:当前最主流的通用大数据计算引擎。 Spark基于内存计算,引入DAG(有向无环图)执行引擎,性能比MapReduce快百倍,它提供SQL、Streaming、MLlib机器学习库等统一技术栈,既能处理离线批处理,也能应对准实时流计算, 是企业ETL开发的首选工具。
- Apache Flink:新一代流式计算引擎的王者。 Flink秉持“流是第一公民”的理念,基于事件驱动,提供了毫秒级的延迟和精确一次的状态一致性保障,在实时数仓、实时风控、CEP复杂事件处理领域,Flink具有不可替代的优势。
数据查询与分析层:数据价值的出口

为了降低数据分析门槛,提升查询效率,交互式分析工具应运而生。
- Hive:构建在Hadoop之上的数据仓库工具。 Hive将结构化数据文件映射为一张数据库表,并提供类SQL查询语言(HQL),它将SQL转化为MapReduce或Tez任务运行,适合处理大规模数据的离线分析, 是早期数仓的核心组件。
- ClickHouse:OLAP领域的性能怪兽。 ClickHouse采用列式存储和向量化执行引擎,单表查询性能极强,它支持SQL语法,广泛应用于用户行为分析、实时报表、大屏展示等场景,能够实现秒级响应亿万级数据的聚合查询。
- Presto与Doris:Presto是一款分布式SQL查询引擎,擅长跨源联邦查询,可直接连接MySQL、Hive、Kafka等多种数据源进行联合分析,Apache Doris则是极速易用的实时数仓,支持高并发查询, 在即席查询(Ad-hoc)场景表现优异。
任务调度与集群管理:系统的指挥官
一个完整的大数据开发流程涉及数百个任务的依赖执行,必须依赖调度系统。
- Apache Airflow:目前最流行的数据工程编排工具。 Airflow使用Python代码定义工作流,具有强大的DAG(有向无环图)管理能力,它支持任务重试、依赖管理、日志监控,能够清晰地管理复杂的ETL任务链, 是现代数据栈的标准配置。
- Apache YARN:大数据集群的资源管理系统,YARN负责集群资源的统一管理和调度,确保计算任务能够公平、高效地获取CPU和内存资源, 防止资源争抢导致的系统崩溃。
专业见解与解决方案
在实际的大数据开发过程中,工具选型并非越先进越好。对于中小规模企业,盲目引入Flink和ClickHouse可能导致运维成本过高。 建议初期采用“Hive + Spark + MySQL”的经典架构,随着数据量增长和实时性需求提升,再逐步演进至“Kafka + Flink + ClickHouse”的实时架构。
数据治理往往比工具本身更重要。缺乏元数据管理、数据质量监控和血缘分析的工具链,最终会演变成“数据沼泽”。 在引入{大数据开发的工具}时,必须同步规划数据目录构建与质量校验机制,确保数据资产的可管、可控、可用。
相关问答

大数据开发中,Spark和Flink应该如何选择?
解答: 选择依据主要看业务对时效性的要求,如果业务主要是T+1的离线报表、数据清洗,或者需要利用统一的API进行机器学习训练,Spark是性价比最高的选择,其生态成熟,社区活跃,上手难度相对较低,如果业务场景涉及实时风控、实时大屏、金融交易监控,要求毫秒级延迟且不能丢失数据,Flink则是必选项,目前业界主流趋势是“流批一体”,Flink在该领域的技术前瞻性更强,但Spark也在不断优化其Streaming能力。
初学者入门大数据开发,应该从哪个工具开始学习?
解答: 建议遵循“HDFS -> Hive -> Spark”的学习路径,首先理解HDFS的存储原理,这是大数据的根基;其次掌握Hive,学会用SQL思维去处理大数据,这能快速建立成就感;最后深入学习Spark Core与Spark SQL,理解分布式计算的核心逻辑。掌握这三者,即可胜任绝大多数离线数仓开发岗位。 切忌一开始就钻研源码或复杂的实时计算框架,容易因难度过大而放弃。
您在当前的项目中更倾向于使用哪种计算引擎?欢迎在评论区分享您的技术选型经验。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/83459.html