本地训练开源大模型对于绝大多数普通消费者而言,性价比极低且技术门槛过高,并非明智之选,但对于拥有特定隐私需求、硬件基础雄厚的极客或企业用户,则是实现数据私有化与定制化的唯一路径,消费者真实评价普遍呈现出两极分化的态势:一方面是对技术自由的向往,另一方面则是对硬件成本与调试难度的无奈叹息。
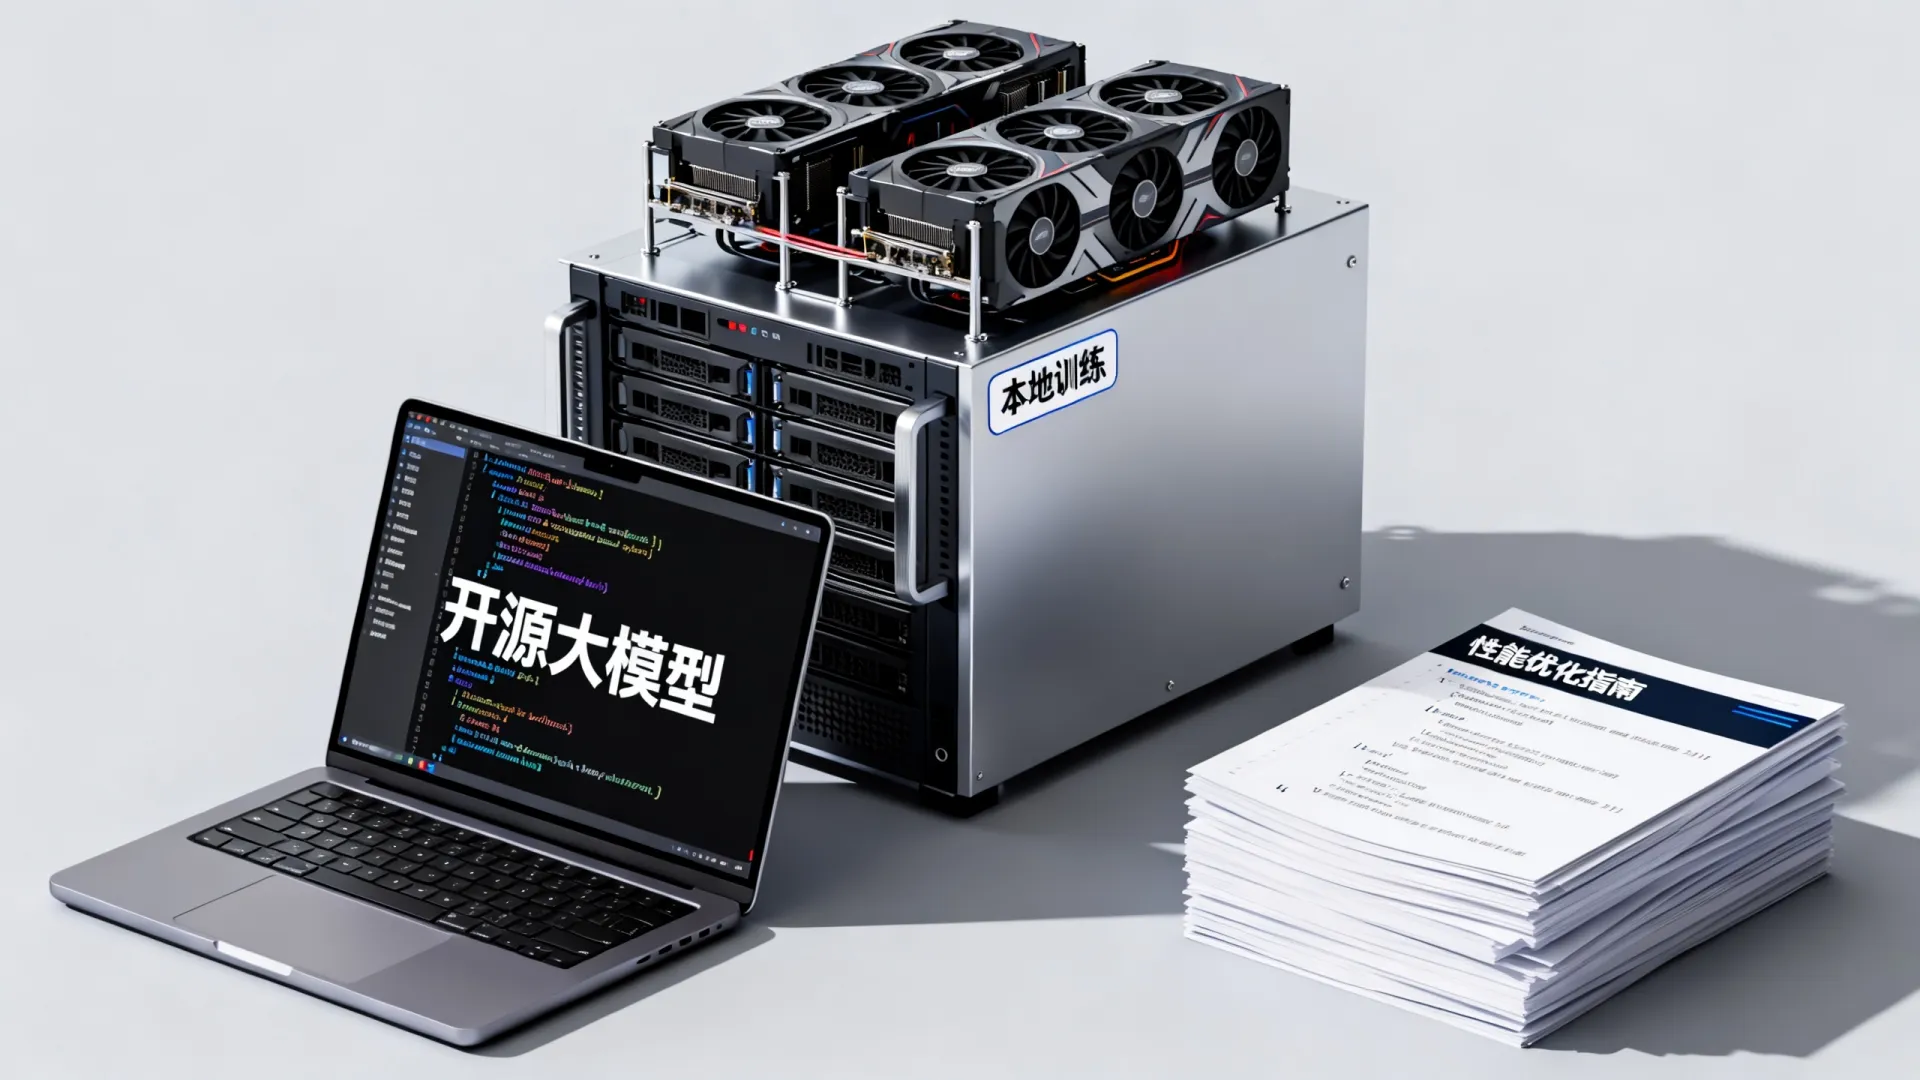
核心痛点:硬件成本与算力瓶颈的残酷现实
消费者在尝试本地训练开源大模型时,首先面临的便是硬件这一“拦路虎”,这并非简单的软件安装问题,而是实打实的资金投入。
-
显存容量的硬性指标
本地“训练”与“推理”有着天壤之别,推理只需加载模型权重,而训练(包括微调)则需要存储优化器状态、梯度和参数,显存消耗通常是推理的数倍。- 消费者反馈: 许多尝试在消费级显卡(如RTX 3060 12G或RTX 4090 24G)上进行全量微调的用户发现,稍有不慎便会遭遇CUDA Out of Memory(显存溢出)错误。
- 真实数据: 想要对7B参数量的模型进行高效微调,至少需要24GB以上的显存支持,若涉及更大参数模型,往往需要多卡并联,成本瞬间飙升至数万元。
-
电力与散热的经济账
长时间的高负载训练会让显卡处于满载状态。- 噪音干扰: 涡轮风扇的轰鸣声被用户戏称为“直升机起飞”,严重影响居家办公体验。
- 电费开支: 有用户计算,完成一次完整的LoRA微调所消耗的电费,甚至足以支付云端API调用数月的费用。
技术门槛:环境配置与调试的时间黑洞
对于缺乏计算机科学背景的消费者,环境搭建是第二道难关,开源社区虽然提供了丰富的工具,但碎片化严重。
-
环境依赖的“地狱级”复杂度
CUDA版本冲突、PyTorch版本不兼容、Python库依赖冲突是家常便饭。- 消费者真实评价: “花在解决报错上的时间,比真正训练模型的时间还要长。”这是新手最真实的写照。
- 学习曲线: 从Git克隆代码、配置虚拟环境到安装Flash-Attention等加速库,每一个环节都可能因为操作系统差异或驱动版本问题而卡顿数天。
-
数据预处理的隐形挑战
模型训练的质量高度依赖于数据。- 数据清洗: 许多用户发现,直接投喂原始文本会导致模型输出乱码或过拟合。
- 格式转换: 将私有数据转换为模型可识别的JSON或Parquet格式,需要掌握一定的脚本编写能力,这对普通消费者构成了巨大的技术壁垒。
效果评估:期望与现实的巨大落差
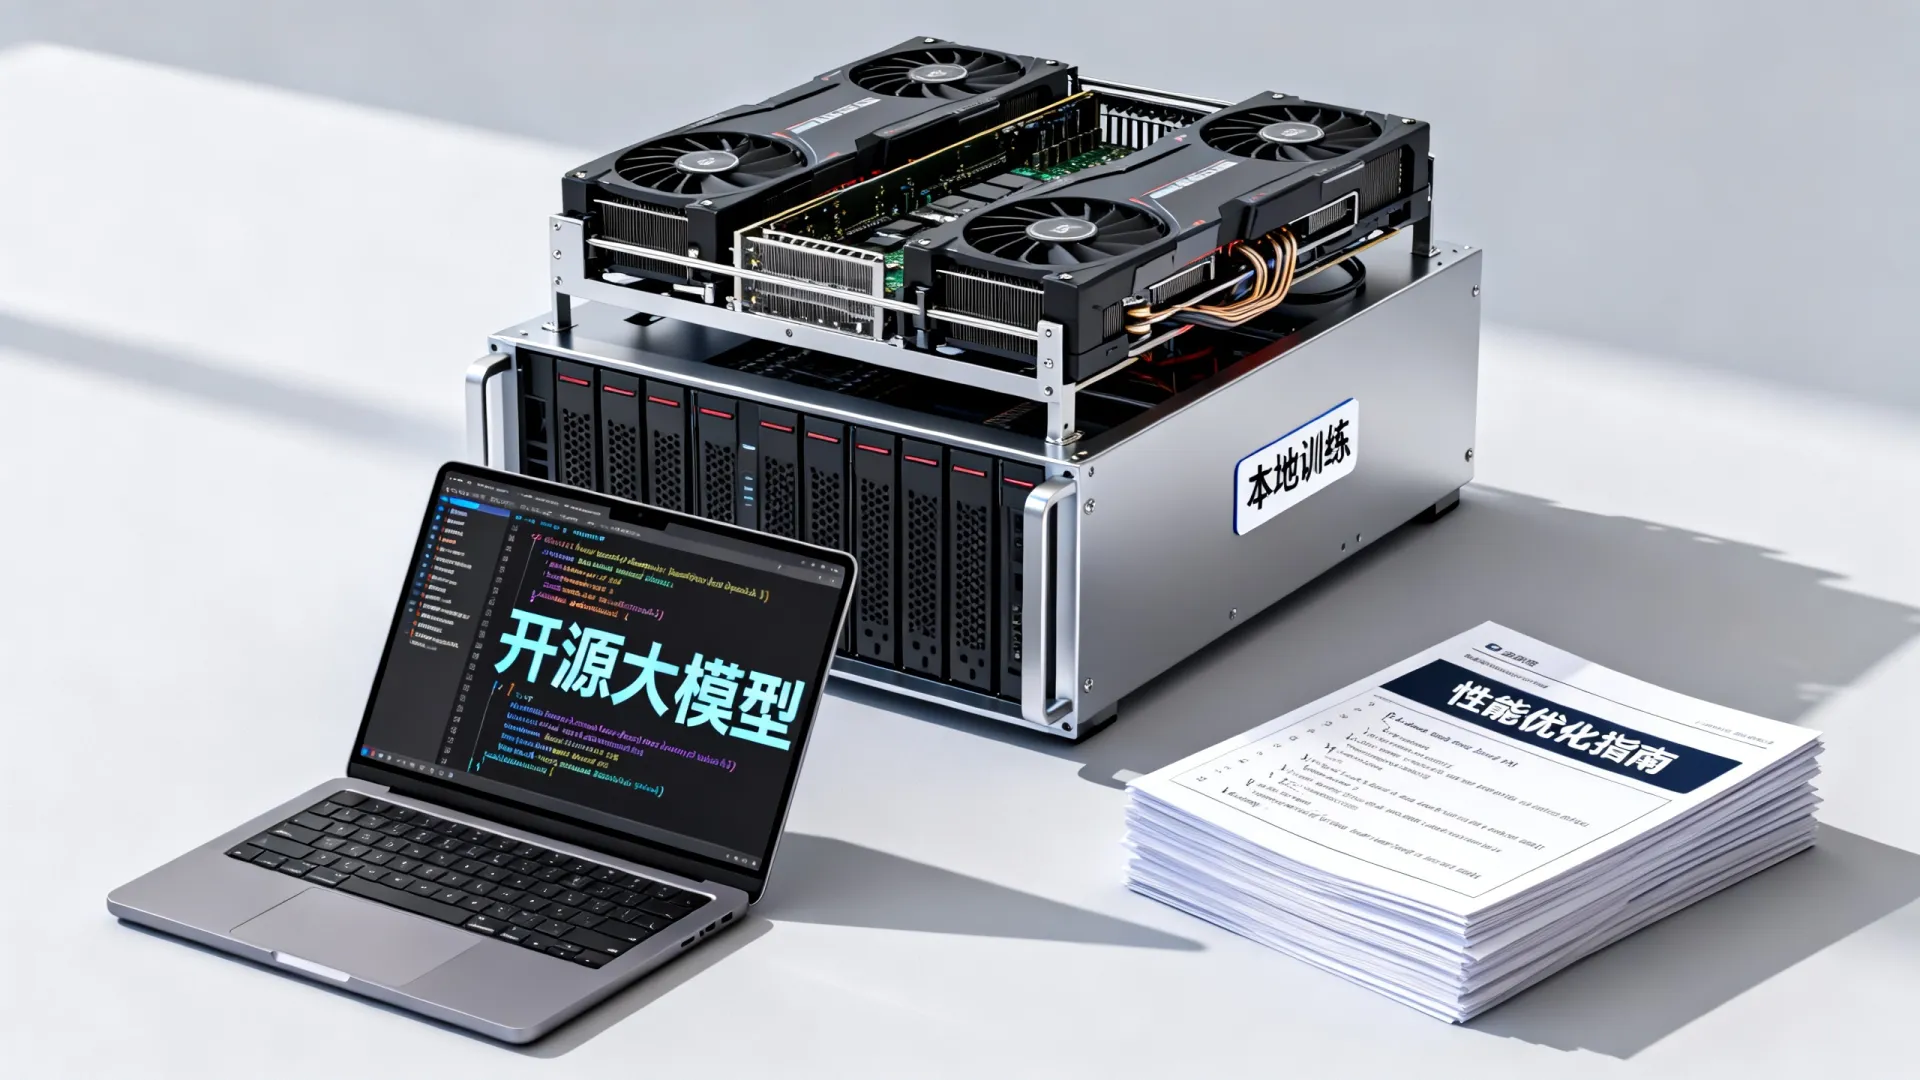
本地训练开源大模型怎么样?消费者真实评价中,关于效果的吐槽最为集中,许多人误以为“训练”就能让模型变聪明,实则不然。
-
微调并非万能药
微调主要用于注入领域知识或调整说话风格,而非提升逻辑推理能力。- 灾难性遗忘: 有用户反馈,在特定数据集上微调后,模型虽然学会了专业术语,却忘记了通用的语言组织能力,甚至丧失了基本的指令遵循能力。
- 效果不如API: 对于普通消费者,OpenAI或Claude等商业API经过海量数据训练和RLHF(人类反馈强化学习)对齐,综合体验远超本地未经对齐的开源模型。
-
量化带来的精度损失
为了在有限显存中运行,消费者往往被迫使用量化技术(如4-bit、8-bit量化)。- 体验下降: 虽然量化降低了门槛,但模型智商会出现明显滑坡,表现为逻辑混乱、幻觉增加,消费者评价中常提到:“本地跑起来的模型,感觉像是个‘降智版’。”
独特价值:为何仍有用户坚持本地化?
尽管困难重重,但在特定场景下,本地训练开源大模型依然具有不可替代的价值,这也是核心用户群体坚持留存的原因。
-
数据隐私与安全合规
这是本地部署最核心的护城河。- 企业级需求: 涉及医疗、法律、金融等敏感数据的机构,无法将数据上传至云端API。
- 个人隐私: 部分极客用户不希望个人笔记、生活数据被第三方获取,本地训练实现了真正的“数据不出域”。
-
高度定制化的可能
商业API往往无法满足极其个性化的需求。- 角色扮演: 本地训练可以精准控制模型的语气、口癖,打造独一无二的AI伴侣。
- 垂直领域深耕: 针对特定古汉语研究、小众编程语言,本地投喂专业数据进行训练,效果往往优于通用大模型。
专业解决方案:给消费者的务实建议
综合E-E-A-T原则,针对想要尝试本地训练开源大模型的消费者,我们提出以下分级建议:
-
入门级用户:优先选择“本地推理+云端API”
如果没有24GB以上显存的显卡,不建议尝试训练,直接使用Ollama等工具加载现成的量化模型进行推理体验,或直接购买API服务,性价比最高。 -
进阶级用户:采用LoRA/QLoRA微调技术
不要尝试全量微调,利用LoRA(低秩适应)技术,仅需少量显存即可对模型进行轻量化改造。- 工具推荐: 使用LLaMA-Factory等图形化界面工具,可以规避复杂的代码命令,大幅降低上手难度。
-
硬件投资策略
若决定入坑,硬件选择应遵循“显存优先”原则。- 性价比之选: 二手RTX 3090 (24GB) 是目前的入门金标准。
- 土豪方案: RTX 4090 (24GB) 或多卡互联,能覆盖绝大多数7B-13B模型的微调需求。
回答“本地训练开源大模型怎么样?消费者真实评价”这一问题,答案清晰可见:这是一场属于极客的硬核游戏,而非普通消费者的便捷工具。 它需要用户具备跨学科的知识储备(硬件、Linux系统、Python编程、深度学习理论)以及充足的预算支持,对于追求实用主义的用户,云端API是更优解;而对于追求数据主权与技术探索的玩家,本地训练带来的成就感与定制自由度,是商业软件无法比拟的。
相关问答
普通家庭电脑能进行大模型训练吗?
普通家庭电脑(指核显或入门级独显笔记本)基本无法进行有效的模型训练,甚至连推理都极其卡顿,大模型训练对显存带宽和容量有极高要求,如果仅有CPU和核显,建议使用云端平台(如Google Colab或AutoDL)租赁显卡进行体验,或者直接使用在线API服务,不要强行在低配电脑上尝试,既浪费时间又损耗硬件。
本地训练开源大模型和直接使用ChatGPT相比有什么优势?
主要优势在于数据隐私可控和高度定制化,ChatGPT等商业模型数据需上传至云端,且模型行为被厂商严格限制,本地训练允许你将私人数据、企业机密文档投喂给模型,且模型完全听从你的指令,不会产生内容审查限制,适合构建私有知识库或特定风格的AI助手。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/80538.html