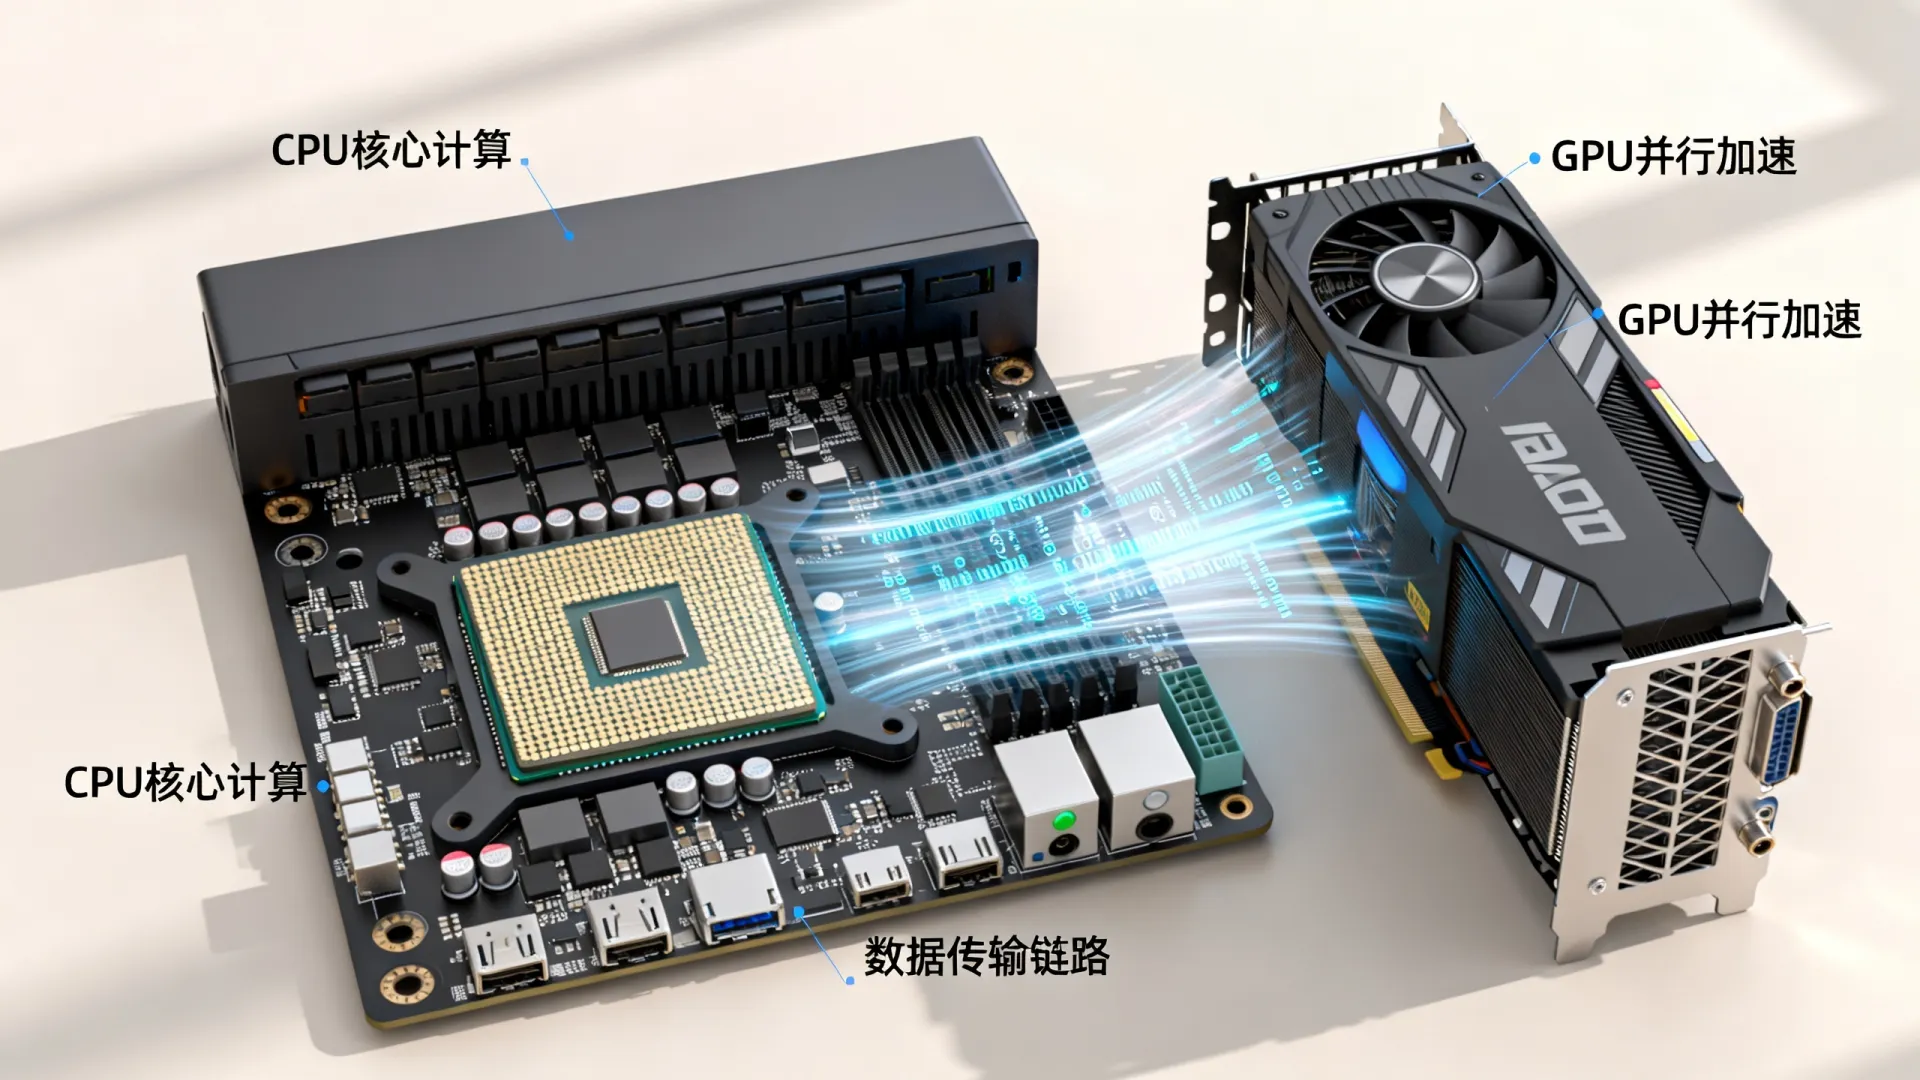
大模型在推理与训练阶段的资源调度,本质上是一场关于“计算密集”与“逻辑控制”的分工协作。核心结论非常明确:GPU负责高强度的并行计算,CPU负责任务调度与数据预处理,两者的协同工作并非深不可测的黑盒,而是一套逻辑严密的流水线工程。 只要理清数据流向与算力分配的边界,大模型实现cpugpu使用,没你想的复杂,通过合理的配置与优化,完全可以在有限的硬件资源下释放最大性能。
算力分工的本质逻辑
理解大模型运行机制的第一步,是拆解CPU与GPU的职能边界,这并非简单的“强与弱”之分,而是“通与专”的协作。
-
CPU:系统的“指挥官”。
CPU拥有强大的分支预测与逻辑控制能力,在大模型运行中,CPU不直接参与庞大的矩阵运算,而是承担着至关重要的“管家”角色。- 任务调度: 负责接收推理请求,管理进程优先级。
- 数据预处理: 对输入文本进行Tokenization(分词),将自然语言转化为模型可理解的数字序列。
- 后处理: 将GPU输出的数字序列还原为文本,并进行格式化输出。
-
GPU:算力的“特种兵”。
GPU的设计初衷就是处理图形图像中的大规模并行运算,这与神经网络的矩阵乘法有着天然的契合。- 矩阵运算: 大模型的核心是Transformer架构,涉及海量的矩阵乘法与加法运算,GPU拥有数千个计算核心,能够同时处理这些高度并行的任务。
- 显存管理: 模型权重、KV Cache(键值缓存)均存储在显存中,GPU直接调用显存数据进行计算,避免了低速内存带宽的瓶颈。
推理阶段:从显存加载到计算输出的全流程
在实际应用中,大模型的推理过程是CPU与GPU交互最频繁的场景。理解这一流程,是掌握资源优化的关键。
-
模型加载阶段。
当启动一个大模型服务时,CPU首先从硬盘读取模型权重文件,CPU作为I/O控制器,将数据通过PCIe总线传输至GPU显存。显存容量是此时的硬性门槛,如果模型参数量超过显存容量,加载将直接失败,或必须依赖CPU内存进行卸载,但这会严重拖慢推理速度。 -
Prompt预处理阶段。
用户输入Prompt后,CPU迅速介入。- 执行分词操作,将文本转化为Token ID序列。
- 分配显存空间,准备接收计算结果。
- 向GPU发送计算指令。
-
Prefill(预填充)与Decode(解码)阶段。
这是GPU算力消耗的高峰期。- Prefill: GPU一次性处理用户输入的所有Token,生成初步的KV Cache,这一阶段属于计算密集型,GPU利用率瞬间飙升。
- Decode: 模型逐个生成后续的Token,这是一个“访存密集型”过程,每生成一个字,GPU都需要读取庞大的KV Cache。此时显存带宽往往比算力更限制速度。
训练阶段:分布式环境下的协同进化
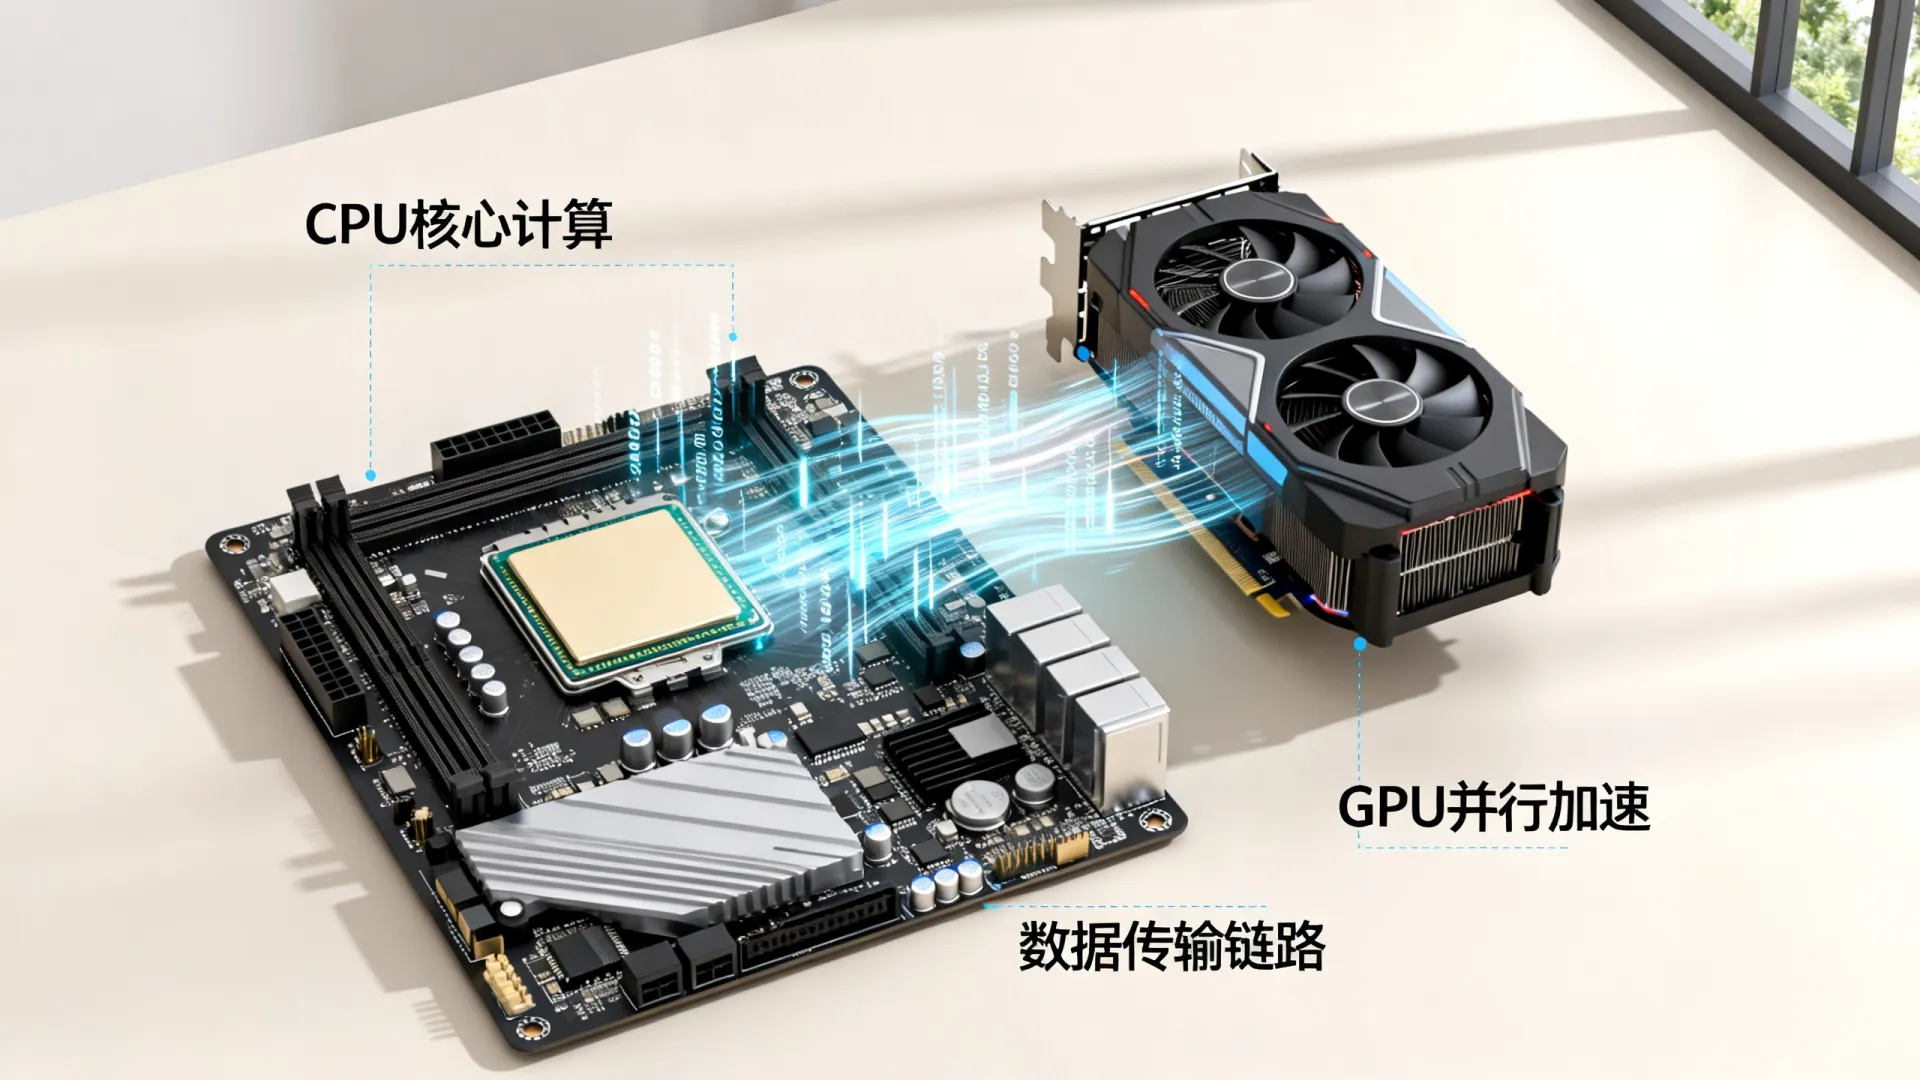
相比推理,训练过程更为复杂,但逻辑架构依然清晰,训练不仅是计算,更是数据的吞吐与梯度的同步。
-
数据吞吐瓶颈。
在训练中,CPU负责从海量数据集中读取、清洗、增强数据。如果CPU处理数据的速度跟不上GPU的计算速度,GPU就会处于“空转”等待状态,造成算力资源的极大浪费。 高性能训练服务器通常配备多核高频CPU,以确保数据供给。 -
梯度同步与通信。
在多卡或多机训练中,GPU之间需要频繁同步参数梯度,虽然这主要依赖NVLink或InfiniBand网络,但CPU仍负责协调通信进程,监控节点健康状态。CPU的延迟处理能力直接影响分布式训练的线性加速比。
核心优化策略:打破性能瓶颈
要让大模型跑得更快、更稳,必须针对CPU和GPU的特性进行针对性优化,以下是经过验证的专业解决方案:
-
量化技术的应用。
降低模型精度是降低显存门槛的最有效手段,将FP16(16位浮点)模型量化为INT8甚至INT4,能大幅减少显存占用,同时降低PCIe传输压力。这使得在消费级显卡上运行大模型成为可能。 -
KV Cache优化。
在长文本推理中,KV Cache占用显存极大,采用PagedAttention技术(如vLLM框架),将KV Cache分页存储,显存利用率可提升至90%以上,有效解决显存碎片化问题。 -
算子融合。
通过CUDA编程优化,将多个小的计算操作合并为一个大的核函数,减少GPU与CPU之间的交互次数。每一次CPU向GPU发送指令都有开销,减少交互次数即提升整体吞吐。 -
异构计算卸载。
当显存不足时,可利用CPU内存进行模型卸载,虽然速度较慢,但通过流水线并行技术,可以在CPU计算与GPU计算之间通过重叠掩盖部分延迟,这是一种以时间换空间的妥协策略。
硬件选型的黄金法则
在部署大模型时,硬件选型往往决定了项目的成败。
-
显存优先原则。
对于推理服务,显存容量是第一指标。显存决定了你能跑多大的模型,算力决定了你跑得有多快。 运行70B参数的模型,至少需要40GB以上的显存容量。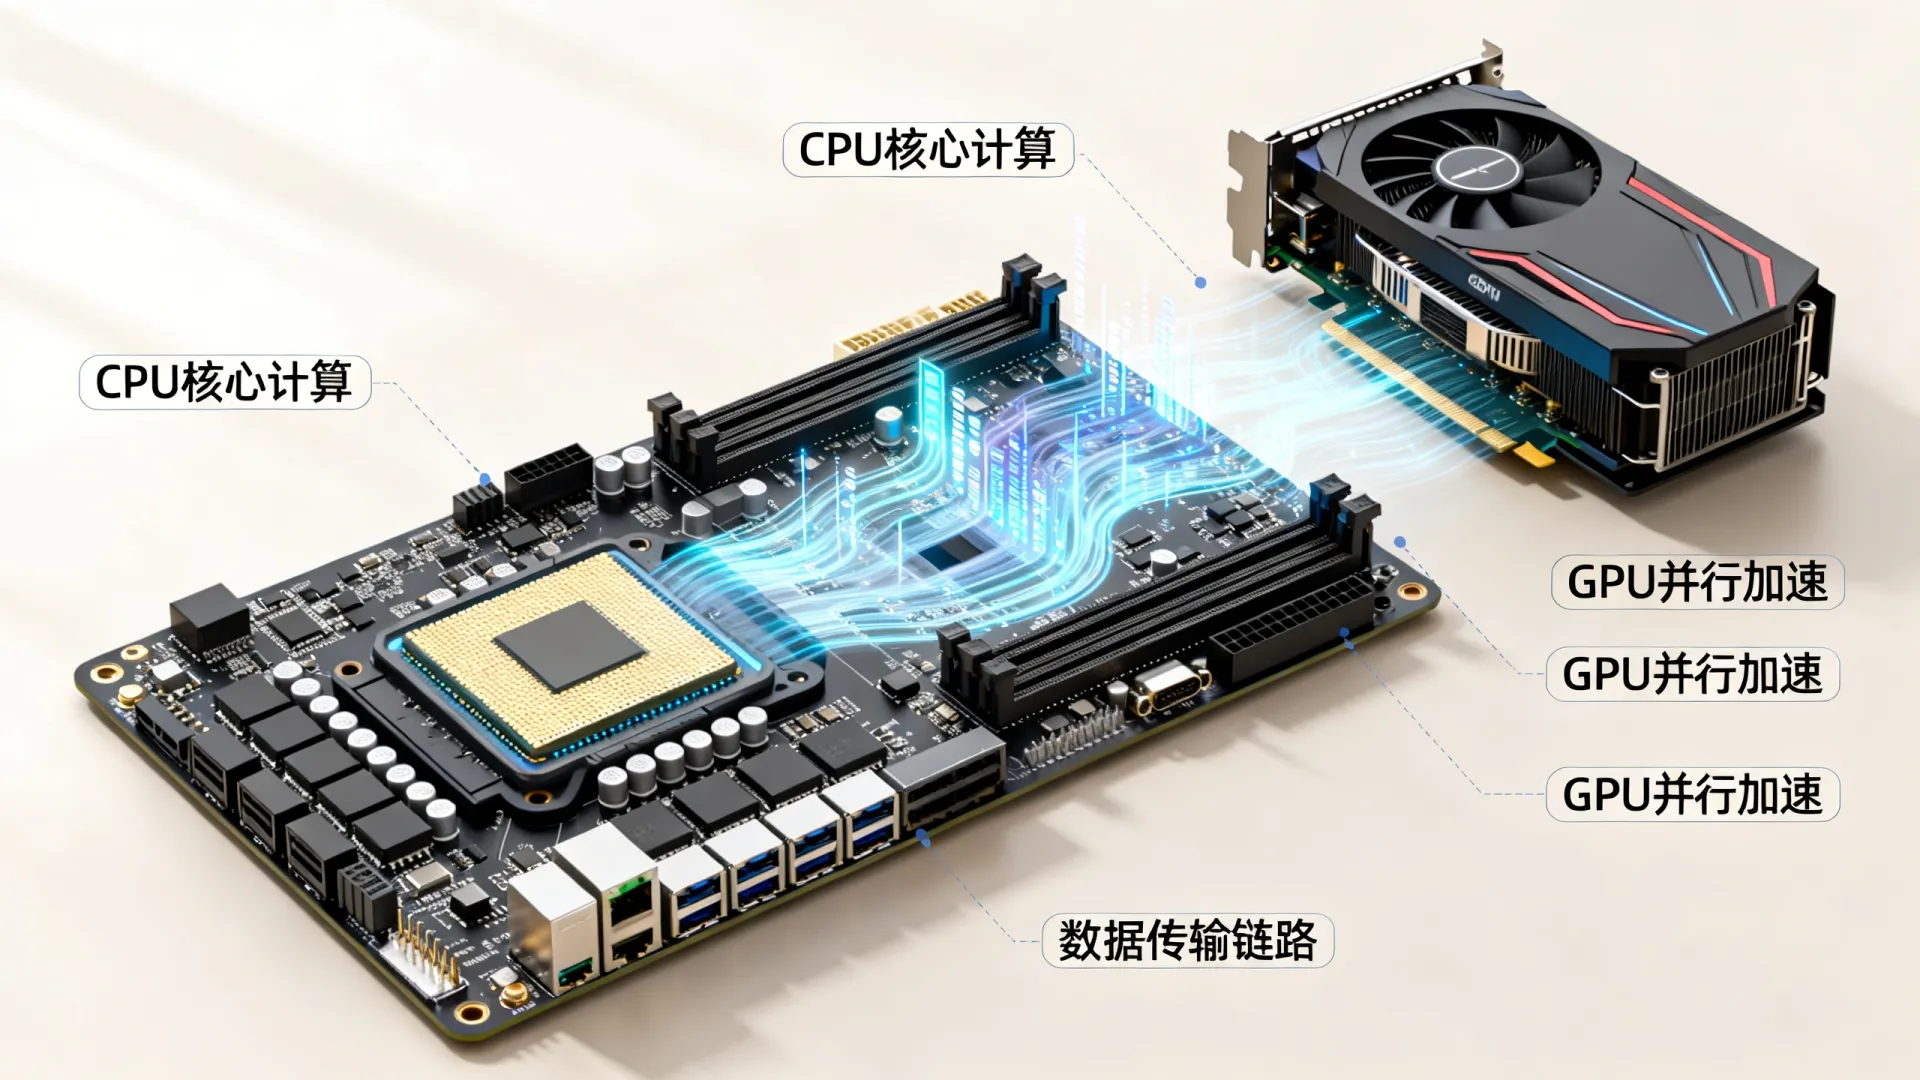
-
PCIe带宽考量。
CPU与GPU之间的通信通道PCIe,其带宽直接影响模型加载速度与多卡通信效率,选择支持PCIe 4.0或5.0的CPU与主板,能有效减少数据传输延迟。 -
AVX-512指令集。
对于必须在CPU上运行的场景(如边缘设备),选择支持AVX-512指令集的CPU能显著提升向量运算效率,虽然比不上GPU,但这已是CPU推理的极致优化路径。
大模型实现cpugpu使用,没你想的复杂,其核心在于精准的分工与高效的协同,通过理解数据在两者之间的流转逻辑,并应用量化、算子融合等优化手段,开发者完全可以构建出高性能、低成本的AI应用架构。
相关问答
在显存不足的情况下,是否可以使用系统内存(RAM)来运行大模型?性能损失有多大?
解答: 可以,这被称为“模型卸载”技术,当显存不足以容纳整个模型时,可以将部分层卸载到CPU内存中运行,性能损失非常显著,由于PCIe总线的带宽远低于GPU显存带宽,且CPU的计算速度远低于GPU,推理速度可能会下降10倍甚至更多,这种方式通常仅适用于对延迟不敏感的离线推理任务,不建议用于实时交互服务。
为什么在监控大模型推理时,GPU的利用率有时会很低?
解答: GPU利用率低通常并非GPU性能不足,而是受到了其他瓶颈的制约,主要原因包括:1. CPU预处理瓶颈,CPU分词速度跟不上GPU计算速度;2. 内存带宽瓶颈,数据传输通道拥堵;3. 批处理大小过小,GPU处于“吃不饱”状态,解决方案包括优化数据预处理流水线、增加Batch Size或使用更高效的后端框架如TensorRT-LLM。
如果你在部署大模型时遇到过具体的硬件兼容性问题,欢迎在评论区分享你的解决方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/78099.html