盘古大模型结构解析复杂吗?一文看懂盘古大模型架构

盘古大模型的核心架构并非遥不可及的黑盒技术,其本质是基于Transformer解码器架构的深度优化版本,通过层叠式的注意力机制与前馈神经网络,实现了对海量数据的极致压缩与生成。理解盘古大模型,关键在于把握其“编码器-解码器”的取舍、位置编码的创新以及注意力机制的稀疏化处理,这些设计共同构成了其强大的泛化能力。

一篇讲透盘古大模型结构解析

架构基石:Transformer解码器的深度演进

盘古大模型并没有重新发明轮子,而是站在了Transformer的肩膀上。

  1. 单向注意力的因果性:与BERT等双向编码模型不同,盘古大模型主要采用解码器架构,这意味着在处理输入序列时,模型只能看到当前词及其之前的词,这种“从左到右”的单向注意力机制,赋予了模型强大的文本生成能力,而非简单的文本理解。
  2. 深层堆叠与非线性变换:通过数十层甚至上百层的网络堆叠,模型能够捕捉从词法、句法到语义的深层特征,每一层的自注意力机制负责建立词与词之间的全局联系,而前馈神经网络则负责特征的映射与提取。
  3. 架构选择的必然性:选择解码器架构是经过深思熟虑的,对于生成式任务而言,解码器能够更自然地预测下一个token,这种架构选择使得盘古大模型在续写、创作等任务上表现出天然的优势。

核心突破:旋转位置编码与注意力优化

在庞大的参数规模下,传统的Transformer架构面临计算效率与长序列处理的瓶颈,盘古大模型通过技术创新解决了这一难题。

  1. 旋转位置编码:这是盘古架构中的一大亮点,传统的绝对位置编码或相对位置编码在处理超长文本时往往力不从心。RoPE通过旋转向量的方式,将位置信息注入到注意力计算中,使得模型能够自然地捕捉相对位置信息,且具有良好的外推性,即训练时未见过的长序列也能保持较好的处理效果。
  2. 注意力机制的稀疏化:随着模型规模的扩大,标准注意力机制的复杂度呈平方级增长,盘古大模型引入了稀疏注意力机制,限制每个token只关注部分关键token,在保证模型性能不降级的前提下,大幅降低了计算复杂度,实现了线性时间复杂度的突破。
  3. 并行计算优化:为了应对千亿级参数的训练,盘古在底层算子层面进行了深度优化,利用张量并行与流水线并行技术,将大模型拆解到数千张GPU上进行协同计算,解决了显存墙与通信墙的问题。

训练策略:数据驱动的智能涌现

架构只是骨架,数据与训练策略才是模型的灵魂,盘古大模型的强大能力源于其独特的训练范式。

一篇讲透盘古大模型结构解析

  1. 海量数据的清洗与注入:模型训练使用了TB级别的高质量中文及多语言数据。数据清洗算法去除了低质量、重复及有害信息,确保了模型“吃”进去的是高营养的数据,这是模型具备高准确性与逻辑性的基础。
  2. 自监督学习的掩码策略:类似于GPT系列,盘古采用了预测下一个词的自监督学习目标,这种看似简单的任务,迫使模型学习语法、常识乃至逻辑推理能力,当数据量与参数量突破临界点时,便产生了“智能涌现”。
  3. 微调与对齐:在预训练之后,模型经历了指令微调与人类反馈强化学习(RLHF),这一过程将模型的原始能力对齐到人类的使用习惯上,使其不仅能“懂”,还能“听懂指令”。

深度解析:为何说没你想的复杂?

很多人被千亿参数吓退,一篇讲透盘古大模型结构解析,没你想的复杂,其核心逻辑可以归纳为“概率预测”与“特征提取”的循环。

  1. 概率预测的本质:无论模型多么庞大,其最终输出都是一个概率分布,模型根据上下文,计算词表中每个词作为下一个词的概率,通过采样策略生成文本,理解这一点,就掌握了破解大模型黑盒的钥匙。
  2. 特征空间的映射:模型将现实世界的语言、图像等信息映射到高维向量空间,在这个空间中,语义相近的词距离更近,模型通过矩阵运算在这个空间中进行“推理”,这种数学本质并未超出线性代数的范畴。
  3. 工程与算法的平衡:盘古大模型的成功,一半归功于算法架构的创新,另一半归功于工程系统的搭建,理解了这一点,就能明白大模型并非纯粹的算法魔法,而是系统工程与数学模型的完美结合。

应用价值与行业赋能

架构的优越性最终体现在应用层面,盘古大模型通过模块化的设计,能够快速适配不同行业场景。

  1. 泛化能力的释放:得益于其强大的架构设计,盘古在少样本学习甚至零样本学习上表现优异,无需大规模微调即可适应新任务。
  2. 多模态的融合:架构的可扩展性使得盘古不仅能处理文本,还能通过特定的编码器接入图像、气象等数据,实现跨模态的理解与生成,为气象预测、药物研发等科学领域提供了全新的解题思路。

相关问答

盘古大模型与GPT系列在架构上有什么主要区别?

一篇讲透盘古大模型结构解析

盘古大模型与GPT系列在基础架构上都采用了Transformer解码器结构,核心区别在于位置编码策略与注意力机制的优化细节,盘古大模型针对中文语境及多模态场景进行了深度定制,特别是在旋转位置编码的应用上,使其在处理长序列中文文本时具有更好的上下文感知能力,盘古在训练数据的配比与清洗策略上更侧重于中文语义的深度理解,这使得其在中文生成与理解任务上往往表现出更符合本土习惯的特性。

为什么盘古大模型能够处理如此长的文本,其架构原理是什么?

盘古大模型处理长文本的能力主要归功于其采用的旋转位置编码与稀疏注意力机制,传统的位置编码在序列长度超过训练长度时性能会急剧下降,而RoPE通过旋转矩阵的特性,使得位置编码具有良好的外推性,稀疏注意力机制避免了模型对全序列进行昂贵的点积计算,通过局部与全局注意力的结合,在保持长距离依赖捕捉能力的同时,大幅降低了显存占用与计算量,从而支持了长文本的高效处理。

如果您对盘古大模型的具体技术细节有更深入的见解,欢迎在评论区留言交流。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/76583.html

赞 (0)
n710开发者选项在哪,三星n7100如何打开开发者选项
上一篇 2026年3月9日 06:58
海外三网优化Kuroit怎么样?AMD EPYC 9004性能如何
下一篇 2026年3月9日 07:04

相关推荐

  • 服务器学生价如何购买,学生云服务器在哪买最划算

    2026年购买服务器学生价的核心路径是:锁定阿里云、腾讯云、华为云等头部厂商的“高校专属认证通道”,完成实名与学生双认证,在特定促销周期内抢购轻量应用服务器,最低年费可控制在38元至99元区间,2026年学生服务器选购核心逻辑为什么学生认证是破局关键?普通云服务器对新用户的首购优惠已大幅缩水,而“学生机”是厂商……

    2026年4月28日
    6800
  • 封装成员变量在面向对象中如何实现,有哪些注意事项

    封装成员变量是面向对象编程中实现数据隐藏和保护的核心手段,通过将成员变量设为私有并借助公有方法间接访问,从而有效控制数据访问权限、提升代码可维护性与安全性,封装成员变量到底是什么意思?很多初学者看到“封装成员变量”这个词会一头雾水,其实它描述的就是一个很直观的操作:把类内部的变量藏起来,不让外部直接触碰,只能通……

    2026年8月6日
    600
  • 人人精通大模型是真的吗?普通人如何快速学会大模型

    当下“大模型专家”泛滥成灾,但这股热潮背后充斥着浮躁与误导,核心结论非常直接:绝大多数所谓的“精通”,仅仅停留在提示词工程的表层应用,而非真正的技术掌控, 企业和个人若想在大模型时代真正获益,必须剥离“人人皆可速成”的幻想,从工具属性出发,回归业务场景,建立理性的技术认知与落地路径,真正的精通,是理解底层逻辑……

    2026年3月15日
    12900
  • 大模型算力优化怎么做?深度了解后的实用总结

    大模型算力优化的核心在于实现计算效率与模型性能的完美平衡,通过系统级的软硬件协同优化,可显著降低训练与推理成本,提升资源利用率,深度了解大模型算力优化后,这些总结很实用,它们并非单一技术的堆砌,而是涵盖了从算法层、框架层到硬件层的全链路工程实践,掌握这些关键策略,能有效解决算力瓶颈问题,算法层优化:从模型结构源……

    2026年3月27日
    13200
  • 服务器总掉线,用CDN可以解决吗,怎么解决?

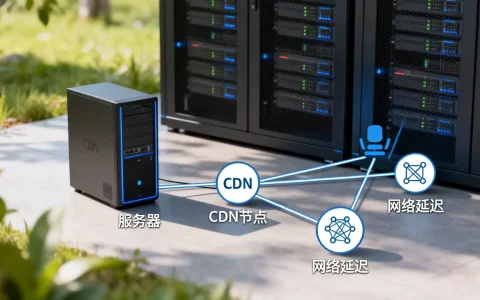
    服务器掉线用CDN能解决,但前提是得先搞清楚掉线的真正原因,CDN不是万能药,它对网络拥堵、带宽耗尽、部分DDoS攻击导致的掉线效果立竿见影,但对服务器本身硬件故障、程序死锁、后端数据库崩溃等问题毫无作用,服务器总掉线cdn能解决吗?先拆解掉线本质服务器掉线,听起来是一个现象,但背后原因千差万别,CDN的全称是……

    2026年7月24日
    1300
  • CDN只加速首页怎么办?CDN只加速首页怎么设置

    CDN只加速首页会导致全站性能断层,正确做法是配置全站静态资源加速或开启智能边缘缓存,确保图片、CSS、JS及动态接口均得到优化,从而提升整体用户体验与SEO排名,很多站长在搭建网站时,常误以为只要首页加载快,用户就会满意,这种想法在2026年的搜索引擎算法面前显得过于天真,百度SEO早已从单一的页面速度指标……

    2026年5月29日
    4400
  • 服务器安全模式怎么进入?,怎么退出安全模式

    服务器安全模式是系统内置的轻量级运行环境,用于诊断问题、修复错误或移除恶意软件,相比正常模式仅加载必要驱动和服务,服务器安全模式怎么设置?——Windows与Linux实操详解Windows Server安全模式进入方法主流Windows Server版本(2008 R2至2022)均支持以下方式:开机按F8……

    2026年7月23日
    2300
  • 设计软件大模型接入工具对比,哪个工具最好用?

    在AIGC技术爆发的当下,设计行业正经历着前所未有的效率革命,面对市面上琳琅满目的AI接入方案,盲目跟风极易导致工作流崩溃、数据泄露或成本失控,经过对主流工具的深度测评与实战验证,核心结论非常明确:不存在“全能神工具”,只有最适合特定工作流的“最优解”,选型决策应基于“稳定性、可控性、安全性、成本效益”四大维度……

    2026年4月10日
    9100
  • 服务器安全组多久生效?安全组规则配置后多久生效

    服务器安全组规则配置后通常在数秒至1分钟内生效,跨可用区或涉及复杂CIDR网段变更时最长延迟约3-5分钟,极端网络拥塞场景下上限为10分钟,安全组生效时间的底层逻辑与核心参数控制面与数据面的异步协同安全组本质是云平台虚拟网络层的分布式防火墙,当你修改规则时,操作指令首先在控制面下发,随后异步推送到宿主机数据面……

    2026年4月24日
    7900
  • 如何精准设定服务器响应时间,以达到最佳性能和用户体验?

    服务器响应时间怎么设定服务器响应时间(通常指TTFB – Time To First Byte)的理想设定目标是:保持在200毫秒以内, 这是用户体验流畅的分水岭,也是搜索引擎(如Google)衡量网站核心性能(Core Web Vitals)的关键指标之一,更优的目标是争取达到100毫秒或更低,这个目标并非随……

    2026年2月5日
    16930

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注