N卡SLI大模型技术的核心本质,实际上是通过多GPU并行计算架构,突破单卡显存与算力的物理瓶颈,很多技术人员认为搭建AI模型训练环境极其深奥,但剥开复杂的专业术语外壳,其底层逻辑并不晦涩。只要掌握显存池化与通信带宽这两个关键抓手,普通开发者也能构建高效的推理与训练集群,这并非高不可攀的黑科技,而是一套逻辑严密的工程解决方案,读完这篇内容,你会发现一篇讲透n卡sli大模型,没你想的复杂。

打破认知误区:从图形渲染到AI算力底座
很多资深玩家对SLI(Scalable Link Interface)的印象还停留在早期的图形渲染领域,认为它仅仅是两块显卡串联以提升游戏帧数,在AI大模型时代,SLI的概念已经发生了质的飞跃,在深度学习场景下,SLI不再单纯追求画面的同步输出,而是追求计算任务的分布式拆解与协同。
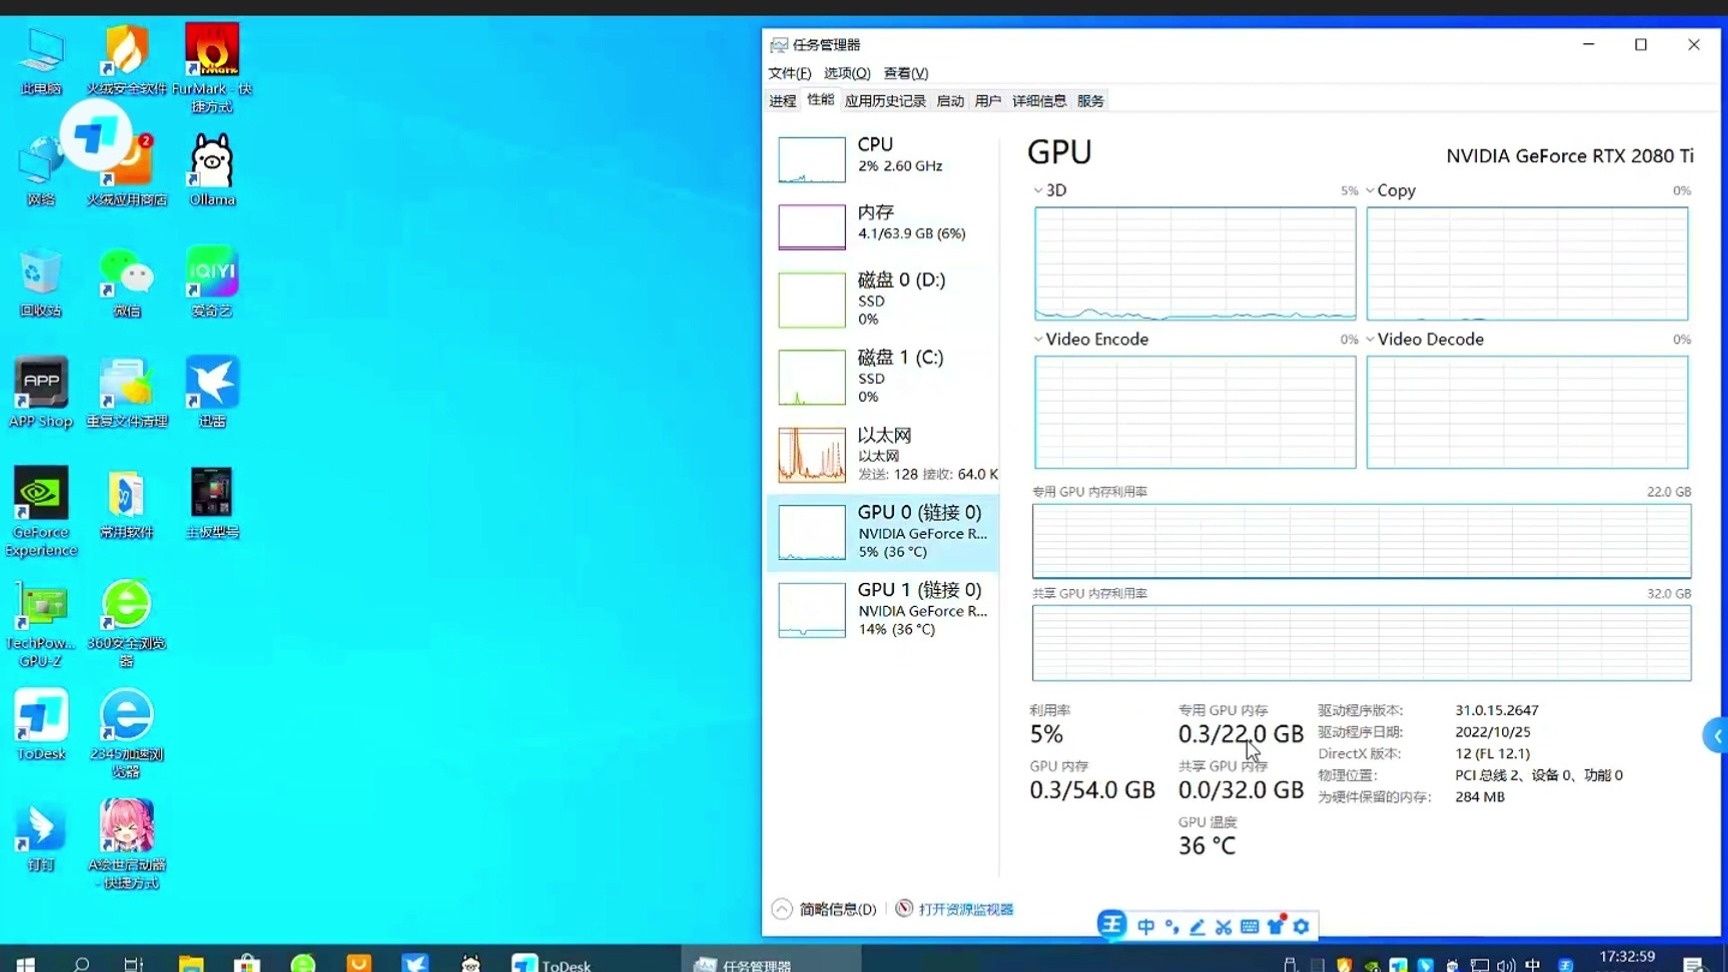
核心结论非常明确:N卡SLI在大模型应用中的最大价值,在于解决“显存墙”问题。 当模型参数量达到70B甚至更高时,单张消费级显卡(如RTX 4090的24GB显存)根本无法装载完整模型,通过SLI架构(广义上的多卡互联),将模型切片分布到多张显卡中,利用PCIe通道或NVLink进行参数同步,是实现低成本本地部署大模型的唯一路径。
技术架构解析:数据并行与模型并行的实战选择
要真正驾驭N卡SLI大模型,必须理解两种核心并行策略,这是决定系统效率的关键。
-
数据并行
这是最容易理解的架构,每张显卡都拥有模型的完整副本,但输入的数据不同。- 优势:架构简单,训练速度快,适合小模型的大批量数据处理。
- 劣势:显存占用极高,每张卡都要存一份完整模型,无法解决大模型显存不足的问题。
-
模型并行
这是大模型时代的“救星”,将一个巨大的模型“切开”,每一层或者每一个张量分散在不同的显卡上。- 流水线并行:显卡A处理第一层,传给显卡B处理第二层,以此类推,就像工厂流水线。
- 张量并行:将矩阵乘法拆解,多张卡同时计算同一层的不同部分。这是大模型推理最常用的方案,对通信带宽要求极高。
硬件搭建的三大核心要素
搭建一套稳定的SLI大模型环境,硬件选择必须遵循严谨的兼容性原则,避免资源浪费。
-
通信带宽是生命线
很多人尝试用普通的PCIe x4扩展卡连接多张4090,结果发现推理速度极慢,原因在于通信带宽成为了瓶颈,大模型在多卡之间传输参数量巨大,如果使用PCIe 3.0或4.0 x16带宽,甚至更低的通道,GPU大部分时间都在“等待数据”。- 解决方案:优先选择支持NVLink的显卡(如3090系列),或者服务器级的PCIe通道充足的CPU平台(如Threadripper或Xeon),确保每张卡都能跑满PCIe x16带宽。
-
显存容量的匹配原则
组建SLI大模型集群时,显存容量遵循“木桶效应”,如果一张卡是24GB,另一张是12GB,系统通常只能识别出12GB+12GB的有效显存池,甚至导致报错,建议使用完全相同型号、相同显存颗粒的显卡,以保证稳定性。
-
电源与散热系统
双卡或四卡并行意味着功耗的成倍增加,两张RTX 4090的瞬时功耗可能突破900W。- 电源配置:建议单卡单电源,或者使用1600W以上的服务器级电源。
- 散热方案:显卡之间需要保留物理空间,或者使用涡轮版显卡(Blower Style),将热量直接排出机箱,防止热量堆积导致降频。
软件生态配置:从驱动到框架
硬件连接只是第一步,软件层面的配置才是让N卡SLI大模型跑起来的关键。
-
驱动与CUDA环境
必须安装NVIDIA官方提供的最新Studio驱动或数据中心驱动,对于消费级显卡,CUDA Toolkit的版本要与PyTorch或TensorFlow框架严格对应。版本不匹配是90%报错的根源。 -
推理框架的选择
手写并行代码极其复杂,建议直接使用成熟的推理框架:- vLLM:目前最流行的开源推理框架,原生支持张量并行,只需简单参数即可启用多卡推理。
- llama.cpp :支持GGUF格式量化,通过
--tensor-split参数即可手动分配显存,适合消费级显卡组SLI。
-
NCCL库的优化
NCCL(NVIDIA Collective Communications Library)是多卡通信的核心,在Linux环境下,正确配置NCCL环境变量(如NCCL_P2P_DISABLE用于调试,NCCL_IB_DISABLE用于非InfiniBand网络)能显著提升多卡协同效率。
实战中的独立见解:消费级显卡的性价比陷阱
在深入研究N卡SLI大模型后,必须指出一个行业误区:盲目追求新卡并不划算。
对于大模型推理而言,显存容量大于算力速度,一张RTX 3090(24GB)二手价格远低于RTX 4090,但通过SLI技术,两张3090可以提供48GB显存,足以运行Llama-3-70B量化模型,而单张4090受限于24GB显存,甚至无法加载模型。在预算有限的情况下,多张上一代旗舰卡组建SLI集群,往往比单张顶级新卡更具实战价值。
常见故障排查与性能优化
在实际部署中,遇到问题在所难免,以下是三个高频问题的专业解决方案:
-
显存利用率不均
如果发现一张卡显存爆满,另一张卡闲置,通常是模型切分策略错误,检查推理框架是否开启了tensor_parallel模式,而非简单的data_parallel。
-
推理速度极慢
检查PCIe带宽,在Linux下使用lspci -vv命令查看链路状态,如果显示x8或x4,说明主板PCIe通道不足,这会严重拖累整体性能。此时应考虑减少显卡数量或更换服务器主板。 -
P2P通信失败
某些消费级主板不支持GPU直接的P2P通信,虽然不影响功能,但会降低速度,可以通过设置环境变量强制使用系统内存中转,虽然慢一点,但能保证程序跑通。
通过上述分析,我们可以清晰地看到,搭建N卡SLI大模型并非玄学,它是一套融合了硬件拓扑、操作系统配置与算法框架的系统工程,只要理清了数据流向与显存分配的逻辑,普通人也能低成本构建属于自己的AI算力中心,这正是一篇讲透n卡sli大模型,没你想的复杂所希望传达的核心价值:技术应当服务于应用,而非成为门槛。
相关问答
使用两张不同型号的N卡(如一张3090和一张4090)可以组建SLI运行大模型吗?
理论上不建议这样做,虽然部分推理框架(如llama.cpp)允许混合不同显存大小的显卡,但这会带来严重的性能短板效应,系统通常受限于最慢的那张卡或显存最小的那张卡,3090与4090的架构差异可能导致CUDA核心利用率不均,通信效率大打折扣,为了追求最佳的性能稳定性,强烈建议使用型号完全一致、显存完全一致的同批次显卡。
大模型推理时,是选择NVLink连接还是PCIe连接更好?
如果预算允许,NVLink绝对优于PCIe,NVLink提供了远超PCIe的带宽(如3090的NVLink带宽可达112.5GB/s,而PCIe 4.0 x16仅为32GB/s),这对于大模型推理中的层间参数传递至关重要,高带宽意味着显卡之间交换数据的延迟更低,能显著提升Token生成速度,如果是运行参数量较小的模型(如7B或13B),PCIe连接尚可接受;但对于70B以上的大模型,没有高速互联通道,推理速度会慢到难以忍受。
如果你在搭建多卡并行环境中有遇到过奇怪的报错,或者有更好的硬件搭配方案,欢迎在评论区分享你的经验。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/69235.html