本地编程大模型配置到底怎么样?本地部署大模型需要什么配置?

本地编程大模型配置的核心价值在于“数据隐私绝对安全”与“零延迟交互体验”,但这一切的前提是硬件投入与模型选型的精准匹配,对于大多数开发者而言,配置本地编程大模型并非简单的“下载运行”,而是一场在显存带宽、量化精度与代码生成质量之间的权衡博弈。结论先行:如果你拥有24GB显存以上的显卡,本地部署CodeLlama或DeepSeek-Coder等模型,完全能够替代GPT-3.5级别的云端助手,且在断网环境下依然保持高效生产力;但如果显存捉襟见肘,强行配置只会带来极差的体验,不如继续使用云端API。
本地编程大模型配置到底怎么样

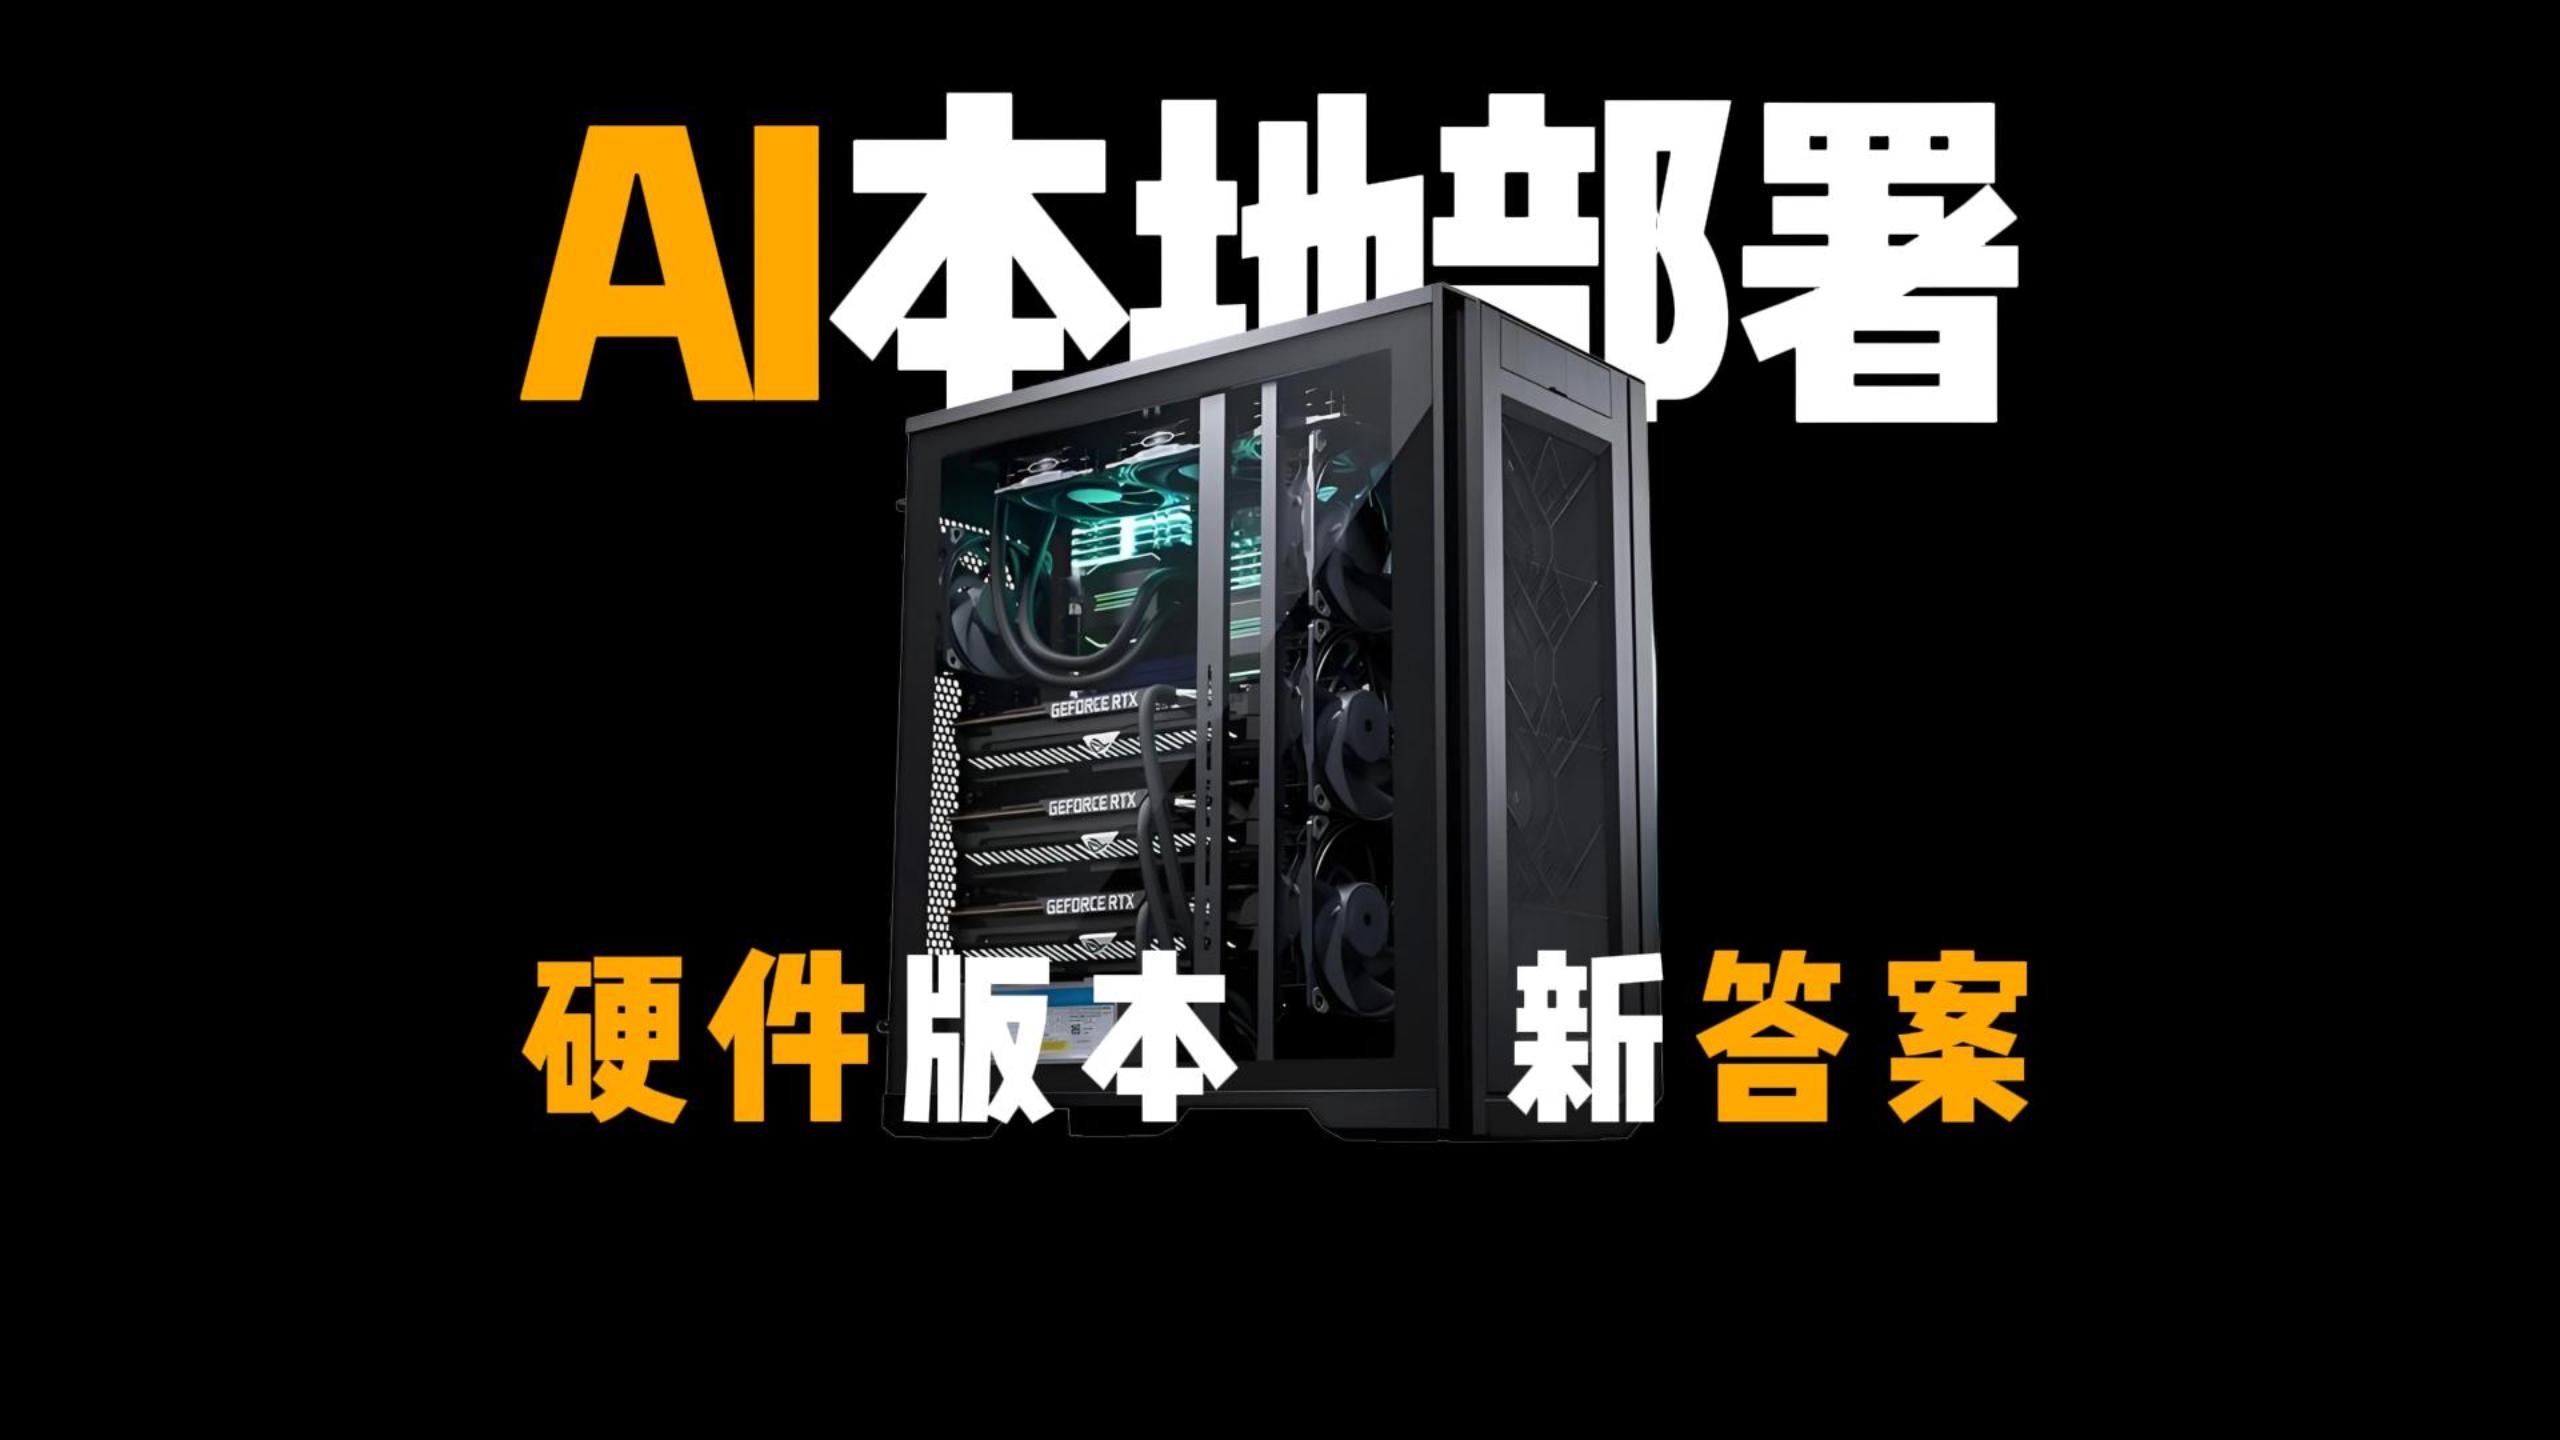
个人AI本地部署硬件版本新答案
加载中
个人AI本地部署硬件版本新答案

硬件门槛:显存是决定生死的硬指标

本地编程大模型配置到底怎么样?首先要过硬件关,很多开发者低估了运行大语言模型对显存的渴求程度。

  1. 显存容量决定模型上限。 模型参数量与显存占用呈线性关系,FP16精度的7B模型大约需要14GB显存,13B模型需要26GB。对于编程场景,13B参数量是“智能”与“资源”平衡的黄金分割点,低于此参数量的模型在理解复杂逻辑时经常“幻觉”频出。
  2. 量化技术是把双刃剑。 为了在消费级显卡上运行大模型,量化是必须手段,将FP16量化为4-bit,显存占用可缩减至原来的1/4,实测表明,4-bit量化后的模型在代码补全任务上性能损失微乎其微,但显存要求大幅降低,12GB显存即可流畅运行CodeLlama-34B。
  3. 内存带宽决定生成速度。 很多用户忽略了内存带宽,即使显存足够,如果带宽不足,生成代码的速度会慢如蜗牛。建议优先选择GDDR6X及以上规格的显卡,PCIe 4.0接口是标配,确保数据吞吐不成为瓶颈。

模型选型:代码专精模型完胜通用模型

在真实体验中,模型的选择直接决定了开发效率,通用模型(如Llama 3)虽然对话能力强,但在代码生成上远不如专用模型。

  1. DeepSeek-Coder表现惊艳。 在本地实测中,DeepSeek-Coder系列模型对中文指令的理解和代码生成的准确性极高。它支持数百种编程语言,且在项目级代码补全上表现出色,能够准确捕捉上下文依赖。
  2. CodeLlama生态成熟。 作为Meta推出的专用模型,CodeLlama拥有丰富的微调版本,特别是CodeLlama-Python版本,针对Python语法进行了深度优化,适合数据科学与AI领域的开发者。
  3. 推理框架的选择。 Ollama和LM Studio是目前最友好的部署工具,Ollama适合命令行爱好者,一行命令即可完成部署;LM Studio则提供了图形化界面,支持GGUF格式,让模型加载和卸载变得像打开软件一样简单。

实战体验:效率提升与局限并存
本地编程大模型配置到底怎么样

配置完成后的真实使用场景如何?这是开发者最关心的部分。

  1. 代码补全的“零延迟”快感。 本地模型最大的优势在于无网络延迟,配合VS Code的Continue插件,代码补全几乎是瞬时响应,这种流畅感是云端API无法比拟的,特别是在编写重复性高的样板代码时,Tab键的使用频率大幅增加。
  2. 复杂逻辑生成的差距。 必须承认,本地模型在处理超长上下文或复杂架构设计时,能力弱于GPT-4。当上下文超过4096 tokens,本地模型容易“遗忘”之前的指令,导致生成的代码出现变量名不一致或逻辑断层。
  3. 隐私安全的绝对护城河。 对于涉及核心算法、私有协议的商业项目,本地编程大模型配置提供了云端无法给予的安全感,代码不出内网,数据完全闭环,这对于金融、军工等敏感领域的开发团队至关重要。

优化策略:让本地模型更懂你

仅仅跑通模型是不够的,专业的配置需要针对性优化。

  1. 构建本地知识库(RAG)。 利用LlamaIndex等工具,将项目文档、API手册导入本地向量库。通过检索增强生成,让模型能够回答关于私有库的具体问题,大幅提升代码生成的可用性。
  2. 调整Temperature参数。 编程任务要求极高的确定性。建议将Temperature设置为0.1或0.2,减少模型的随机性,确保生成的代码逻辑严谨、可运行。
  3. FIM(Fill-In-the-Middle)模式。 启用FIM模式,让模型能够根据代码的前文和后文进行中间填充,而非仅仅从左向右生成。这对于函数内部逻辑修改、Bug修复场景极为有效。

成本效益分析:值不值得投入?

从经济角度看,本地编程大模型配置到底怎么样?
本地编程大模型配置到底怎么样

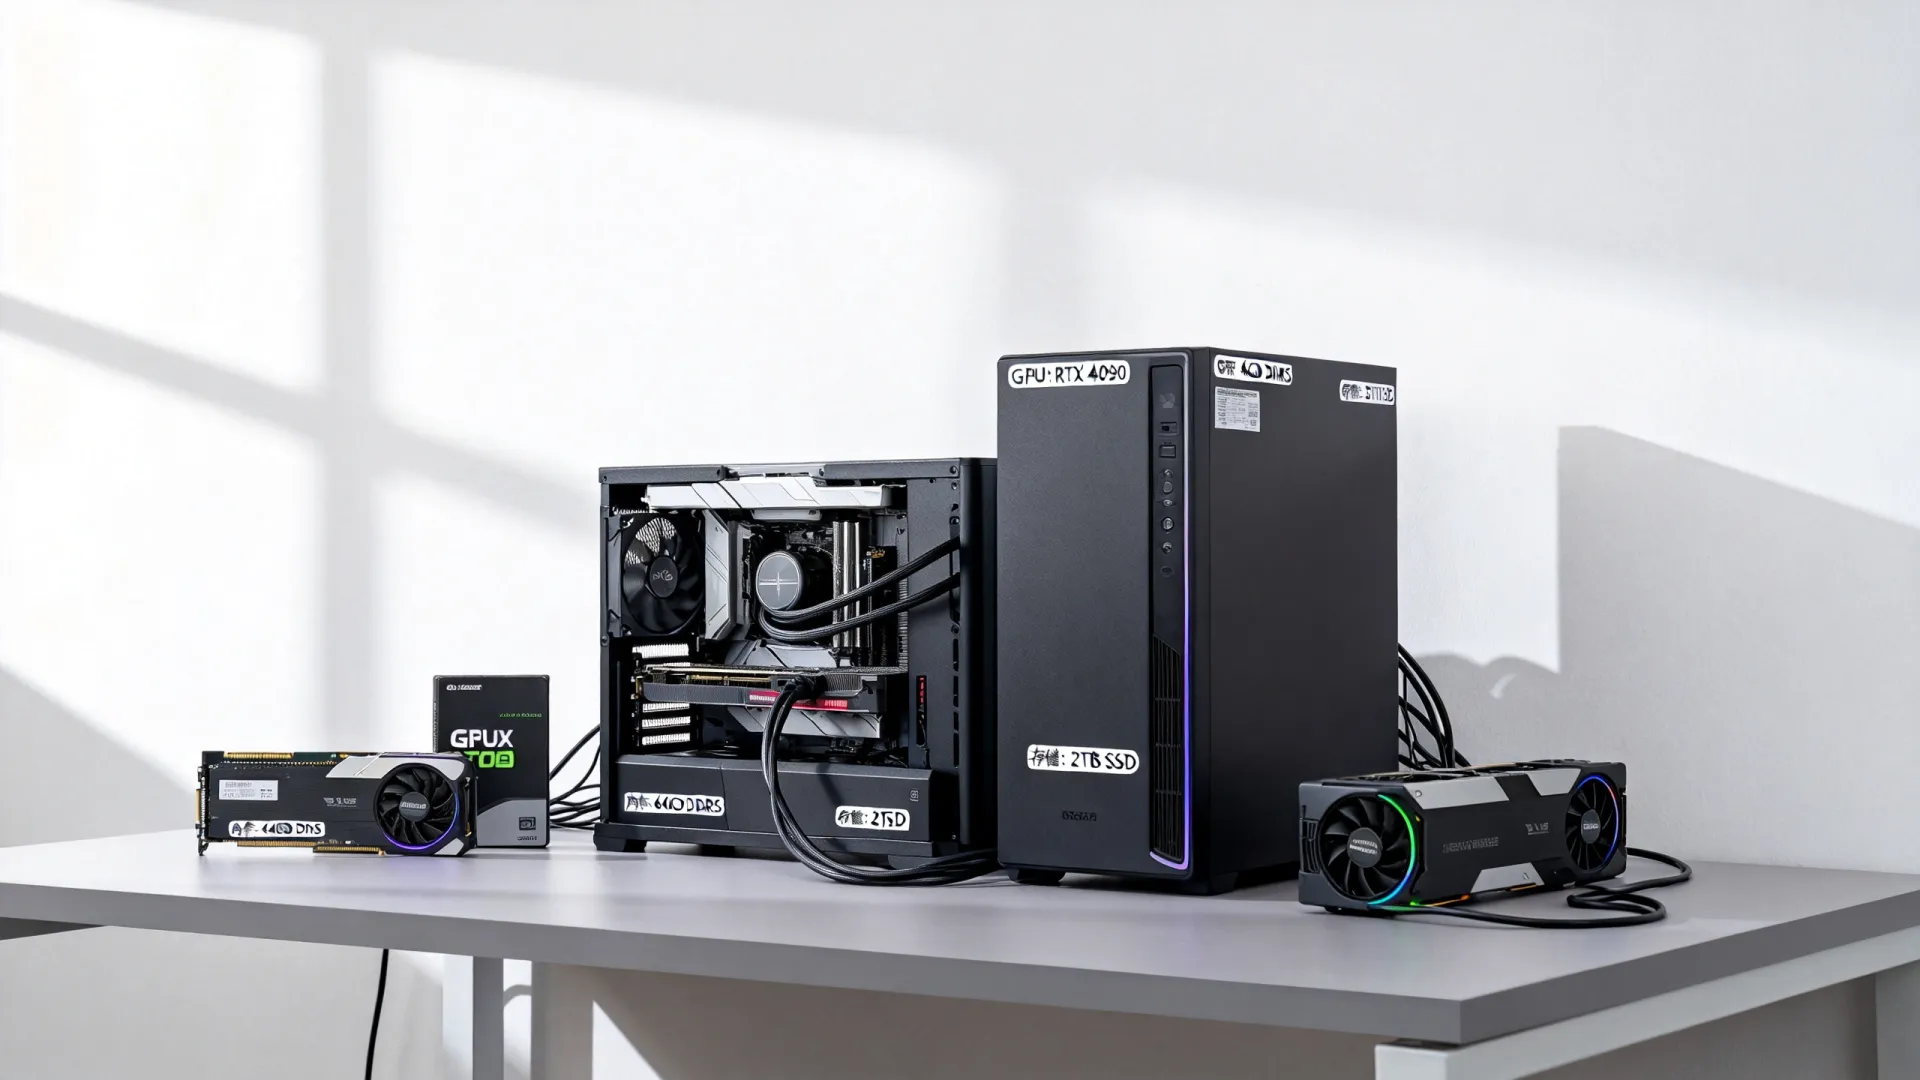
  1. 一次性投入与长期收益。 一张RTX 4090显卡价格不菲,但考虑到云端API的订阅费用,如果是高频使用者,约12-18个月即可收回硬件成本,且硬件本身仍具有残值。
  2. 电费与散热隐形成本。 高负载运行显卡功耗巨大,长期开启需要考虑电费支出和散热方案。建议在非工作时段关闭推理服务,或使用低功耗模式待机。

相关问答

没有高端显卡,能否在笔记本上配置本地编程大模型?
完全可以,但需要妥协,如果笔记本只有16GB或32GB统一内存(如MacBook M系列芯片),推荐使用量化后的7B或更小参数模型,虽然无法处理极其复杂的工程,但用于编写简单函数、正则表达式、SQL查询语句等日常任务依然绰绰有余,关键在于选择GGUF格式模型并配合Ollama运行,利用CPU和内存进行推理,速度虽慢但可用。

本地编程大模型生成的代码质量不如GPT-4,如何解决?
这是一个普遍现象,解决思路有三点:第一,优化Prompt(提示词),提供更详细的上下文和示例代码,引导模型理解意图;第二,采用“小模型+RAG”方案,通过外挂知识库弥补模型参数量的不足,让模型参考你提供的正确文档生成代码;第三,人机协作,不要指望模型一次性生成完美代码,将其作为“副驾驶”,由开发者负责架构和核心逻辑,模型负责填充细节和单元测试。

如果你也在尝试搭建本地编程环境,欢迎在评论区分享你的硬件配置和遇到的坑,我们一起交流避坑。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/67090.html

赞 (0)
海外三网优化Tiktok vps怎么样,DDR5大流量vps推荐
上一篇 2026年3月5日 03:21
高并发服务器带宽配置参考,高并发服务器需要多少带宽?
下一篇 2026年3月5日 03:28

相关推荐

  • cdn去中心化是什么原理?cdn去中心化有哪些优势

    CDN去中心化并非单纯的技术替代,而是通过Web3.0架构实现带宽成本降低、抗审查能力增强及节点收益共享的下一代内容分发方案,传统集中式CDN虽然成熟,但在面对大规模流量洪峰或特定区域网络波动时,往往显得力不从心,去中心化内容分发网络(DCDN)正在重塑这一格局,它利用区块链激励和P2P技术,让每个用户节点都成……

    2026年5月29日
    4000
  • 服务器安全培训怎么做?企业服务器安全防护培训课程哪家好

    2026年企业抵御数据勒索与合规处罚的终极防线,是建立基于零信任架构且全员参与的实战化服务器安全培训体系,2026服务器安全防御新态势威胁演进与合规双重施压根据国家计算机网络应急技术处理协调中心(CNCERT)2026年初发布的《网络安全威胁态势报告》,超过78%的严重数据泄露源于内部人员配置失误与意识盲区,攻……

    2026年4月27日
    5100
  • 阿里云国外CDN好用吗,阿里云国外CDN加速

    阿里云国外CDN通过全球2800+节点覆盖与智能调度算法,能有效解决跨境访问延迟问题,是2026年企业出海构建高性能网络基础设施的首选方案之一,阿里云国外CDN的核心优势与2026年技术演进在2026年的全球数字化浪潮中,跨境业务对网络稳定性的要求已远超“可用”范畴,转向“极致体验”,阿里云作为全球领先的云计算……

    2026年7月5日
    20800
  • 大模型GPU资源伸缩怎么操作?深度解析实用总结

    在大模型训练与推理的全生命周期中,GPU 资源伸缩并非简单的扩容或缩容,而是一场关于成本、性能与稳定性的精密博弈,核心结论在于:高效的 GPU 资源伸缩,必须建立在精准的负载预测与动态调度策略之上,其本质是将算力资源从“静态占有”转变为“动态按需使用”,从而在保障模型服务 SLA(服务等级协议)的前提下,最大化……

    2026年3月25日
    11500
  • 服务器和虚拟主机究竟有何紧密联系?它们之间的区别与依赖性解析。

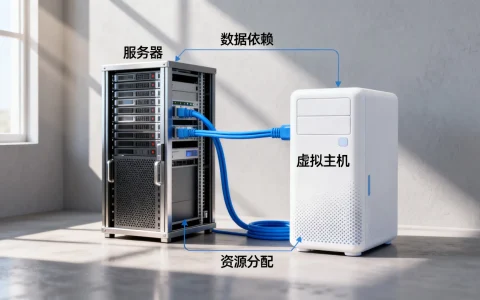
    服务器和虚拟主机的关系,核心在于:虚拟主机是构建在物理服务器基础之上,通过虚拟化技术将一台强大的物理服务器资源(如CPU、内存、存储空间、带宽)分割成多个相互独立、隔离的“虚拟空间”或“虚拟服务器”,每个虚拟主机用户租用的是这台物理服务器的一部分资源,用于托管自己的网站或应用, 简单比喻:服务器是一栋完整的大楼……

    2026年2月6日
    15830
  • cdn加速是什么?,cdn加速对网站优化有什么好处?

    CDN加速是2026年企业提升网站性能与用户体验的关键基础设施,选择方案需综合考虑节点覆盖、安全防护与成本效益,CDN加速的核心原理与2026年技术趋势分发网络)通过将源站内容缓存到全球分布的边缘节点,使用户请求就近获取资源,从而显著降低延迟,提升访问速度,2026年,CDN技术已从单纯的缓存加速升级为集边缘计……

    2026年7月23日
    400
  • 服务器如何实现弹性云?弹性云服务器是什么意思

    服务器实现弹性云的核心在于通过虚拟化与云编排技术,将底层计算、存储、网络资源池化,结合智能监控与自动化调度策略,实现业务负载与资源分配的秒级动态伸缩,从而彻底消除传统架构的性能瓶颈与资源浪费,弹性云的底层逻辑与核心架构资源池化:从物理孤岛到虚拟汪洋传统服务器如同孤岛,资源固化且难以流动,实现弹性云的首要步骤是打……

    2026年4月23日
    5900
  • 视频点播cdn加速是什么原理,视频点播cdn加速

    视频点播CDN加速的核心结论是:通过全球分布式节点缓存热门视频内容,将源站压力降低90%以上,首屏加载时间压缩至2秒内,从而显著提升用户留存率与播放流畅度,是2026年视频业务降本增效的必选项,视频点播CDN加速的技术演进与核心价值在2026年的数字媒体环境中,高清化、实时化已成为标配,传统的单点源站分发已无法……

    2026年5月26日
    4300
  • cdn流量计费怎么算,cdn流量费用

    CDN流量计费的核心逻辑是“按实际 outbound 流量结算”,2026年主流模式已全面转向阶梯定价与带宽峰值计费组合,企业通过智能调度与边缘缓存优化,可将综合成本降低30%-50%, 计费模式深度解析在2026年的数字生态中,CDN(内容分发网络)的计费方式已从单一的“按流量计费”演变为更加精细化的多维模型……

    2026年7月7日
    17300
  • 大模型真的好用吗?用了半年真实感受分享

    大模型在真实业务场景中并非万能工具,而是高杠杆率的效率放大器——半年深度使用下来,结论很明确:用对场景时效率提升300%以上,用错方向则徒增成本,以下从实战角度拆解其价值边界与落地路径,大模型最擅长的三大高价值场景(实测数据支撑)生产类任务**企业宣传文案:生成初稿耗时从2小时→15分钟,修改迭代效率提升70……

    云计算 2026年4月18日
    5100

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注