最新大模型芯片公司排名,哪家公司实力最强?

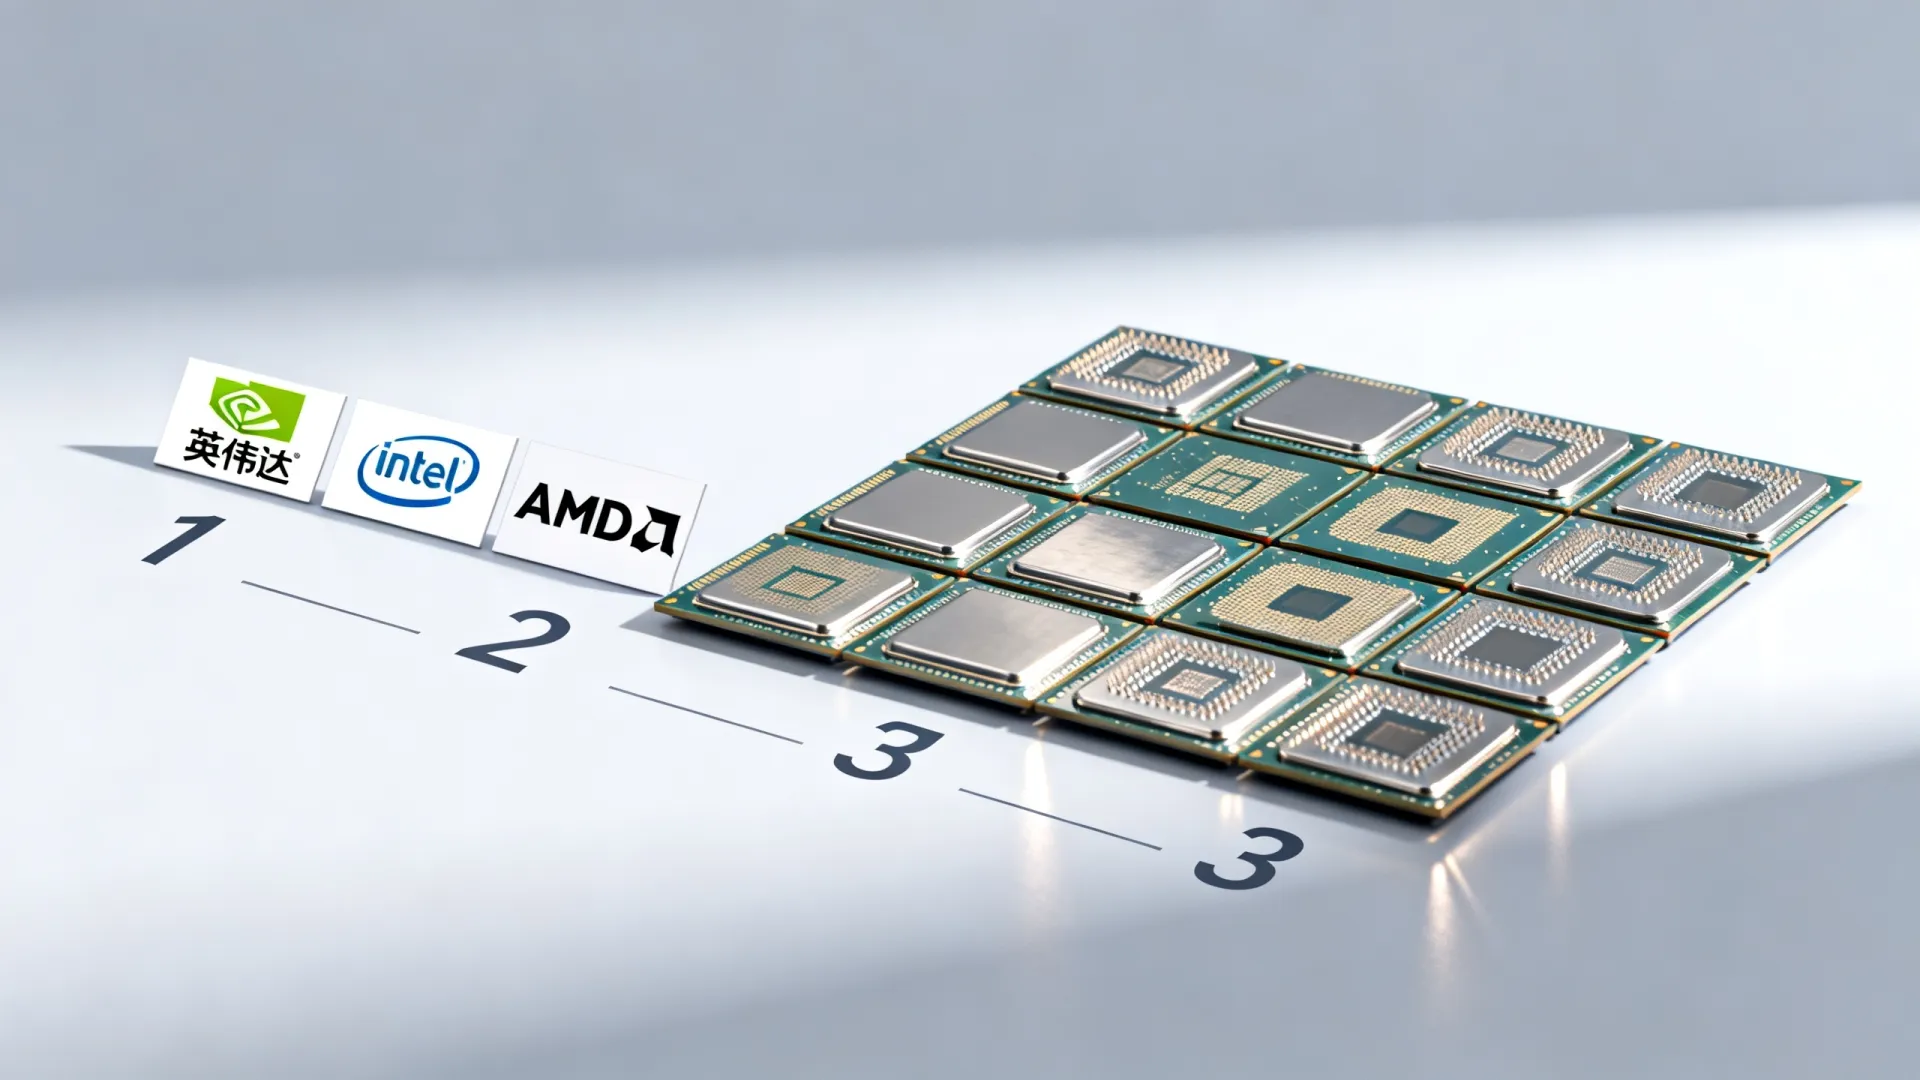
当前大模型芯片市场格局已呈现“一超多强”的态势,英伟达凭借软硬件生态壁垒稳坐头把交椅,但AMD、英特尔、华为海思等巨头正凭借差异化优势快速追赶,初创企业如Groq、Cerebras则在特定架构上实现了颠覆性突破。算力即权力,在这一轮AI浪潮中,芯片性能直接决定了大模型的智商上限与落地成本。 以下是目前大模型芯片领域的详细排名与实力拆解,通过这份最新大模型芯片公司排名排名,这几家实力确实猛的深度分析,我们可以清晰地看到未来算力战争的走向。
最新大模型芯片公司排名排名

DeepSeek/Qwen/Kimi/MiniMax…热门大模型多项能力翻车!8大能力横评
加载中
DeepSeek/Qwen/Kimi/MiniMax…热门大模型多项能力翻车!8大能力横评

行业霸主:英伟达(NVIDIA) 不可撼动的生态帝国

英伟达不仅是芯片公司,更是AI时代的基建商。

  1. 核心产品矩阵: 以H100、H200以及最新的Blackwell架构B200芯片为核心,构建了极其强大的算力底座。B200在推理性能上相比H100提升了数倍,这种代际碾压优势令人咋舌。
  2. CUDA生态护城河: 英伟达最恐怖的并非硬件参数,而是CUDA计算平台,十几年的开发者生态积累,使得几乎所有主流大模型框架都优先适配CUDA。这种软硬一体的锁定效应,让竞争对手难以通过单纯的硬件参数超越。
  3. 市场统治力: 在数据中心AI芯片市场,英伟达占据了超过80%的份额,对于追求训练稳定性的大厂而言,英伟达目前仍是唯一“免检”的选择。

强力挑战者:AMD 性价比与开放生态的破局者

AMD是目前最有能力对英伟达构成实质性威胁的厂商。

  1. MI300系列重拳: MI300X采用了Chiplet(小芯片)设计,显存容量高达192GB,这一参数直接击中了英伟达H100显存不足的痛点,非常适合运行超大参数模型。
  2. ROCm生态追赶: 虽然软件生态弱于英伟达,但AMD正大力投入ROCm开源生态建设,通过支持PyTorch等主流框架,降低开发者迁移成本。
  3. 差异化竞争: AMD采取了“开放”策略,不强制绑定自家硬件,这种灵活的姿态吸引了微软、Meta等不想被英伟达绑定的巨头客户。

国产之光:华为海思 软硬协同的自主标杆

在中国市场,华为海思是当之无愧的领跑者,其 Ascend(昇腾)系列芯片展现了极强的韧性。

  1. 昇腾910B实力不俗: 在算力密度和互联带宽上,昇腾910B已接近英伟达A100水平,在国内算力受限背景下,成为了国内大模型厂商的首选替代方案。
  2. 全栈自主可控: 华为的优势在于拥有从芯片(昇腾)到框架(MindSpore)再到大模型应用的全栈能力,这种垂直整合能力,使得软硬件协同效率极高。
  3. 集群算力优势: 单卡性能固然重要,但在万卡集群训练中,华为展现了优秀的网络互联技术,保证了大规模训练的线性加速比。

架构颠覆者:Groq 与 Cerebras 极致速度的探索者
最新大模型芯片公司排名排名

这两家公司不走寻常路,通过架构创新在推理端实现了弯道超车。

  1. Groq的语言处理单元(LPU): Groq放弃了传统的GPU架构,设计了专为Transformer模型服务的LPU。其生成的速度达到了“每秒数百个token”,比传统GPU快了数倍,这种极致的推理体验让人眼前一亮。
  2. Cerebras的晶圆级引擎: Cerebras直接在一整块晶圆上制造芯片,拥有惊人的85万个核心。这种“巨无霸”设计彻底消除了芯片间的通讯延迟,在训练超大模型时效率极高。
  3. 技术启示: 这两家公司的崛起证明了,单纯堆砌晶体管数量并非唯一出路,针对大模型特性的专用架构设计(DSA)将是未来的重要趋势。

传统巨头的反击:英特尔 x86阵营的坚守

英特尔正试图通过Gaudi系列芯片重回AI中心。

  1. Gaudi 3的竞争力: 其最新一代Gaudi 3在推理吞吐量上对标H100,且采用了开放的市场策略,价格更具侵略性。
  2. 开放生态策略: 英特尔依托成熟的x86 CPU市场,试图将AI算力无缝集成到现有的数据中心基础设施中,降低客户的部署门槛。

行业趋势深度洞察

透过上述排名,我们可以发现大模型芯片发展的三个核心逻辑:

  1. 内存墙成为主要瓶颈: 现在的竞争焦点已从单纯的算力FLOPS转向了显存带宽和容量。谁能装下更大的模型,谁就能在长文本处理中胜出。
  2. 互联技术决定集群效率: 单卡性能有天花板,未来大模型的竞争是万卡集群的竞争,NVLink、Infinity Fabric等互联技术比单芯片制程更关键。
  3. 推理市场即将爆发: 随着应用落地,推理芯片的需求将超过训练芯片,低功耗、低延迟的专用推理芯片将迎来爆发期。

这份最新大模型芯片公司排名排名,这几家实力确实猛的榜单不仅反映了当下的技术实力,更预示了未来的算力格局,英伟达虽强,但AMD的追赶、华为的自主以及Groq等新贵的创新,正在逐步瓦解垄断,推动AI算力走向多元化。


相关问答模块
最新大模型芯片公司排名排名

问:为什么显存容量在大模型芯片中变得越来越重要?

答:大模型的参数量巨大,例如GPT-4级别的模型参数量以万亿计,在推理和训练过程中,模型参数需要加载到显存中,如果显存不足,就需要通过模型切分等技术跨芯片传输,这会极大地增加通讯延迟,降低整体效率。大容量显存(如HBM高带宽内存)直接决定了芯片能否流畅运行超大参数模型,是当前芯片设计的关键瓶颈。

问:对于初创公司或个人开发者,选择哪家公司的芯片性价比最高?

答:如果是进行模型训练,英伟达仍是首选,因为其生态最完善,报错成本最低,但如果是进行推理部署,AMD的MI300系列或华为的昇腾系列提供了更具性价比的选择。关注云服务商的租赁服务,选择搭载Groq或特定推理加速卡的实例,往往能在特定场景下获得极致的性价比和速度体验。

您认为在未来三年内,谁最有可能打破英伟达的垄断地位?欢迎在评论区留下您的观点。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/66566.html

赞 (0)
独立服务器带宽和VPS带宽区别在哪?独立服务器带宽和VPS带宽有什么不同?
上一篇 2026年3月4日 21:50
AI平台服务双11促销活动有哪些?双11AI服务优惠力度大吗
下一篇 2026年3月4日 21:55

相关推荐

  • 网宿cdn介绍,网宿cdn是什么?

    网宿科技(Wangsu)作为全球领先的CDN及云安全服务提供商,通过其自研的“磐石”智能调度系统,在2026年依然保持着国内市场份额第一、全球节点覆盖超2800个的核心优势,是解决高并发、低延迟及复杂网络环境加速的首选方案,网宿CDN的核心技术架构与2026年行业地位在2026年的数字经济背景下,CDN已不再仅……

    2026年7月5日
    12600
  • cdn的内部业务是什么,cdn加速原理

    CDN内部业务的核心在于通过全球分布的边缘节点网络,实现内容的就近分发与智能调度,从而显著降低源站负载、提升用户访问速度并保障业务的高可用性,CDN内部业务架构解析CDN(Content Delivery Network)并非简单的服务器集群,而是一个复杂的分布式系统,其内部业务逻辑主要围绕“缓存”与“调度”两……

    2026年7月5日
    5900
  • cdn只能加速静态资源吗,cdn加速原理

    CDN(内容分发网络)的核心功能仅限于加速静态资源的分发与缓存,它无法直接处理动态业务逻辑、数据库交互或服务器端的复杂计算,因此不能替代源站服务器或应用服务器,这一结论基于2026年互联网架构的标准化分工,随着AI生成内容(AIGC)和实时交互应用的爆发,CDN的角色已从单纯的“加速管道”演变为“边缘计算节点……

    2026年6月30日
    1710
  • cdn镜像缓存是什么,cdn镜像缓存

    CDN镜像缓存的核心价值在于通过边缘节点就近分发内容,将源站压力降低70%以上,同时使全球用户访问延迟控制在50毫秒以内,是保障高并发场景下业务稳定性的关键基础设施,在2026年的数字生态中,内容分发网络(CDN)已不再仅仅是加速工具,而是云原生架构中的流量调度中枢,随着4K/8K视频、云游戏及AI大模型推理应……

    2026年6月14日
    4300
  • 国内哪家云主机好,国内云服务器性价比高吗?

    在国内云服务市场,选择合适的云主机对于业务稳定性和成本控制至关重要,经过对市场占有率、核心技术架构、服务响应速度及性价比的综合评估,阿里云、腾讯云和华为云构成了国内云主机的第一梯队,对于大多数用户而言,这三家均能提供成熟稳定的服务,具体选择应依据业务场景、技术栈需求以及预算规模来决定,在深入研究国内哪家云主机好……

    2026年2月25日
    17100
  • 服务器地址帽子云,为何如此神秘?揭秘帽子云服务器地址的奥秘!

    服务器地址帽子云是一种创新的网络架构解决方案,它通过分布式节点和智能路由技术,将服务器地址资源进行虚拟化整合,形成一个高效、安全且弹性伸缩的云服务网络,这种架构不仅提升了数据传输的稳定性和速度,还为企业及个人用户提供了灵活可控的部署选项,是现代互联网基础设施演进的重要方向,核心原理与技术架构服务器地址帽子云基于……

    2026年2月4日
    13830
  • ai灵动寰宇大模型怎么样?这款大模型到底好不好用?

    综合市场反馈与技术实测来看,AI灵动寰宇大模型在国产大模型第一梯队中表现抢眼,其核心优势在于“长文本处理的精准度”与“多模态交互的流畅性”,消费者普遍认为其在国内语境理解、办公辅助及创意生成方面具有极高的实用价值,是一款“上手快、产出高、稳定性强”的生产力工具,核心结论:国产大模型中的务实派,办公与创作场景的首……

    2026年3月5日
    15900
  • Activiti官网无法访问怎么办,Activiti教程

    cdn www.activiti.org 是获取 Activiti 工作流引擎核心资源与文档的官方权威渠道,通过配置正确的 CDN 节点,开发者能显著降低依赖加载延迟,确保在本地开发及生产环境中获得稳定、高效的流程引擎集成体验,在 Java 企业级应用开发领域,Activiti 作为一款成熟的工作流引擎,其生态……

    云计算 2026年5月25日
    4000
  • 通用大模型训练原理是什么,通俗讲讲很简单

    通用大模型的训练本质是一个从“海量数据”到“智能涌现”的统计学过程,其核心逻辑可以概括为“预训练构建基座,微调塑造能力,对齐人类价值观”,这并非玄学,而是一个基于概率预测与误差反向传播的精密工程,想要理解通用大模型训练原理技术原理,通俗讲讲很简单,我们只需将其想象为一个博闻强识的学生在经历“通识教育”、“专业培……

    2026年3月8日
    14100
  • 大模型训练资源预估怎么做?深度解析实用总结

    大模型训练资源预估的核心在于精准计算算力需求、显存占用与训练时间三者的平衡关系,通过建立科学的估算模型,可将资源浪费控制在10%以内,显著提升训练效率,深度了解大模型训练资源预估后,这些总结很实用,它们能帮助技术团队在项目启动前规避显存溢出、算力不足等致命风险,直接决定项目成败,算力需求估算:以FLOPs为基准……

    2026年3月15日
    15600

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注