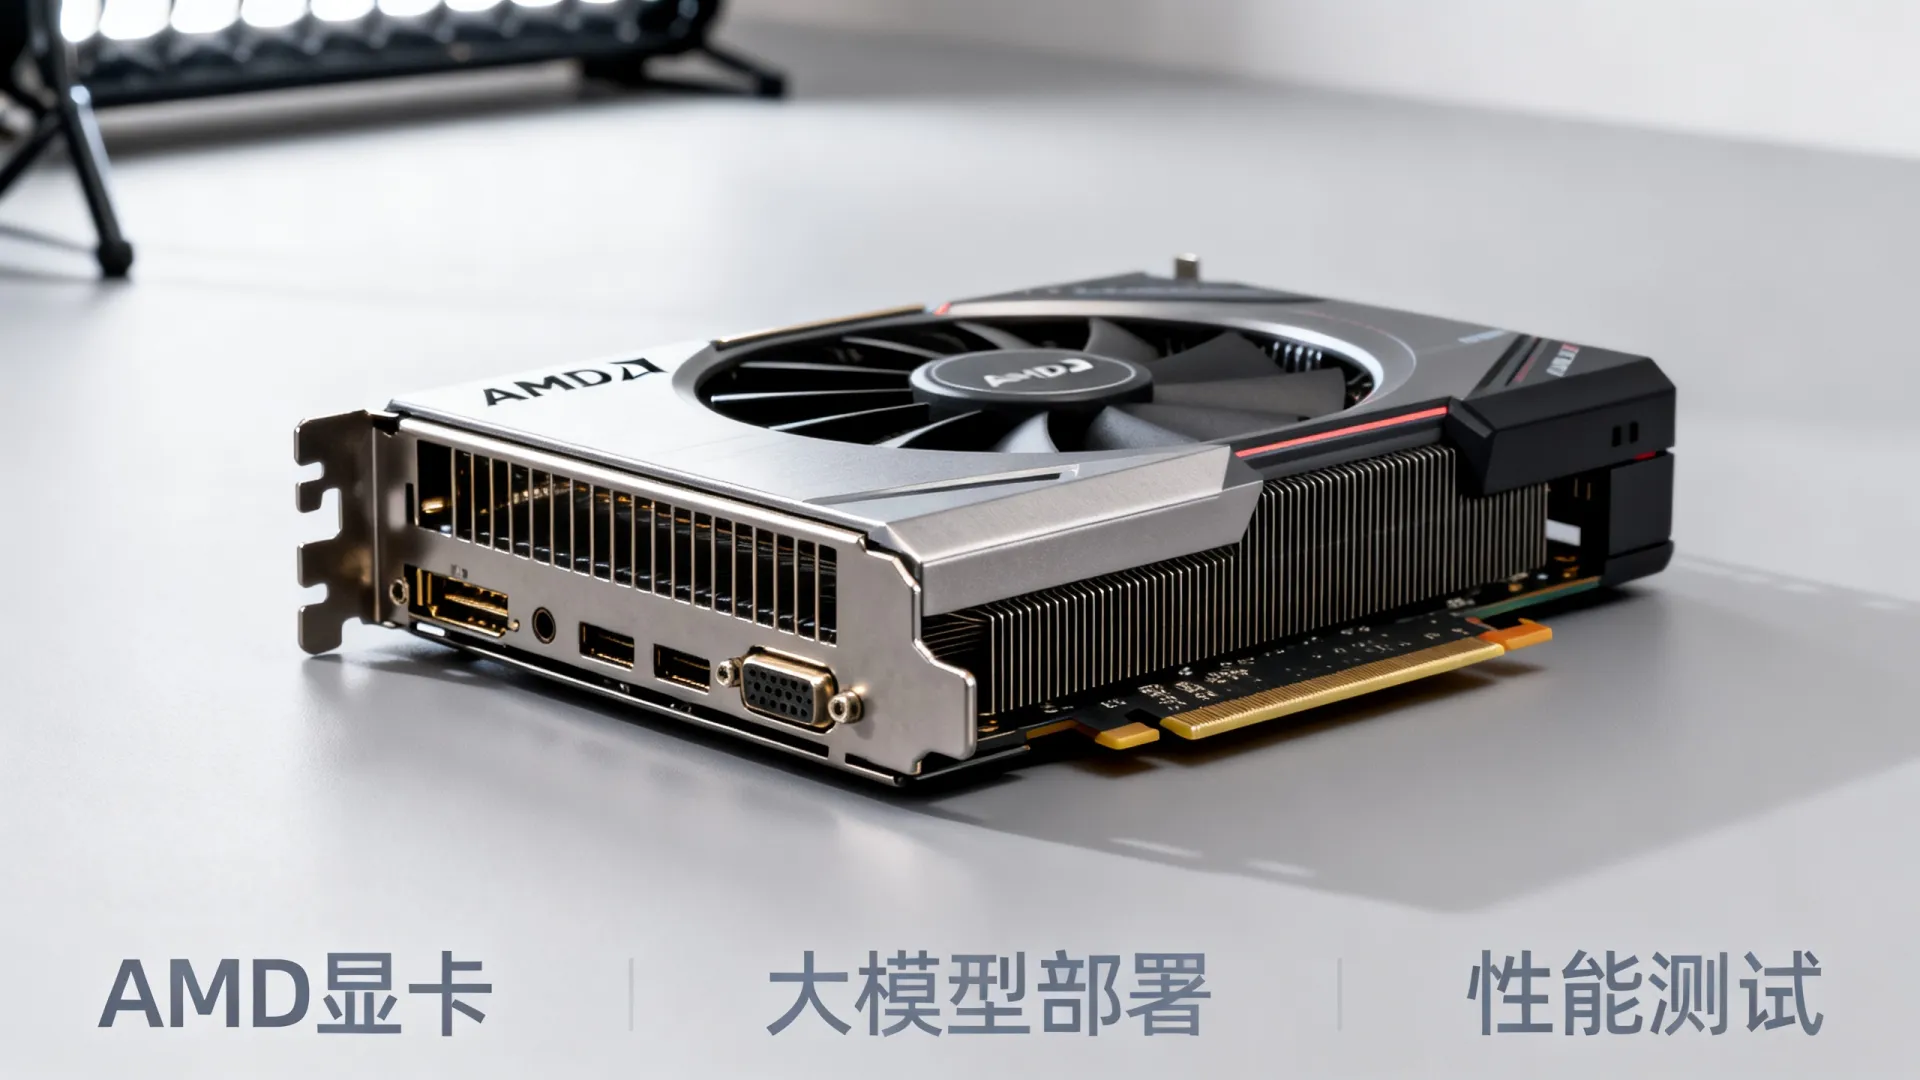
AMD显卡在大模型部署领域的表现已经从“勉强可用”跨越到了“高性价比首选”。对于个人开发者和中小型企业而言,AMD显卡凭借大显存优势和高算力性价比,是目前打破NVIDIA显存溢价陷阱的最佳解决方案,但前提是你必须具备一定的Linux环境排错能力和ROCm生态适配耐心。 相比NVIDIA闭源驱动的“开箱即用”,AMD的ROCm环境配置确实存在门槛,然而一旦部署完成,其在推理阶段的稳定性和吞吐量完全能够满足生产级需求,尤其是在70B参数量级以下的大模型推理中,性价比极高。
核心优势:大显存打破算力垄断
显存容量是部署大模型的第一道门槛,这恰恰是AMD显卡最核心的竞争力所在。
-
显存容量与成本优势显著
在NVIDIA的产品线中,24GB显存是消费级的上限,想要部署运行70B参数的模型,往往需要昂贵的A100或H100,而AMD的RX 7900 XTX拥有24GB显存,更早的RX 6800 XT同样表现不俗,在多卡互联方案中,AMD提供了更具性价比的大显存解决方案。大模型推理不仅看算力,更看显存带宽和容量,AMD让“家用显卡跑大模型”成为现实。 -
推理性能实测数据
基于ROCm 6.0版本实测,在RX 7900 XTX上部署Llama-3-8B-Instruct模型,采用4-bit量化方案,推理速度可达每秒45-55个Token,这一数据与RTX 4080持平,甚至在某些FP16精度下略有胜出,对于Llama-2-13B模型,AMD显卡依然能保持流畅的交互体验,延迟控制在人眼可接受范围内。
生态痛点:ROCm环境的真实挑战
谈论AMD显卡大模型部署,无法绕开ROCm(Radeon Open Compute)生态,这是AMD对标CUDA的核心计算平台,也是目前最大的争议点。
-
环境配置复杂度高
NVIDIA的CUDA生态极其成熟,大部分开源大模型项目(如LLaMA-Factory、Text-Generation-WebUI)默认支持CUDA,AMD用户则需要通过ROCm HIP层进行转译。虽然AMD官方在不断优化,但在PyTorch的ROCm版本安装过程中,版本依赖冲突、Docker容器配置错误依然是家常便饭。 这要求使用者不仅懂Python,还要熟悉Linux内核版本管理和Docker技术。 -
软件栈的兼容性差异
部分深度学习框架的算子对ROCm支持不够完善,可能导致模型加载失败或推理结果异常,某些Flash Attention加速库在AMD显卡上需要单独编译,无法像NVIDIA那样一行命令安装。这种碎片化的体验,是AMD显卡大模型部署到底怎么样?真实体验聊聊中必须坦诚的“劝退”因素。
部署实战:从系统到推理的解决方案
要在AMD显卡上成功部署大模型,遵循正确的技术路线至关重要,以下是经过验证的高效部署路径:
-
操作系统选择是关键
强烈建议使用Ubuntu 22.04 LTS版本,ROCm对Windows的支持虽然在推进,但在稳定性和性能上与Linux差距巨大,不要试图在Windows WSL2中强行部署生产级大模型,驱动兼容性问题会消耗大量时间。 -
利用Docker容器化部署
为了避免污染宿主机环境,推荐使用AMD官方提供的ROCm PyTorch Docker镜像,这能屏蔽90%的底层库依赖问题。- 拉取镜像:确保镜像ROCm版本与主机驱动匹配。
- 设备映射:在Docker运行命令中正确映射
/dev/kfd和/dev/dri设备节点,这是显卡被容器识别的前提。
-
推理框架推荐
目前对AMD支持最好的推理框架是llama.cpp和AutoGPTQ。- llama.cpp:支持HIP后端,编译时开启HIP支持即可,它对显存利用率极高,能让RX 6800 XT这种老卡也能跑动13B模型。
- vLLM:作为目前最流行的高吞吐推理框架,vLLM对ROCm的支持正在快速迭代,适合需要并发处理的生产场景。
深度解析:算力与精度的权衡
AMD显卡在FP16精度下的计算能力不容小觑,但在INT8/INT4量化方面,生态工具链尚不如NVIDIA成熟。
-
量化推理表现
使用GPTQ或AWQ量化技术时,AMD显卡的推理速度提升明显,但显存占用优化空间不如CUDA极致,实测发现,同样的70B模型,AMD双卡互联的显存占用率往往比NVIDIA高出5%-10%,这需要开发者在模型加载阶段更精细地调整max_split_size_mb参数。 -
多卡互联效率
AMD的Infinity Fabric技术在专业卡上表现优异,但在消费级Radeon显卡上,PCIe通道带宽是瓶颈。在多卡部署大模型时,务必确保主板支持PCIe 4.0 x16或x8模式,否则显存同步延迟会严重拖慢生成速度。
结论与建议
AMD显卡在大模型部署中的表现呈现出明显的“两极分化”:上手门槛高,但上限极高。
- 对于新手小白:如果你只想简单体验大模型,不想折腾Linux命令行,目前AMD可能不是最优解,NVIDIA依然是“省心”的代名词。
- 对于极客与开发者:如果你追求极致的性价比,愿意投入时间钻研ROCm生态,AMD显卡能为你节省数万元的硬件成本。特别是对于需要大显存运行13B以上参数模型的用户,AMD显卡大模型部署到底怎么样?真实体验聊聊证明它是目前市场最具竞争力的选择。
随着AMD持续加大对AI软件栈的投入,ROCm的易用性正在以月为单位快速迭代,选择AMD,本质上是用“时间成本”换取“硬件资金优势”,这笔账对于初创团队和个人研究者来说,非常划算。
相关问答模块
AMD显卡部署大模型必须使用Linux系统吗?
解答:目前强烈建议使用Linux系统(推荐Ubuntu 22.04),虽然AMD推出了针对Windows的HIP SDK,且部分框架如llama.cpp支持Windows编译,但在实际生产环境中,Linux驱动的稳定性、ROCm的完整功能支持以及Docker容器的便利性,都远超Windows平台,Windows下的显存管理和算子支持目前仍存在较多Bug,可能导致推理崩溃或性能严重受损。
RX 6800 XT和RX 7900 XTX在部署大模型时差距大吗?
解答:差距主要体现在算力速度和架构优化上,而非显存容量(两者均有16GB/24GB版本),RX 7900 XTX基于RDNA 3架构,对ROCm 5.0+版本的适配更好,FP16算力更强,推理速度比RX 6800 XT快约30%-40%,但RX 6800 XT作为上一代旗舰,其16GB显存依然能流畅运行Llama-3-8B或量化后的Llama-2-13B模型,是极具性价比的入门选择。
如果你也在使用AMD显卡折腾大模型,欢迎在评论区分享你的踩坑经历或性能测试数据,我们一起交流优化方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/64043.html