大模型架构解析书技术原理是什么,通俗讲讲很简单

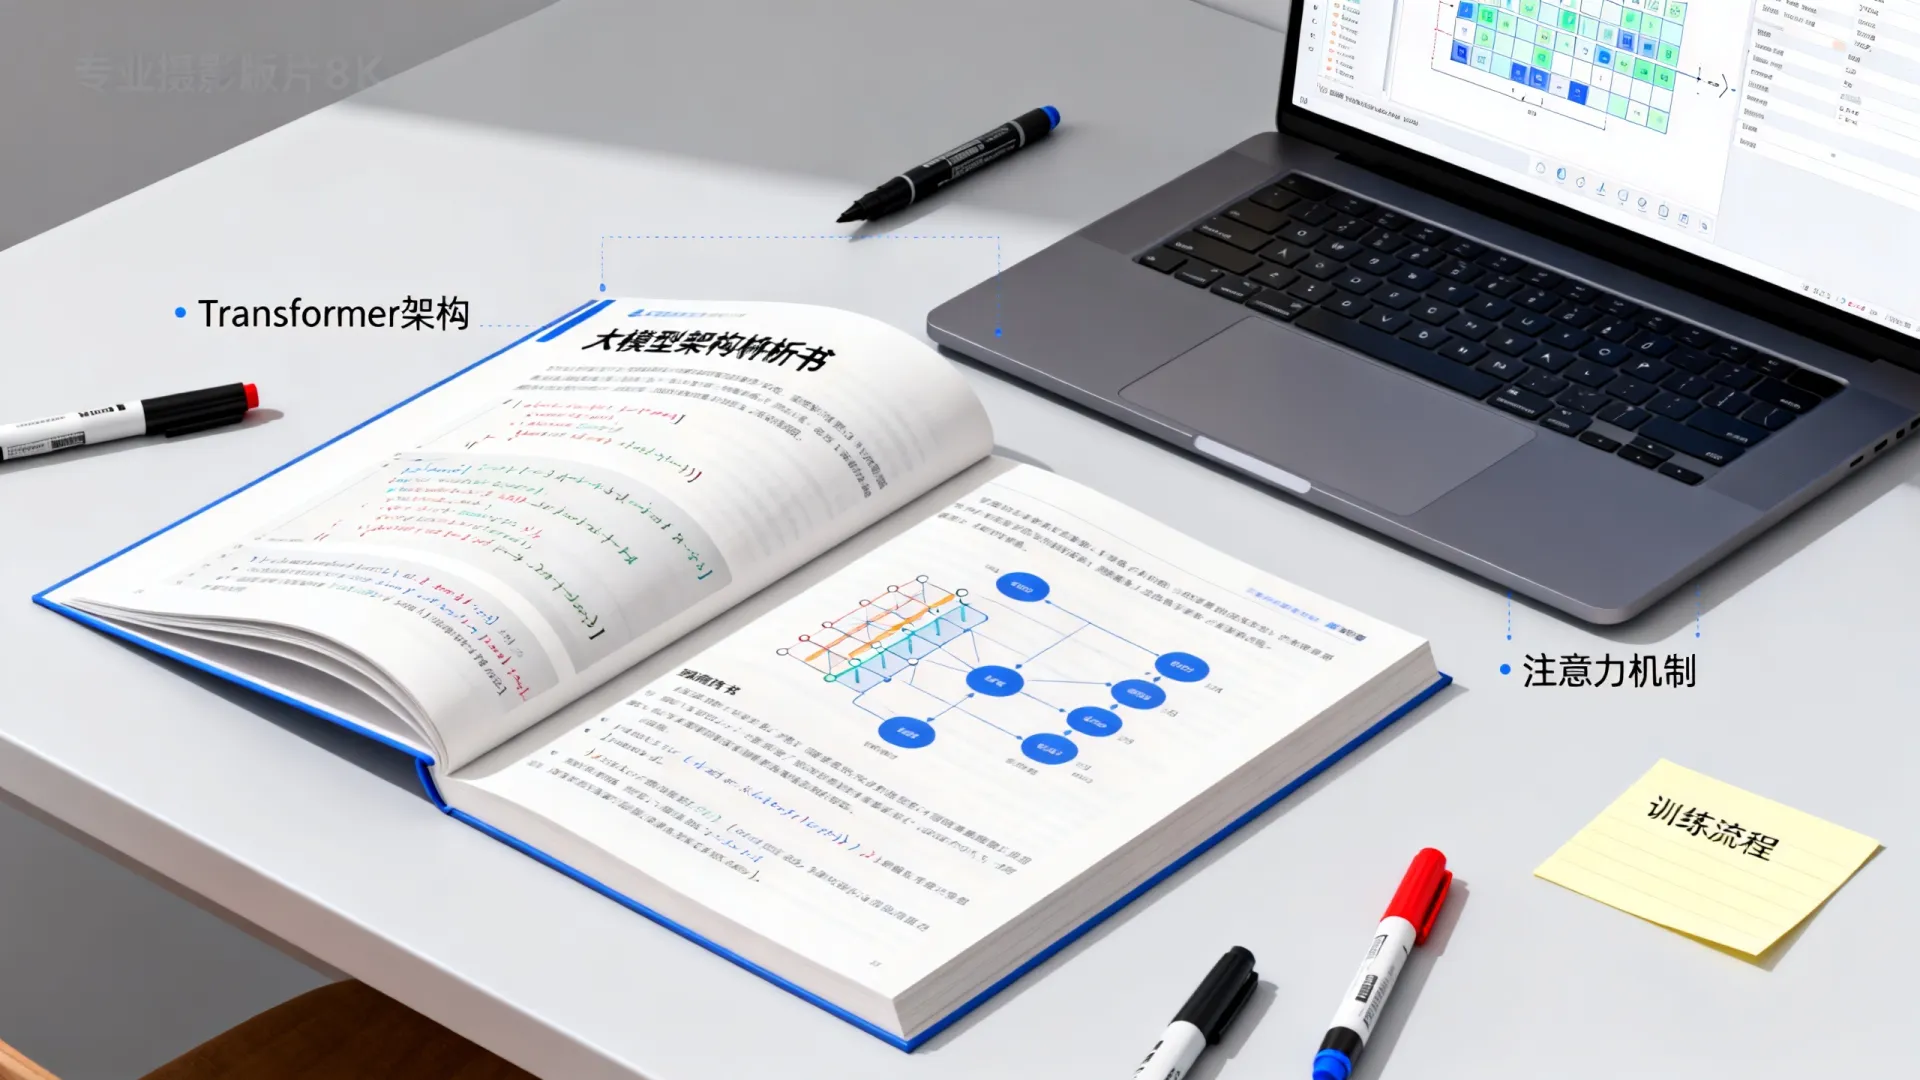
大模型架构的核心技术原理,本质上是一场关于“预测下一个字”的数学游戏,其底层逻辑并不神秘,通俗讲讲很简单,核心在于通过海量数据训练出一个能够理解上下文概率分布的超级大脑。大模型架构解析书技术原理,通俗讲讲很简单,其精髓可以概括为:基于Transformer架构的深度神经网络,通过自注意力机制捕捉长距离依赖关系,利用预训练加微调的范式实现通用智能。
大模型架构解析书技术原理

大模型祛魅,一本书带你跑通代码、理解原理、掌握实战
加载中
大模型祛魅,一本书带你跑通代码、理解原理、掌握实战

核心架构:Transformer是唯一的基石

目前的通用大模型,无一例外都是基于Transformer架构搭建的,这并非技术的巧合,而是演进的必然。

  1. 抛弃循环,拥抱并行,传统的RNN(循环神经网络)像是一个记性不好的人,读到句子末尾往往忘了开头,且必须按顺序阅读,计算速度极慢。Transformer架构彻底抛弃了循环结构,引入了自注意力机制,使得模型能够一次性看到整段文字,并行计算效率呈指数级提升。
  2. 自注意力机制:模型的“聚光灯”,这是大模型最核心的发明,当模型处理“苹果”这个词时,它会根据上下文自动判断是指“水果”还是“科技公司”。自注意力机制通过计算词与词之间的关联权重,让模型知道在当前语境下,哪些词更重要,从而精准捕捉语义。

运作流程:从Token到概率分布的精准预测

理解大模型,必须理解它的工作单元Token(词元)。

  1. 文本的数字化切分,模型看不懂汉字或字母,它只能处理数字,输入的一段话会被切分成一个个Token,每个Token对应一个唯一的ID,这种切分方式比传统的分词更灵活,能有效解决未登录词的问题。
  2. 向量嵌入:语义的数学映射,每个Token会被映射成一个高维向量,在这个高维空间中,语义相近的词距离会很近。“男人”和“女人”的向量距离,大致等于“国王”和“女王”的向量距离。这种向量表示法,让模型真正具备了理解语义的能力,而不仅仅是死记硬背。
  3. 概率预测:下一个词的博弈,模型训练的过程,就是不断调整参数,使得预测下一个Token的概率最大化,生成内容时,模型根据上文计算出下一个词的概率分布,通过采样策略(如贪婪搜索或核采样)选出最合适的词。这解释了为什么大模型有时会一本正经地胡说八道,因为它本质上是在做概率选择,而非逻辑推理。

训练范式:预训练与微调的双重奏

大模型的强大能力并非一蹴而就,而是分阶段培养的。
大模型架构解析书技术原理

  1. 预训练:博览群书的通才,这一阶段模型阅读互联网上数万亿字节的文本,学习语言的语法、逻辑和世界知识。此时的模型像一个读了万卷书但不懂人情世故的学者,能续写文章,但不懂如何遵循指令。 这一过程消耗了绝大部分算力,是模型“智能”的源泉。
  2. 指令微调:学会听人话的助手,通过人工构造的高质量问答数据,教会模型如何回答问题、遵循指令。这类似于对模型进行“岗前培训”,使其从通才转变为专用助手,输出符合人类价值观的内容。
  3. 人类反馈强化学习(RLHF):价值观的对齐,通过人类对模型回答的打分,训练一个奖励模型,再通过强化学习优化大模型。这一步至关重要,它有效降低了有害内容的生成概率,让模型更安全、更听话。

关键组件:MoE与长上下文的演进

随着模型规模的扩大,架构也在不断优化以平衡性能与成本。

  1. 混合专家模型,传统的稠密模型每次激活所有参数,计算开销巨大。MoE架构将模型拆分为多个“专家”,每次输入只激活其中一小部分专家,实现了在扩大参数规模的同时,保持推理成本的基本稳定。 这是通往万亿参数模型的必经之路。
  2. 长上下文窗口,早期模型只能处理几千字,如今已进化到处理百万字。这得益于位置编码技术的改进(如RoPE、ALiBi),让模型能够处理超长文本,打破了“记忆瓶颈”,在长文档分析、长篇小说创作等场景下展现出惊人潜力。

独家见解:大模型的“智力”边界与幻觉问题

从技术原理看,大模型并没有真正的意识。它的“智力”来源于对海量数据中统计规律的压缩和提取。 所谓的“幻觉”,即模型编造事实,并非程序Bug,而是其概率生成机制的固有特性,当模型在训练数据中找不到确切答案时,它会倾向于根据概率生成看似通顺但实则错误的内容。

解决这一问题需要从架构层面引入外部知识库(RAG),让模型在生成前先检索相关事实,用检索增强生成来弥补参数记忆的不足。这是目前让大模型从“聊天机器人”走向“行业专家”最有效的技术路径。


相关问答模块
大模型架构解析书技术原理

为什么大模型需要如此巨大的算力支持?
答:大模型的算力消耗主要源于两个维度,一是参数规模巨大,千亿甚至万亿参数的矩阵乘法运算量惊人;二是训练数据量庞大,处理数万亿Token需要进行数万次的迭代计算。这就像是让一个人在短时间内读完全世界的书并记住所有细节,大脑(GPU)的高速运转和能量消耗是必然的。

大模型架构解析书技术原理中提到的“参数量”代表什么?
答:参数量可以类比为人类大脑中神经元连接的数量,参数量越大,模型能够容纳的知识和逻辑模式就越复杂,表现出的能力通常也越强。但参数量并非决定性能的唯一因素,数据质量和训练方法同样关键,这就好比脑袋大不代表一定聪明,后天的教育和学习方法同样重要。

如果您对大模型的具体架构细节还有疑问,欢迎在评论区留言交流。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/61184.html

赞 (0)
大模型肉烤肠到底怎么样?大模型肉烤肠好吃吗
上一篇 2026年3月2日 08:10
服务器搭建需要什么?服务器搭建需要哪些配置环境
下一篇 2026年3月2日 08:19

相关推荐

  • ollama启动不了大模型怎么办,ollama无法启动的解决方法

    Ollama启动失败,90%以上的问题根源并不在软件本身,而在于运行环境配置、硬件资源瓶颈或服务冲突,核心结论非常直接:不要盲目重装,要从日志、资源和环境三个维度进行“体检”,大模型对硬件的要求极为苛刻,任何一项指标不达标,都会导致服务静默退出或报错,解决Ollama启动问题,本质上是一个资源匹配与端口占用的排……

    2026年3月18日
    29400
  • 服务器实时同步怎么实现?服务器数据同步方案哪家好

    2026年企业实现服务器实时同步的终极路径,是采用基于CRDTs(无冲突复制数据类型)算法与RDMA智能网络的分布式架构,在保障数据强一致性的同时将延迟压至微秒级,服务器实时同步的底层逻辑与行业演进从“定时批处理”到“强一致性实时流”传统异步复制已无法满足2026年数字化业务对RPO(恢复点目标)=0的严苛要求……

    2026年4月24日
    6000
  • 服务器托管云选择时要注意什么,哪家最好?

    服务器托管云并非简单的“托管+云”,而是将物理服务器部署在云服务商的高标准数据中心,同时享受云管理平台的统一运维和弹性资源调度,是兼顾性能与灵活性的折中方案,服务器托管云和云服务器有什么区别?适合什么场景?很多企业常在“服务器托管云”和“云服务器”之间犹豫,其实两者本质不同,服务器托管云是用户自购物理服务器,放……

    2026年8月13日
    100
  • CDN流量互换是什么,CDN流量互换怎么操作

    CDN流量互换并非简单的“资源置换”,而是基于BGP多线接入与智能调度算法的底层带宽成本优化方案,其核心结论是:在合规前提下,通过异构网络互补可实现15%-30%的带宽成本节约,但需严格规避违规内容风险并满足工信部备案要求,CDN流量互换的核心逻辑与技术架构CDN流量互换(Traffic Exchange)本质……

    2026年6月11日
    5300
  • IBM CDN怎么样,IBM CDN加速服务效果与优势解析

    IBM CDN(现归属于IBM Cloud Global Network)在2026年的表现可概括为:企业级安全与混合云架构的顶级选择,但在纯静态内容分发成本和极致低延迟场景下,性价比略逊于国内头部云厂商,适合对数据合规性、全球节点稳定性及AI边缘计算有强需求的中大型跨国企业,IBM CDN核心优势与2026年……

    2026年5月26日
    3900
  • cdn平均计费怎么算,cdn计费方式

    2026年CDN平均计费并非单一固定值,而是基于“带宽峰值/流量总量+HTTP请求次数+特定功能模块”的混合计费模式,主流云厂商综合单价已下探至0.15-0.35元/GB区间,具体价格取决于地域节点、带宽类型及用量阶梯,CDN计费逻辑深度拆解:从单一流量到多维组合在2026年的云计算生态中,CDN(内容分发网络……

    2026年6月10日
    4400
  • 大模型参数要多少才算真强?从业者曝出大实话,百亿级是分水岭

    当大模型参数量突破1750亿,行业才真正进入“可用阶段”——这是多位头部大模型研发负责人在2024年Q2闭门会上一致透露的核心阈值,低于此量级,模型在复杂推理、长程理解与多任务泛化上存在显著瓶颈;超过该临界点,性能跃升呈现非线性增长,关于大模型参数达到多少,从业者说出大实话:参数量是必要非充分条件,但1750亿……

    2026年4月17日
    11300
  • cdn过阿里云备案,阿里云cdn备案流程是怎样的

    cdn过阿里云备案的核心结论是:必须先将域名在阿里云完成ICP备案,获得备案号后,才能在阿里云CDN控制台将该域名接入并开启CDN加速,未备案域名无法通过阿里云CDN进行中国大陆节点的访问加速,这一机制并非技术限制,而是基于中国工信部《非经营性互联网信息服务备案管理办法》的合规要求,对于2026年的网站运营者而……

    2026年5月17日
    6500
  • 大模型中的插件是什么?大模型插件怎么用?

    大模型插件的本质,并非高深莫测的黑科技,而是一座连接“大脑”与“手脚”的桥梁,核心结论非常清晰:大模型本身只是一个拥有海量知识的“大脑”,它具备推理能力但缺乏行动能力;插件则是赋予这个大脑“手脚”和“外部记忆”的工具,它让大模型从单纯的“对话者”进化为能够执行任务的“行动者”, 理解了这一层逻辑,大模型插件的神……

    2026年3月27日
    11600
  • flux大模型版本怎么选?flux大模型哪个版本好用

    面对Flux大模型层出不穷的版本迭代,最核心的选择结论只有一条:显存决定下限,需求决定上限, 对于绝大多数追求高质量商业出图的用户而言,Flux.1 [dev] 版本是目前性价比最高、画质与可控性达到最佳平衡的不二之选;而对于仅需快速预览或低配设备的用户,Flux.1 [schnell] 则是效率首选;至于功能……

    2026年3月28日
    10800

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注