无公网IP的弹性云服务器无法直连外部NTP服务进行时间同步,正确做法是通过NAT网关放通UDP 123出站流量,或在VPC内部署一台带公网能力的跳板NTP服务器,二选一即可稳定解决。
很多运维同事第一次接触无公网IP的弹性云服务器时,都会被时间同步这件事卡住,装好系统后date一看,时间差了整整八小时,或者慢了几分钟,原因很简单:没有公网IP,意味着出站流量没地方走,NTP协议默认用UDP 123端口跟外部时间服务器对话,这条路不通,时间自然对不上。
无公网IP的弹性云服务器怎么访问外网时间服务器
这个问题本质上是“出站网络通路”的问题,入站流量可以通过安全组、负载均衡等方式转进来,但出站流量必须依赖一个具备公网能力的出口,搞清楚这一点,方案就很清晰了。
通过NAT网关放通UDP 123端口
这是最常见的做法,适合绝大多数场景,在云控制台购买一个NAT网关,绑定到弹性云服务器所在的VPC子网,然后配置SNAT规则,让子网内所有无公网IP的机器都能借用NAT网关的公网IP访问Internet,关键一步是必须在NAT网关的安全组里放通UDP 123端口的出站方向,否则时间同步请求依然会被拦截。
具体操作路径(以主流云厂商控制台为例):
- 进入VPC控制台,创建NAT网关并绑定弹性IP
- 在NAT网关的SNAT规则中添加子网网段
- 在安全组规则中添加入方向UDP 123,源地址为0.0.0.0/0
- 登录弹性云服务器,编辑
/etc/chrony.conf,将server指向ntp.aliyun.com或cn.pool.ntp.org
配置完成后执行systemctl restart chronyd,再用chronyc sources -v查看同步源状态,能看到^符号就代表已经同步成功。
VPC内自建NTP跳板服务器
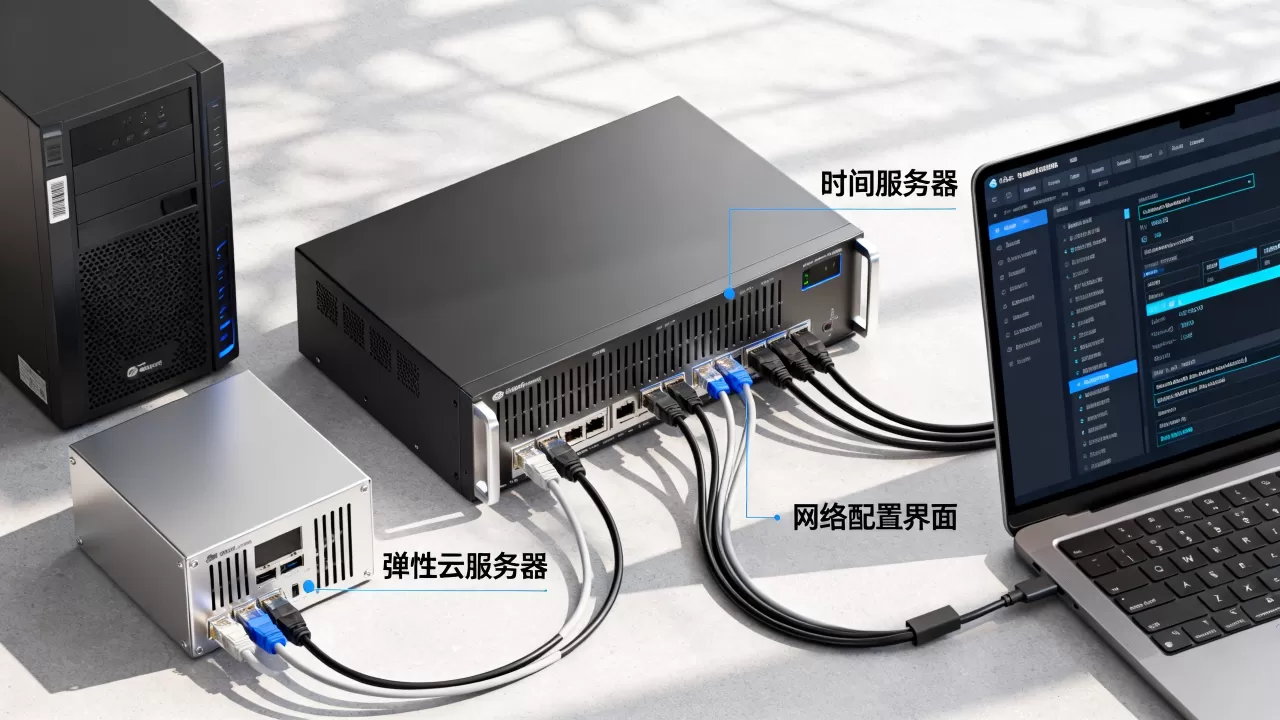
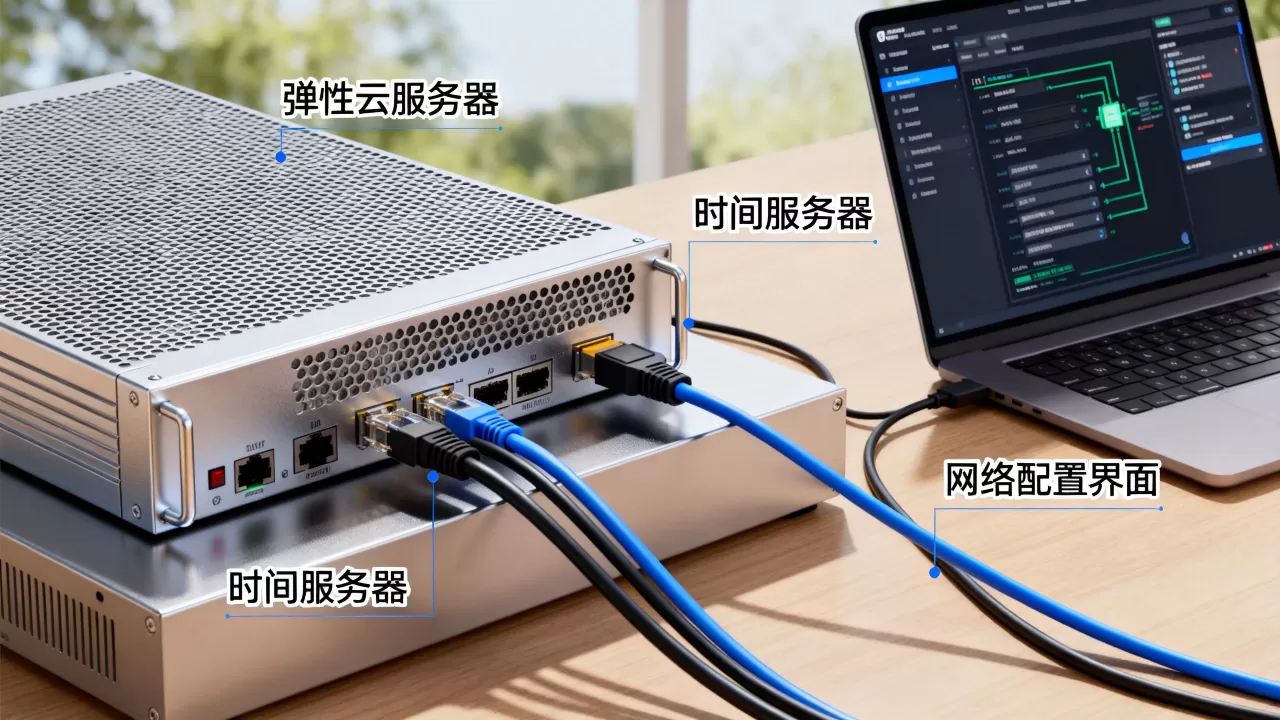
如果不想为每台机器单独配置NAT规则,或者预算有限,可以在VPC内找一台有公网IP的普通云服务器(哪怕是最低配),把它变成一台NTP中继,这台跳板服务器负责访问外部时间源,内网其他无公网IP的弹性云服务器直接跟它同步。
跳板机上的配置逻辑:
- 安装chrony并编辑
/etc/chrony.conf,保留默认的pool 2.centos.pool.ntp.org iburst行 - 在配置文件中追加一行
allow 192.168.0.0/16,允许内网网段请求时间服务 - 重启chronyd后用
firewall-cmd --add-service=ntp --permanent放行UDP 123端口
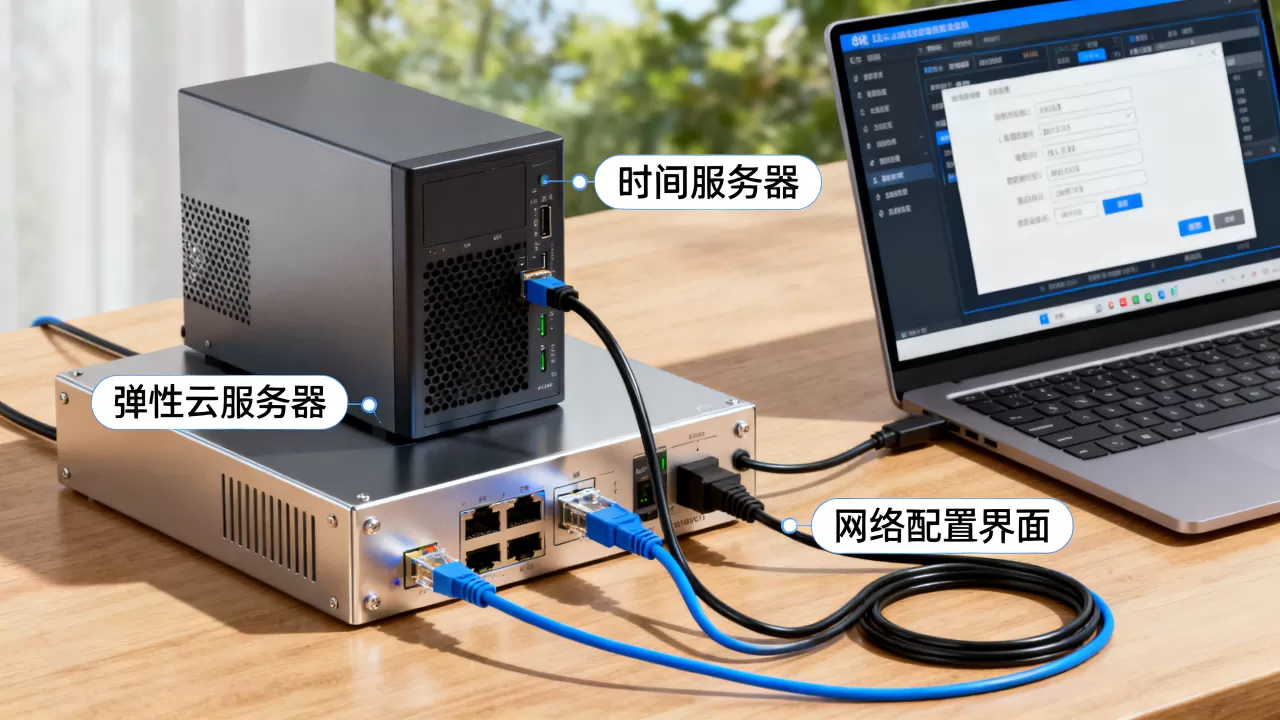
其他无公网IP的机器把server 192.168.x.x iburst写进chrony配置,就能实现秒级同步,行业共识认为,内网自建NTP服务器的同步精度(通常在几毫秒以内)反而优于直连公网NTP池,因为少了跨运营商链路的抖动。
弹性云服务器时间同步的两种主流架构对比
选NAT网关还是自建跳板,取决于你手上机器数量和对成本的要求,下面这个维度对比可以帮你快速做决定:
| 对比维度 | NAT网关直连公网NTP | VPC内自建NTP跳板 |
|---|---|---|
| 网络路径 | 机器 → NAT网关 → 公网NTP | 机器 → 跳板机 → 公网NTP |
| 架构复杂度 | 低,控制台点击配置即可 | 中,需要维护一台跳板机 |
| 同步精度 | 受公网链路影响,普遍在几十毫秒以内 | 内网传输,多数情况下可到毫秒级 |
| 成本 | NAT网关按规格付费,通常按小时计费 | 仅需一台低配云服务器费用 |
| 适用场景 | 机器数量少、临时性项目 | 长期运行、机器数量多、对时间一致性有要求 |
从实操角度看,如果你只有三台以内无公网IP的弹性云服务器,直接配NAT网关更省事,而如果是一个几十台机器的集群,每台机器都走NAT网关去公网同步,不仅浪费时间源资源,排查问题也麻烦,自建一台内网NTP服务器显然更合理。
找到对的互联网时间服务器并完成配置
互联网时间服务器(NTP Server)的选择是有讲究的,国内推荐使用简米云NTP服务或NTP Pool项目在国内的节点,它们的响应速度和稳定性相对有保障。
国内常用的NTP服务器地址:
ntp.aliyun.com:简米云公共NTP,支持IPv4和IPv6cn.pool.ntp.org:NTP Pool的中国节点,自动选择延迟最低的服务器ntp.tencent.com:酷番云公共NTP
配置时需要注意,部分云厂商镜像默认使用了内网专属的NTP地址(如
ntp.myhuaweicloud.com),如果你的机器没有公网IP且没有走NAT,这个地址实际上是个内网地址,能通但时间源可能来自云厂商内部的物理时钟,问题也不大,但如果你希望用标准公网时间源,就把它替换成上面列出的公共地址。
chrony和ntpdate哪个更适合云服务器
这是所有做时间同步的人都会纠结的问题,我从使用感受上聊聊两者的差异。
ntpdate是一个一次性的同步工具,执行完命令后立刻校正本地时间,适合手动修复偏差,但它没有守护进程,不会持续跟踪时间漂移,而且如果服务器时间偏差过大(超过1000秒),ntpdate会强制跳变,可能引发日志时间线混乱或定时任务误触发。
chrony是一个持续运行的时间同步服务,它通过渐进的频率调整来让系统时钟慢慢贴近标准时间,不会产生跳变,即使是偏移较大的机器,chrony也会用“步进”策略分多次校正。
结论很明确:只要你的操作系统是systemd系(CentOS 7+、Ubuntu 16.04+、Debian 9+),直接用chrony,别用ntpdate,chrony还支持chronyc tracking命令实时查看本地时钟与参考时钟的偏差值,排错时非常直观。
具体配置步骤:
yum install -y chrony # Ubuntu请替换为 apt install chrony
编辑/etc/chrony.conf,把默认的server行替换为:
server ntp.aliyun.com iburst执行systemctl enable --now chronyd,然后跑chronyc sources -v验证同步状态。
自建时间服务器时的网络与成本考量
选择自建NTP跳板时,别忽略两个容易被坑的点。
第一是链路选择,跳板机的公网带宽不需要大,1Mbps就足够支撑几百台内网机器的NTP请求,因为NTP报文只有几十字节,但跳板机所在的地域最好和你的无公网IP弹性云服务器在同一个可用区,这样内网延迟极低,时间精度最高,跨地域的自建NTP会因为内网链路绕转而引入额外抖动。
第二是云厂商的NTP劫持问题,部分云平台会默认拦截UDP 123端口流量,即使你配置了NAT出站,也需要在NFV防火墙或安全组中显式放行,曾有用户反馈“明明SNAT规则都配好了,但chrony一直显示
^?不可达”,排查到最后发现是云平台默认的安全策略把NTP报文丢了,遇到这类问题,先检查安全组和防火墙策略,再用tcpdump -i eth0 udp port 123抓包确认报文是否真的发出去。
从时间同步的运维成本来看,小规模场景没必要上NAT网关,你可以把一台有公网IP的1核1G云服务器同时当作堡垒机和NTP跳板,让这台机器承担入站运维管理和出站时间同步双重职责,避免重复付费,据工信部公开数据,国内云计算市场规模持续扩大,云服务器保有量已相当可观,其中相当一部分用户在弹性云服务器网络配置上遇到过类似的时间同步困惑,这已是运维圈的普遍话题。
无公网IP的弹性云服务器时间同步常见问题
为什么我的无公网IP弹性云服务器时间总是慢几分钟?
这通常是系统自带的chronyd或systemd-timesyncd没有可用的时间源,导致时钟自由漂移,先确认机器能否通过ping ntp.aliyun.com解析域名,再检查安全组是否放通UDP 123端口,如果安全组没放通,即使NAT网关配置正确,NTP请求也到不了外部服务器,对于差异几分钟的机器,配置好chrony后它会自动追踪并修正。
只有一台无公网IP的弹性云服务器,最便宜的同步方案是什么?
最省钱的办法是别买NAT网关,而是在同一VPC下开一台按量付费的最低配云服务器(有公网IP),配好chrony跳板,这台机器平时还能干点别的活,比如跑个跳板机或轻量监控脚本,用完就能释放,整体成本控制在较低水平,如果连这台机器都不想开,可以考虑把无公网IP的弹性云服务器临时绑定一个弹性IP,同步完时间再解绑,只是这个操作比较繁琐。
自建NTP服务器能给其他内网机器提供时间服务吗?
可以,前提是在跳板机的/etc/chrony.conf里加一行allow指定网段,默认情况下chrony只允许本机访问,不开放服务端功能,加上allow 192.168.0.0/24之类的规则后,同子网内其他无公网IP的弹性云服务器就能把它的内网地址作为时间源,别忘了放行云平台安全组中对应子网到跳板机UDP 123端口的入站流量,否则内网请求照样被拦在半路。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/587334.html