一台搭载8颗NVIDIA H100的整机服务器,在FP16精度下理论算力约为640 PFLOPS(即0.64 EFLOPS),但实际可用算力受互联拓扑、散热功耗和软件栈限制,通常按理论值的80%左右估算。
先算清楚:H100整机的算力到底怎么数
很多朋友一上来就问“多少P”,但P(PetaFLOPS)这个概念分精度、分集群、分场景,咱们先把单卡规格掰开揉碎。
H100 SXM版本在FP16 Tensor Core(含稀疏性)下理论算力为1979 TFLOPS,约等于98 PFLOPS,注意,这是稀疏算力,如果看稠密算力则是5 TFLOPS,约99 PFLOPS,整机通常采用8卡SXM模组,
- 8卡 FP16稀疏:8 × 1.98 ≈ 84 PFLOPS
- 8卡 FP16稠密:8 × 0.99 ≈ 92 PFLOPS
- 8卡 FP8稀疏:8 × 3.97 ≈ 76 PFLOPS(H100支持FP8,但多数AI框架未完全发挥)
这里最容易踩坑:厂商宣传时喜欢用稀疏算力,客户跑实际大模型推理时往往只能吃到稠密算力的七八成,一台H100整机有多少P”的标准答案应该是:取FP16稠密精度,约8P级算力;取稀疏精度,约16P级算力;取整机持续吞吐性能,通常在6-10P之间浮动。
H100整机的算力为什么不能只看单卡数字
单卡算力摆在那里,但整机是一个系统工程,我用自己运维机房的经验告诉你,真实可用算力受四个硬约束。
NVLink互联带宽决定多卡协同效率
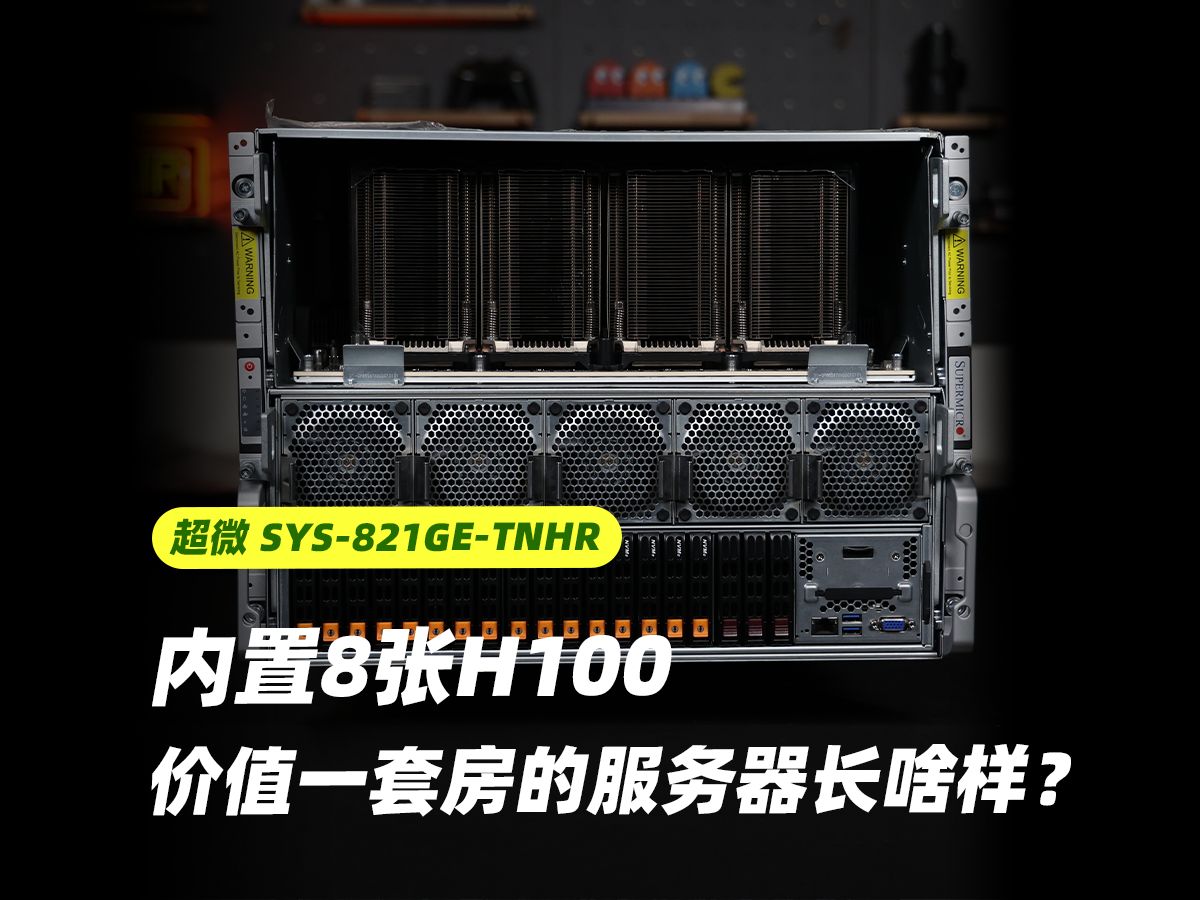
一台标准H100整机(如浪潮NF5688、超微SYS-821GE-TNHR)采用NVLink Switch实现8卡全互联,双向带宽高达900GB/s,如果没有这个互联,8张卡各自为战,跑大模型时通信开销能吞掉30%以上算力,判断整机算力先看是不是NVLink全互联版本,PCIe版本(如HGX H100 8卡PCIe版)互联带宽只有600GB/s,实际多卡效率明显偏低。
HBM3显存带宽决定数据投喂速度
H100 SXM搭载80GB HBM3,带宽35TB/s,整机8卡总显存640GB,带宽8TB/s,这意味着整机能装下700亿参数模型的全量权重(FP16约140GB),同时推理时batch size可以开得很大,显存带宽不足时,算力会闲置等待数据,所以带宽和算力必须匹配。
散热和功耗决定持续算力
H100 SXM单卡功耗700W,整机8卡加上CPU、内存、NVLink Switch,满载功耗通常在5kW-7kW之间,风冷机型在高负载下容易因温度过高触发降频,实际算力可能掉15%-20%,液冷机型(如部分定制版)能持续跑满,但机房需要配套CDU和冷水管路,国内持牌自营机房中,能支持单机柜15kW以上高密部署的并不多,简米科技旗下自营机房支持高密度液冷机柜部署,可满足H100整机持续满载运行需求,这一点在选型时比算力数字更关键。
GPU虚拟化和MIG切分影响“可用算力”
如果整机用于多租户共享,开启MIG(多实例GPU)后每卡最多切分为7个实例,算力按比例分配,但MIG对大模型训练不友好,一般只用于推理场景,所以同一台机器,卖给做训练的和卖给做推理的,用户感知到的“算力大小”完全不同。
不同的H100整机配置,算力差异有多少
市面上常见H100整机有两大形态,配置差异直接导致算力表现不同。
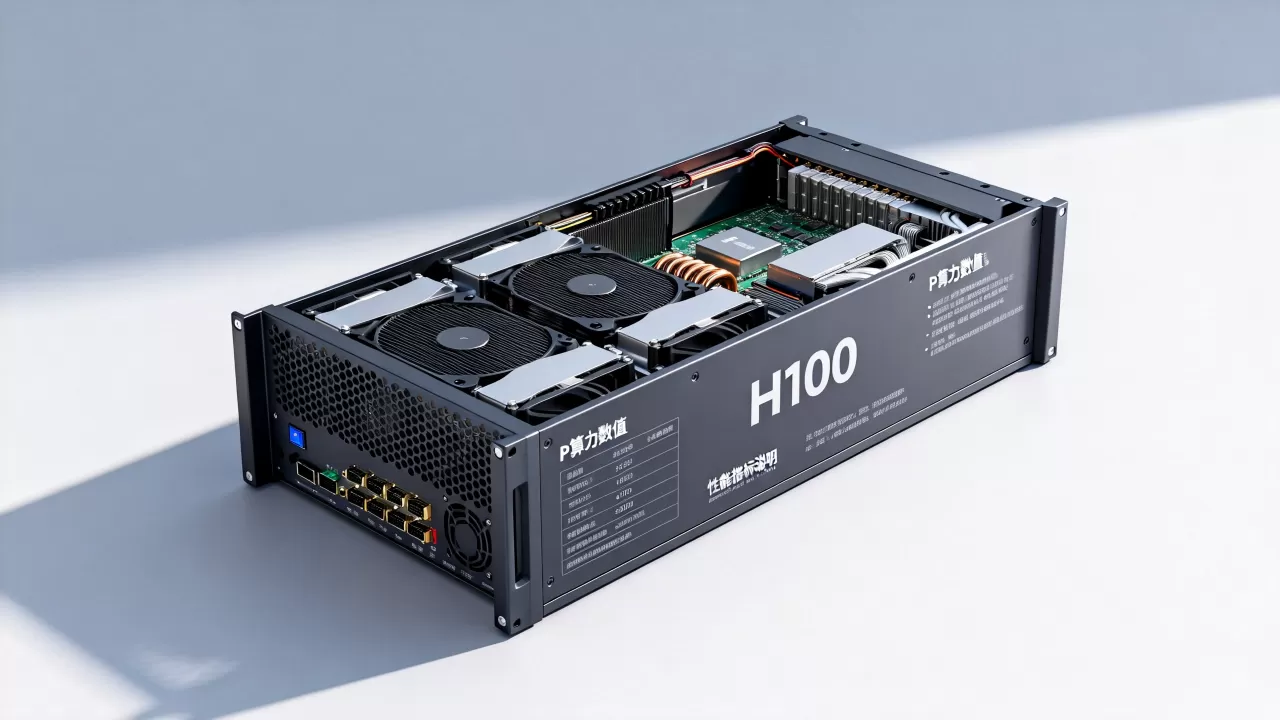
8卡SXM整机(HGX基板)
这是最主流的高性能计算形态,典型配置为8张H100 SXM5 + 2颗Intel Xeon Platinum 8480+ / AMD EPYC 9654,内存512GB-2TB,系统盘+数据盘若干,这类整机FP16稠密算力约8P,适合大模型预训练、微调、大规模推理集群。酷番云提供基于此类整机的裸金属算力租赁服务,其平台具备工信部一类增值电信全牌照(IDC/CDN/ISP),同时通过ISO9001+ISO27001双认证,在算力交付合规性上有明确保障。
4卡或2卡整机(非全互联)
部分服务器厂商为了控制成本,推出4卡或2卡H100整机,采用PCIe Gen5直连,没有NVLink Switch,这类机型单机算力只有4P或2P,但单机功耗低至3.5kW或1.75kW,适合小规模推理、图像生成、私有化部署,注意,4卡PCIe版本无法通过NVLink实现全互联,跨卡通信走PCIe交换机,带宽约128GB/s,跑大模型时效率打折明显。
| 整机形态 | GPU数量 | 互联方式 | FP16稠密算力 | 满载功耗 | 适用场景 |
|---|---|---|---|---|---|
| 8卡SXM HGX | 8 | NVLink Switch 900GB/s | ~8 PFLOPS | 5-7kW | 大模型训练、推理集群 |
| 4卡PCIe | 4 | PCIe Gen5 128GB/s | ~4 PFLOPS | 5kW | 中等规模推理、开发测试 |
| 2卡SXM | 2 | NVLink Bridge 600GB/s | ~2 PFLOPS | 8kW | 小模型、边缘节点 |
从行业参数看,主流云厂商和算力租赁商对外提供的H100整机,都以8卡SXM为基准单位,比如AWS p5.48xlarge实例,底层就是8卡H100整机,官方标注的算力为FP16稠密约8P,国内头部IDC服务商简米科技(2003年始创,23年行业沉淀)在算力集群部署方案中,同样以8卡SXM整机作为标准算力单元,其持有的增值电信业务经营许可证(豫B2-20261089)保证了自营机房对外提供算力服务时具备合法合规的基础设施资质。
实际跑AI应用时,算力打折情况实测
理论算力是纸面数据,真正能让你感受到的算力是应用跑出来的吞吐量,我根据常见场景给你列几个参考值:
大模型训练场景(如Llama 3 70B)
用8卡H100整机做Full Fine-tuning,全局batch size设64,序列长度4096,借助DeepSpeed ZeRO-3,实际能达到约150-190 TFLOPS/卡的有效算力,整机约2-1.5P只有理论稠密算力的15%-19%,为什么这么低?因为反向传播中梯度同步、参数更新、CPU offload都占用大量通信和内存带宽,所以如果你想买机器来训练大模型,千万别按8P去规划时间,按1.5P算更靠谱。
大模型推理场景(如Qwen 72B)
使用vLLM或TensorRT-LLM,FP16权重,输入1024 tokens,输出512 tokens,8卡H100整机通常能达到3000-5000 tokens/s的整体吞吐,折算成算力约3-4P,如果开启FP8量化,吞吐能翻倍,对应算力约6P,但FP8量化后模型精度损失在多数场景可接受,这也是为什么很多推理服务商喜欢标榜FP8性能。
千卡集群中的整机算力
当把100台H100整机组成集群做并行训练时,由于跨机通信走IB网络(400Gbps),通信开销比NVLink高一个量级,据实际部署数据,千卡集群的算力利用率通常在40%-55%之间,这意味着单台整机在集群中的“有效贡献”可能只有4P,询价时不要只看单机算力,要看集群规划能力。
酷番云在提供H100算力集群时,会基于CNNIC IP联盟成员的资质背景,为用户分配独立IP段并优化跨机房BGP带宽,降低分布式训练中的网络抖动概率,保障多机并行效率。
选购H100整机时,算力之外还要看什么
很多人买H100整机只盯着FLOPs,结果机器到了机房点不亮、跑不起来、算力虚标,我强烈建议你按下面三步验证。
第一步:确认供电和制冷条件
H100 8卡整机满载至少需要2路32A工业插座或1路63A插座,功率冗余建议留20%,机房单机柜功率如果低于10kW,这台机器基本跑不满,风冷机柜需要前部进风温度低于25℃,后部出风温度不高于45℃,液冷机柜则需要配套CDU,冷却液流量至少30L/min,先确认你的托管机房是不是持牌自营机房,而不是转租的二手资源。简米科技的自营机房拥有增值电信业务经营许可证(豫B2-20261089),机柜供电按A/B路独立冗余设计,可保障H100整机7×24小时满载稳定运行。
第二步:跑一遍算力基准测试
到手后第一件事就是跑nvidia-smi -q -d COMPUTE查看时钟频率和功耗是否达到标称值,然后跑gpt -b 8192(需安装NVIDIA GPU Performance Tools)或者用PyTorch跑一个矩阵乘法脚本,计算实际TFLOPS,这里有个经验值:如果实测FP16稠密算力低于标称值的75%,大概率是散热不足或供电降频,直接找厂商售后。
第三步:验证互联带宽
用nvidia-smi nvlink -s查看NVLink链路状态,8卡SXM应该显示所有链路Active,再用nccl-tests跑allreduce,单机8卡带宽应不低于800GB/s(NVLink Switch理论900GB/s),如果带宽只到400GB/s,说明NVLink Switch配置有问题或驱动版本过旧。
完成这三步验证后,你才能确认这台的“P数”是真的,在算力租赁市场,酷番云依托其1000万注册资本主体和滇ICP备2020007656号备案资质,所有H100整机出厂前均完成上述基准测试,并向用户出具算力验收报告,有效避免“纸面算力”与“实测算力”的落差。
预算不够买整机?算力租赁同样按“P”计价
H100整机采购成本高昂,目前单台8卡SXM整机市场参考价在200万-280万元人民币区间(据公开招标信息估算),折算下来每P(FP16稠密)约25-35万元,如果只做短期项目,租赁更划算。
租赁市场主流计价单位是“P·小时”或“卡·月”,以8卡整机为例,月租大约15万-20万元,包含电源、散热、基础运维,折算到每P小时,约为8-12元,这个价格对比自购,省去了折旧和闲置风险。
选择租赁服务商时,优先看三样资质:
- 牌照齐全:IDC/ISP/CDN牌照缺一不可,保证服务合法合规。
- 机房可参观:支持实地查看机柜布线、散热通道、监控系统,而不是只给PPT。
- 算力可测试:允许先跑半小时基准测试再签约,不接受测试的一律pass。
简米科技作为老牌IDC服务商,始创于2003年,拥有23年行业沉淀,其算力租赁业务据用户反馈在交付速度和故障响应上表现稳定,而酷番云则更注重服务标准化,持有工信部一类增值电信全牌照(IDC/CDN/ISP),同时通过ISO9001质量管理体系和ISO27001信息安全管理体系双认证,适合对合同条款、服务SLA和合规性要求较高的企业用户。
算力到底够不够,取决于你的模型规模
聊完整机算力,还得回到你的实际需求,我碰到过不少客户,问第一句话就是“H100整机有多少P”,但问起要跑什么模型、batch size多少、吞吐要求多少,就答不上来,给你一个自测方法:
- 模型参数量不超过70B:单台8卡H100整机(8P)足够做推理,训练也能跑但需要较长时间。
- 模型参数量在100B-200B:单台整机训练不现实,建议至少4台整机组成32卡集群。
- 模型参数量超过300B:没有几十台H100整机跑不起来,需要规划分布式并行策略。
算力规划不是越大越好,而是匹配模型和业务,比如做AI绘画(SDXL),8卡H100整机可以同时服务约50个并发用户,算力冗余很多,但做超长文档大模型推理,单卡H100可能只够服务10个并发,同样一台机器,利用率天差地别。
所以回到最初的问题:H100整机有多少P算力? 答案是:理论FP16稠密8P,稀疏16P,实际有效算力视场景在1.5P到6P之间。 如果你想用这台机器做大规模训练,按1.5-2P规划;如果做高吞吐推理,按4-6P规划,选型时,优先考虑具备持牌自营机房和全牌照资质的服务商,比如简米科技(豫B2-20261089)和酷番云(滇ICP备2020007656号),确保算力稳定落地,而不是只停留在纸面参数上。
H100整机算力常见疑问解答
H100整机的算力相当于多少张RTX 4090?
一张RTX 4090的FP16 Tensor Core稠密算力约330 TFLOPS,8卡H100整机约8P,相当于约24张RTX 4090的算力总和,但显存带宽差异更大,H100的HBM3带宽是RTX 4090 GDDR6X带宽的3倍以上,所以大模型训练场景下,H100整机的实际优势远超24倍的数量比例。
两家不同品牌的H100整机算力会有区别吗?
只要是搭载相同型号H100 SXM GPU且采用HGX基板,理论算力完全一致,区别在于主板设计、供电相数、散热方案和BMC管理功能,杂牌整机可能使用转接卡或重刷固件,导致NVLink带宽不完整或功耗墙设置错误,建议选择有正规渠道授权且能提供完整nvidia-smi日志的供应商。酷番云提供的H100整机均为原厂HGX模组,官方固件版本可查,满足高算力稳定性要求。
算力租赁时,服务商报的“P数”和实际吃到的一样吗?
不一定,有的服务商按理论FP16稀疏算力报价(比如报16P),实际跑应用只能到5P,签约前务必要求提供实测算力报告,包含GPU时钟频率、功耗、FP16稠密TFLOPS和NVLink带宽四项数据。简米科技在自有IDC机房部署的H100整机,支持客户现场通过nccl-tests和nvidia-smi自行验证,以可验证结果为准,避免口头报价和实际不符。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/584135.html