IT基础运维管理是企业IT系统稳定运行的基石,一个成熟的运维管理体系能显著降低业务中断风险并提升运维效率。
IT基础运维管理包含哪些关键环节
基础设施监控:从硬件到服务的全面覆盖
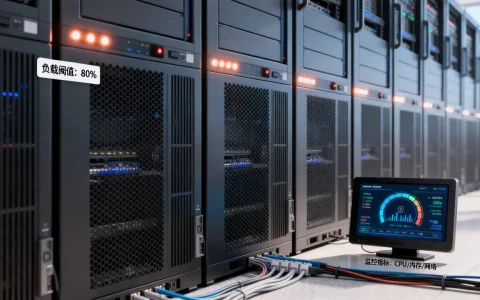
监控是运维的“眼睛”,你需要覆盖服务器、网络设备、存储系统以及数据库中间件的实时状态采集,核心指标包括CPU使用率、内存占用、磁盘IO、网络延迟和吞吐量。
Prometheus配合Grafana是目前最流行的开源监控组合,Zabbix则更适合传统网络设备监控,以Prometheus为例,完整部署包含以下步骤:
- 在每台服务器上安装Node Exporter,默认监听端口9100。
- 在Prometheus配置文件
prometheus.yml中增加job,指定target为服务器IP:9100。 - 启动Prometheus,确认采集状态正常(可在Web UI的Targets页面查看)。
- 在Grafana中添加Prometheus数据源,导入官方仪表盘(如Node Exporter Full模板)。
- 配置Alertmanager规则,设置告警接收渠道(邮件、钉钉、Slack),当CPU使用率持续超过80%时触发告警。
一个完整的监控方案应覆盖所有生产环境节点,避免监控盲区,日志监控推荐使用ELK(Elasticsearch、Logstash、Kibana)或Loki,集中收集和分析日志有助于快速定位问题。
事件与故障管理:标准化处理流程
当故障发生时,按标准流程处理能大幅缩短MTTR(平均修复时间),标准流程包括:故障发现、分类、初步诊断、升级处理、修复验证、故障复盘。严格执行事件管理流程的团队,故障处理效率能提升相当比例。
以数据库连接池满故障为例,具体排查步骤:
- 发现告警:应用监控提示数据库连接超时,错误率上升。
- 初步诊断:登录数据库,执行
SHOW PROCESSLIST查看当前连接数,发现请求堆积。 - 临时措施:紧急重启应用释放连接,或调整连接池参数(如
max_connections=200)。 - 根源分析:检查是否有慢查询导致连接长期占用,开启慢查询日志(
SET GLOBAL slow_query_log=ON),分析慢SQL。 - 永久修复:优化慢查询(添加索引、改写SQL),同时调整连接池最大连接数并配置空闲超时。
- 验证:持续观察一段时间,确认连接池使用正常,错误率归零。
- 复盘:记录故障原因,更新知识库,修正监控阈值。
建议使用ITSM工具(如Jira Service Management、ServiceNow)记录所有事件,确保每个事件都有明确的负责人和状态跟踪。
变更管理:控制操作风险
变更操作是运维中风险最高的环节。
行业共识认为,没有经过评审的变更应禁止在生产环境执行。 变更管理流程包括:变更申请、风险评估、审批、实施计划、回滚方案、变更实施、验证关闭。
以Linux内核参数优化为例,变更前需备份原有配置(sysctl -a > /tmp/sysctl_backup.conf),制定回滚步骤,在低峰期执行,并监控变更后的系统表现,建议使用自动化工具如Ansible执行标准化变更,减少人为失误,示例playbook:
- name: 优化内核参数
  hosts: all
  become: yes
  tasks:
    - name: 配置vm.swappiness
      sysctl:
        name: vm.swappiness
        value: "10"
        sysctl_set: yes
      notify: 重启服务
IT运维管理流程如何落地
将流程制度化需要结合企业实际规模和场景,小型企业可能只需简单的脚本和共享文档,而大型企业需要完整的ITIL框架。
从被动救火到主动预防
很多运维团队长期处于被动响应状态,要改变局面,需要建立巡检制度和容量规划,每周生成巡检报告,检查系统日志、磁盘空间、证书有效期等,容量规划基于历史数据预测未来资源需求,提前扩容。
根据过去三个月的用户增长趋势,预估数据库存储需求,提前申请资源,巡检脚本示例:
#!/bin/bash
# 检查磁盘使用率
df -h | grep -vE '^Filesystem|tmpfs|cdrom' | awk '{ print $5 " " $1 }' | while read output;
do
  usage=$(echo $output | awk '{ print $1}' | cut -d'%' -f1)
  partition=$(echo $output | awk '{ print $2 }')
  if [ $usage -ge 80 ]; then
    echo "WARNING: partition $partition is $usage% full"
  fi
done
知识库驱动的问题解决
将常见故障处理方案整理成知识库,能显著降低重复性问题处理时间,知识库条目应包括:故障现象、可能原因、排查步骤、解决方案、验证方法。业内专家指出,知识库的维护需要持续投入,但长期来看是降低运维成本最有效的手段之一。 建议使用Confluence或企业内部Wiki维护,当新员工遇到类似问题时,可快速检索知识库获取答案,避免每次都需要求助资深工程师。
自动化流程减少人工干预
自动化是IT运维管理流程落地的关键抓手,对于重复性操作,如用户权限开通、应用发布、日志归档等,应尽量通过脚本或平台实现自动化,以应用发布为例,使用Jenkins Pipeline实现代码构建、测试、部署的自动化流水线,发布过程无需人工参与,降低出错概率。自动化程度高的团队,变更成功率有明显提升。
IT基础运维管理工具选型指南
工具选择需要结合技术栈、团队规模和预算,下面是常见的几类工具对比。
监控与告警工具
| 类别 | 开源方案 | 商业方案 |
|---|---|---|
| 指标监控 | Prometheus + Grafana | Datadog, New Relic |
| 日志监控 | ELK, Loki | Splunk, Sumo Logic |
| 网络监控 | LibreNMS, Cacti | SolarWinds, PRTG |
| 综合平台 | Zabbix, Nagios | ServiceNow ITOM |
选择时,如果团队有较强的开发能力,可以优先考虑开源方案,灵活性高且成本可控,如果团队人力不足,商业方案能提供开箱即用的体验,但需考虑许可费用,对于中小型企业,Prometheus + Grafana是相当受欢迎的组合。
自动化运维工具
- 配置管理:Ansible(无代理,基于SSH,简单易用)、Puppet(基于声明式语言)、Chef(基于Ruby)。
- 批量操作:SaltStack(基于ZeroMQ,速度快)。
- 编排工具:Terraform(基础设施即代码),适用于多云环境。
- 容器管理:Kubernetes,Docker Compose用于容器编排。
根据实际场景选择,多数传统企业使用Ansible来管理服务器配置,因为学习成本低,不需安装Agent。
ITSM与流程管理工具
- 开源:iTop, OTRS。
- 商业:Jira Service Management, ServiceNow, Freshservice。
- 选择要点:看是否支持自定义流程、CMDB、报表和工作流引擎。
IT运维管理怎么做才能降本增效
降本增效是运维管理者的核心目标,可以从以下几个方面入手。
标准化与模板化
为服务器、应用、中间件制定标准部署模板,新环境部署时直接使用模板,减少配置差异导致的故障,使用Packer创建统一镜像,新服务器创建后即具有标准配置,或使用Ansible编写标准化角色,一键部署。
运维自动化
将日常重复工作自动化,如备份脚本、日志清理、健康检查,使用Crontab或Ansible Tower定期执行,以日志清理为例,写一个脚本查找7天前的日志并压缩归档,设置定时任务每周执行一次。
#!/bin/bash
find /var/log/myapp -type f -name ".log" -mtime +7 -exec gzip {} ;
建立SLA与考核机制
定义服务级别协议(SLA),如故障响应时间<30分钟,故障恢复时间<4小时,通过考核机制促使运维团队提升效率,定期复盘SLA达成情况,找出瓶颈。
成本控制实践
- 云资源优化:从实例规格、存储类型、网络流量等方面分析,使用预留实例或Spot实例降低成本。
- 开源工具替代商业软件:在满足需求的前提下,优先使用开源方案。
- 人员培训:提升团队技能,减少外部咨询费用。
IT运维管理成本与预算规划
不同规模的企业在IT运维管理上的投入差异很大,小型企业可能每月几千元用于基础监控和云服务,中型企业每年投入几十万用于工具和人员,大型企业则可能上千万。
成本构成要素
- 人力成本:运维工程师薪资,占较大比例,一线城市资深运维工程师年薪可达几十万,二线城市相对较低。
- 工具成本:商业软件许可费用,如Datadog按主机数计费,Splunk按数据量计费。
- 基础设施成本:服务器、存储、网络设备采购或云服务费用。
- 培训与咨询成本:提升团队能力或引入外部专家。
ROI评估思路
评估运维投入的回报可以从故障损失减少、效率提升、资源利用率优化等方面计算,通过自动化部署,发布周期从每周一次缩短到每天多次,业务响应速度提升,间接带来收入增长,具体计算时,统计引入工具前后每月平均故障时长和次数,折算成业务损失,对比工具成本。
常见预算误区
- 只买工具不注重流程:工具只是支撑,流程才是核心。
- 忽视人员培训:再好的工具也需要人操作。
- 过度堆砌监控指标:导致告警疲劳,真正重要的告警被淹没。
IT基础运维管理不是一次性的项目,而是一个持续优化的过程。 从监控、事件管理到自动化,每一步都需要结合企业实际不断调整,只有将运维管理上升到战略层面,才能为业务创新提供坚实底座。
IT基础运维管理常见问题解答
IT基础运维管理包含哪些内容?
IT基础运维管理主要包括基础设施监控、事件与故障管理、变更管理、配置管理、容量管理、备份恢复、安全运维等,核心目标是保障IT系统的稳定、高效、安全运行。
IT运维管理流程有哪些关键步骤?
关键步骤包括:事件发现与记录、分类与初步支持、优先级评定、升级处理、解决方案实施、关闭与验证,变更管理、问题管理、发布管理等流程也构成完整体系。
中小企业如何选择IT运维管理工具?
中小企业团队规模小,预算有限,建议优先选择开源工具,如Prometheus、Grafana、Zabbix进行监控,使用Ansible进行自动化配置管理,如果需要ITSM,可选择iTop或Jira Service Management按需付费版,关键是工具要与团队能力匹配,避免过度复杂。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/579641.html