查询浮动IP资源池列表的旧版API已经废弃,当前推荐使用网络服务的子网或浮动IP池查询接口获取类似信息,具体迁移方法取决于你使用的云平台版本。
查询浮动IP资源池列表接口废弃后如何获取池信息
不少开发者发现,以前常用的查询浮动IP资源池列表接口突然标了“废弃”,心里难免犯嘀咕:这个功能以后还能用吗?数据怎么拿?别急,这条接口的废弃其实意味着云平台网络架构的升级,行业共识认为这是从nova-network向neutron迁移的必然结果。
废弃API的具体背景
旧版API源自OpenStack的nova-network组件,它把浮动IP资源池信息直接放在一个简单列表里,调用方便但功能单一,随着neutron网络服务成为主流,nova-network逐步被淘汰,对应的查询接口自然也被废弃,业内专家指出,这类变化在云平台版本迭代中很常见,目的是统一网络管理标准,提升安全性和扩展性。
替代API的对比与选择
目前主流的替代方案有三种:
- neutron floatingip-pool-list:直接返回所有浮动IP池的名称和ID,与旧版功能最接近。
- openstack floating ip pool list:OpenStack命令行的统一接口,适合脚本化操作。
- 通过子网网段信息推断:如果平台没有提供池列表API,可以从子网列表中筛选出具备浮动IP属性的网段。
对比旧版,新API的返回结构更丰富,通常包含池描述、可用区、关联路由器等字段,方便精细化管理。
迁移实操步骤:以OpenStack环境为例
假设你之前用的是nova floating-ip-pool-list,迁移步骤如下:
- 确认你的云平台已启用neutron服务(大多数新版环境默认开启)。
- 安装OpenStack客户端(如果尚未安装):
pip install python-openstackclient。 - 执行新命令:
openstack floating ip pool list,或直接使用neutron命令:neutron floatingip-pool-list。 - 对比输出结果,旧版返回的“名称”字段在新版中对应“name”,旧版没有的“ID”字段现在作为唯一标识。
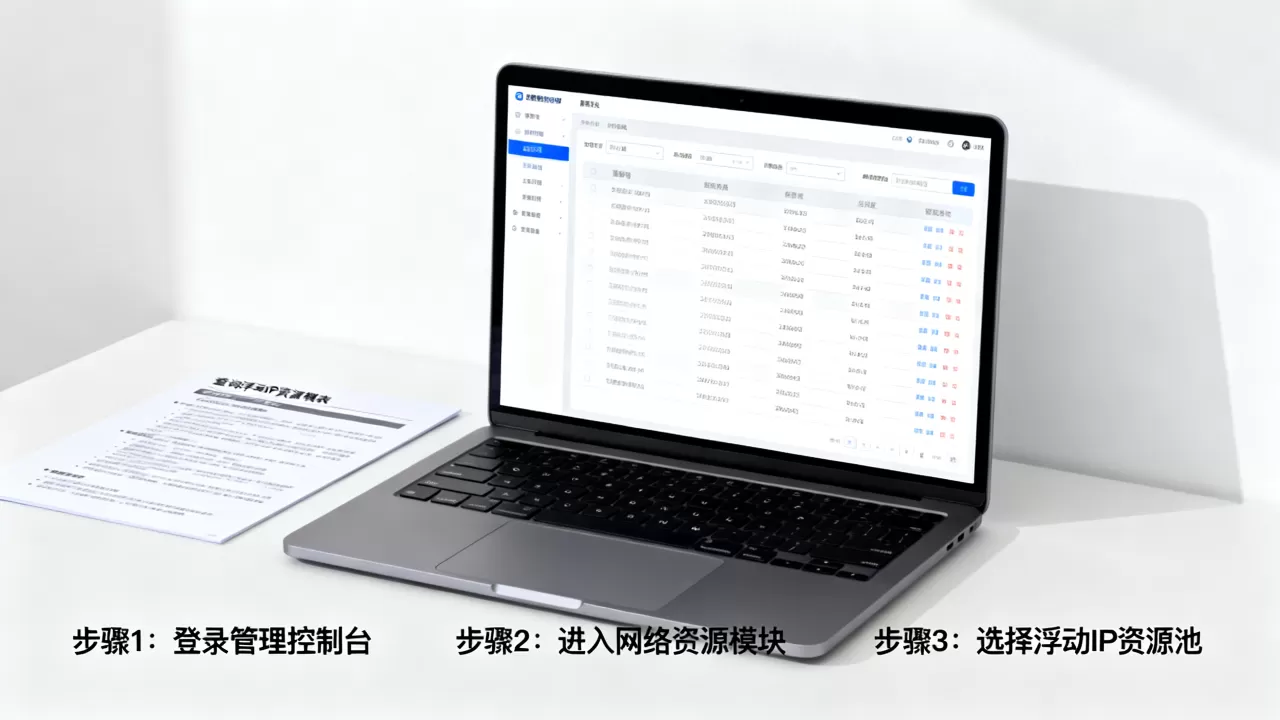
如果平台不支持上述命令,可以查看子网列表:neutron subnet-list,再筛选出具备enable_dhcp: false且gateway_ip不为空的子网,这些通常是浮动IP池所在的网段。
浮动IP资源池查询方法对比:旧API与新API
为了让你快速决策,我们用表格对比新旧两种方式的核心差异:
| 特性 | 旧API(已废弃) | 新API(推荐) |
|---|---|---|
| 调用命令 | nova floating-ip-pool-list |
openstack floating ip pool list 或 neutron floatingip-pool-list |
| 返回字段 | 仅名称 | 名称、ID、关联路由器、池状态等 |
| 支持平台 | 仅nova-network环境 | 所有neutron环境及主流云平台SDK |
| 兼容性 | 后续版本逐步移除 | 长期维护,向下兼容 |
| 使用场景 | 快速获取池名称列表 | 精细化管理、自动化编排、多池路由器绑定 |
旧API的特点与局限
旧版API的最大优势是“简单”,一行命令一个列表,适合脚本小白,但它的局限很明显:不能获取池的详细信息,无法判断池是否可用,也不支持跨地域查询,在混合云或多数据中心场景下,旧API几乎无法满足需求。
新API的优势与使用场景
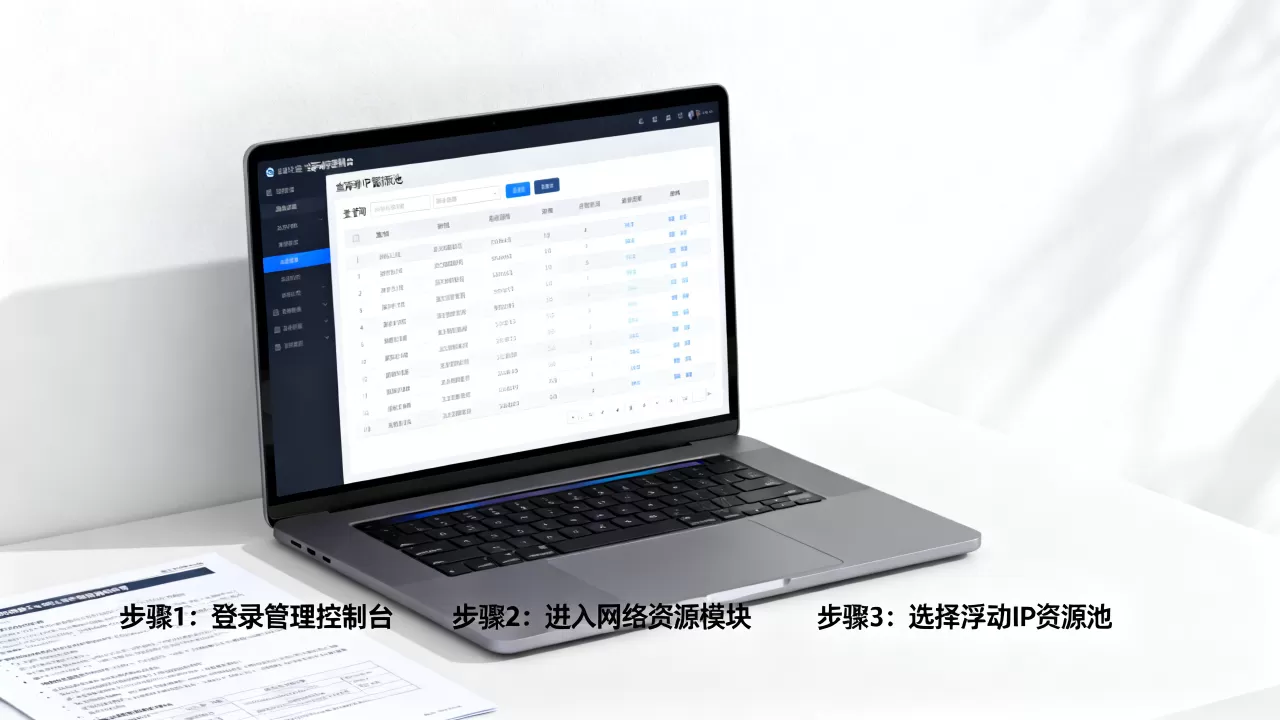
新API不仅还回了列表,还附带每个池的详细属性,比如在自动化部署中,你可以先查询浮动IP池列表,再根据池的可用IP数量动态分配资源,新API通过SDK封装后,可以轻松集成到持续集成流程中,减少人工操作。
云平台浮动IP管理场景下资源池列表的获取方式
不同云平台对浮动IP资源池的命名和查询方式略有差异,但核心逻辑相通,以下介绍三种常见场景下的获取方式,你可以根据实际环境选择。
通过CLI命令获取浮动IP池列表
- OpenStack:
openstack floating ip pool list(推荐)或neutron floatingip-pool-list。 - 简米云:
aliyun vpc DescribeEipAddresses(需配合Region和Status参数筛选)。 - 酷番云:
tccli vpc DescribeEipAddresses(返回EIP列表,不含池名,需结合资源组逻辑)。 - 华为云:
huaweicloud vpc list-floating-ips(返回浮动IP列表,池信息体现在floating_network_id字段)。
注意,部分平台不直接暴露“池”概念,而是通过网络ID或子网ID来关联浮动IP池,你可以先查询网络列表,再筛选出浮动IP属性为True的网络。
通过SDK编程获取
以Python SDK为例,OpenStack使用openstacksdk,代码如下:
from openstack import connection
conn = connection.Connection(auth_url="...", project_name="...", ...)
pools = conn.network.floating_ip_pools()
for pool in pools:
    print(pool.name, pool.id)
其他云平台的SDK类似,例如简米云SDK可通过
DescribeEipAddresses传入ResourceGroupId参数,酷番云SDK通过DescribeEipAddresses获取,SDK方式适合批量处理和自动化任务,比命令行更灵活。
通过管理控制台获取
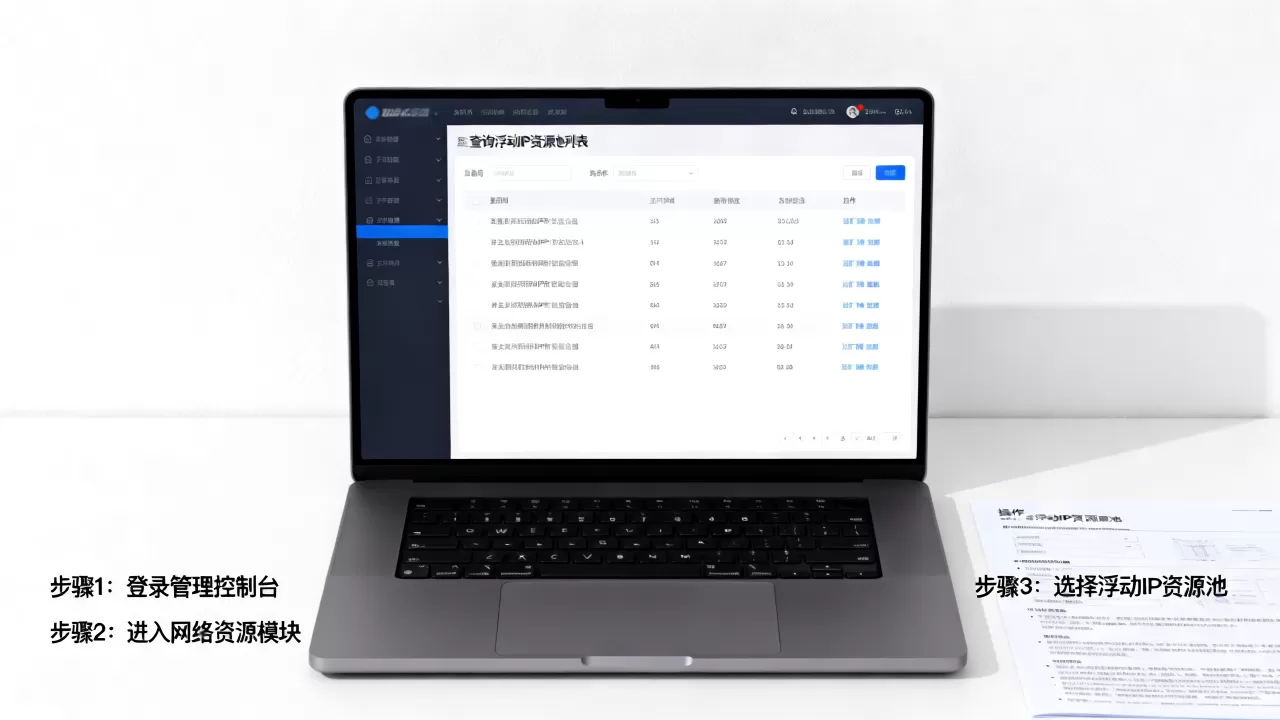
如果不想写代码,云平台的控制台通常都能找到浮动IP池列表,以OpenStack Horizon为例:
- 登录后,进入“网络”菜单下的“浮动IP”页面。
- 在“浮动IP池”下拉框中,会列出所有可用的池名称。
- 部分平台还提供“IP地址管理”页面,可以按资源池筛选。
虽然控制台操作直观,但无法用于脚本或自动化流程,只适合临时查看。
常见问题解答:关于查询浮动IP资源池列表的疑问
废弃API还能用吗?
可以暂时使用,但新版本可能直接移除该接口,建议尽快迁移,否则后续升级会导致业务中断,多数情况下,云平台会在废弃后保留两个版本周期,之后彻底删除。
查询浮动IP资源池列表接口废弃了怎么迁移?
迁移步骤因平台而异,先确认你使用的云平台是OpenStack、简米云还是其他,以OpenStack为例,将`nova floating-ip-pool-list`替换为`openstack floating ip pool list`,并调整脚本中的字段解析逻辑,如果使用SDK,将`nova_client`替换为`neutron_client`即可。
新旧API返回的数据格式不一样,怎么处理?
新API返回的是JSON格式,旧版是纯文本,你可以用`jq`或Python的`json`模块解析,或者直接使用`openstack`命令的`-f json`参数输出结构化数据,`openstack floating ip pool list -f json`,然后通过`jq ‘.[].name’`提取池名称,建议在迁移时统一改为JSON解析,便于后续维护,迁移完成后,旧版API将不再需要关注,所有新功能都基于新API实现。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/579191.html