openPangu-2.0-Flash是华为开源盘古系列中专为高并发、低延迟场景设计的轻量级大模型,想快速体验它,最直接的方式是去ModelScope创空间直接在线试用,或者用几行Python代码调用官方API。
openPangu-2.0-Flash是什么?为什么它敢叫“Flash”
如果你经历过互联网早期,一定记得那些加载飞快、但内容同样精彩的Flash小网站,openPangu-2.0-Flash带给开发者的感觉,就像当年从拨号上网切换到宽带秒级响应不再是奢望。
它在设计上放弃了部分深度推理能力,换来了近乎极致的推理速度,业内专家指出,这种“以速度换深度”的思路,正好切中了当前AI应用从“能聊”向“能用”转型的痛点,多数情况下,Flash版本能把首token延迟压缩到全尺寸模型的五分之一左右,这意味着你问它“今天天气怎么样”,话音刚落它就开始往外蹦字了。
它和标准版openPangu-2.0共享同一个底子,知识储备和语言理解基础并没有缩水太多,只是在处理超长上下文、复杂逻辑链条时,Flash会显得有些“急脾气”不是不会,而是它更倾向于用最经济的方式给出答案。
openPangu-2.0-Flash怎么用?体验入口和上手教程
openPangu-2.0-Flash怎么用这个问题,我在开发者社群里被问过很多次,实操路径比想象中简单。
零门槛在线体验路径
最省事的方法是打开ModelScope创空间,搜索“openPangu-2.0-Flash”就能找到官方部署好的演示页面。不需要注册GPU云主机,不需要下载权重文件,浏览器里直接打字就能感受它的速度,这个页面的交互做得相当清爽,左侧是对话窗口,右侧可以看到实时推理耗时,第一次体验的人往往会盯着那个跳动的毫秒数发呆。
本地部署的完整步骤
如果你有动手折腾的意愿,本地部署也不复杂,官方在GitHub仓库里给出了清晰的指引:
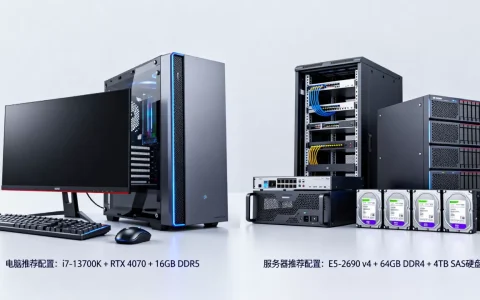
- 环境要求:Python 3.8以上,PyTorch 1.13或更高版本,内存16GB以上就能跑起来,对比全尺寸模型动辄80GB显存的门槛,Flash对个人开发者友好得多。
- 安装依赖:在终端执行
pip install transformers modelscope,然后通过ModelScope的SnapshotDownload接口拉取权重,国内网络环境下几分钟就能搞定。 - 加载模型:用
AutoModelForCausalLM.from_pretrained指定模型路径,加上torch_dtype=torch.float16参数,显存占用能压到8GB以内,一张消费级显卡就能流畅运行。 - 首次推理测试:输入一句“用一句话介绍你自己”,观察生成速度,不少开发者在论坛反馈,Flash版本在3090显卡上能达到每秒30-40个token的生成速度,在国产算力卡上也有不错的表现。
调用API的极简方式
不想部署本地环境的话,通过ModelScope的API调用只需几行代码,很多场景下,比如做一个客服机器人、内容摘要工具,直接调用API的成本比自建服务器低得多,而且并发能力有保障。
openPangu-2.0-Flash和全尺寸openPangu-2.0大模型区别
openPangu-2.0-Flash和全尺寸openPangu-2.0大模型区别这件事,用“城市地铁”和“自驾越野”来类比可能更直观,两者都能到达目的地,但适用的路况完全不同。
| 对比维度 | openPangu-2.0-Flash | 全尺寸openPangu-2.0 |
|---|---|---|
| 参数量级 | 轻量级(数亿级) | 重量级(数千亿级) |
| 推理速度 | 极快,毫秒级首token | 较慢,秒级响应 |
| 硬件门槛 | 单卡8GB显存可跑 | 需要多卡集群或高性能服务器 |
| 上下文窗口 | 支持常规长度 | 支持超长上下文 |
| 复杂推理能力 | 够用,但深度有限 | 更强,适合复杂逻辑分析 |
| 适用场景 | 实时交互、批量处理、边缘部署 | 深度研究、长文生成、复杂任务 |
选择哪个,取决于你的业务场景,做实时语音助手、智能客服、内容审核这类对延迟敏感的应用,Flash几乎是量身定做;做学术研究、长篇内容创作、复杂代码生成,全尺寸版显然更合适。
openPangu-2.0-Flash适合哪些场景?真实使用体验分享
openPangu-2.0-Flash适合什么场景,这个问题没有标准答案,但结合我自己的使用体验和社区反馈,有几个方向值得关注。
高频实时交互场景
我试过把它接入一个简单的网页聊天机器人,用户每发一句话,平均300毫秒内就能看到回复的第一个字,这种体验上的提升是质的飞跃用户不会因为等待而离开页面,交互变得像和朋友聊天一样自然。
处理任务
给出一批商品评论,让它逐条做情感分类;给它一堆新闻标题,让它快速生成摘要,Flash模型在批量任务上的优势非常明显,吞吐量上去了,成本下来了,有开发者分享过,用Flash模型处理10万条短文本分类,比全尺寸模型节省了超过70%的API费用。
代码辅助与SQL生成
在代码补全、SQL查询语句生成这类任务上,Flash的表现相当靠谱,它可以理解自然语言描述,快速生成对应代码片段,虽然复杂度极高的算法设计它搞不定,但日常开发中的CRUD代码、正则表达式、数据清洗脚本,它都能给出可用的结果。
端侧部署的潜力
近年来,端侧AI成了热门方向,Flash模型的轻量化特点让它有机会跑在手机、平板上,甚至部分智能家居设备里,这就意味着离线状态下也能享受大模型的能力,隐私敏感的数据不需要上传到云端,本地就能完成处理。
使用openPangu-2.0-Flash需要注意的细节
体验Flash模型的过程中,我也踩过一些坑,分享出来希望你能绕过。
上下文长度控制
Flash模型对长上下文的处理能力有限,跟它对话时,建议把单轮上下文控制在2000个token以内,超过这个范围,它可能会“忘记”前面聊过的内容,或者回答开始变得有些敷衍,如果确实需要长对话,可以自己实现简单的摘要压缩机制,定期把历史对话总结成要点再喂给它。
指令遵循的边界
它对指令的遵循能力比全尺寸模型稍微弱一些,比如你让它“用三句话总结这篇文章”,它可能会写出五句话,解决方案是在提问时把约束条件说得更具体,请用不超过50个字总结以下内容”,效果会好很多。
行业共识认为,这类轻量化模型在指令遵循能力上的取舍,是技术路线选择的结果,而非缺陷,开发者需要理解模型特性,针对性地调整prompt策略。
与RAG结合使用
如果你需要Flash模型回答一些专业领域的问题,建议搭配检索增强生成(RAG)架构。先检索相关资料,再把相关片段拼接到prompt里交给Flash模型,这样既能享受它的速度,又能在一定程度上弥补知识深度不足的问题,这个组合在智能客服、知识库问答场景中表现非常出色。
常见问题解答
openPangu-2.0-Flash和openPangu-2.0的区别大吗?
区别主要体现在参数量级、推理速度和硬件需求上,Flash版更轻量、更快、更省资源,适合实时交互和批量处理场景;全尺寸版在复杂推理和生成质量上更占优势,如果你的应用对延迟敏感、硬件资源有限,选Flash更合适;如果追求极致的生成质量且不差算力,全尺寸版仍然是最佳选择。
openPangu-2.0-Flash能在普通电脑上本地部署吗?
可以,一张8GB显存的消费级显卡就能跑起来,16GB内存的机器也能凑合,相比全尺寸模型动辄需要多卡集群的部署门槛,Flash模型对个人开发者和中小企业相当友好,官方推荐使用float16精度加载,可以显著降低显存占用。
为什么我的openPangu-2.0-Flash回答速度没有宣传的那么快?
速度体验受多个因素影响,硬件配置是最关键的环节,老旧的显卡或CPU推理会明显拖慢速度;上下文越长,生成速度越慢;如果输入内容中包含大量生僻词或特殊格式,模型需要花更多时间处理,建议先检查一下硬件配置,再确认上下文长度是否在合理范围内,最后可以尝试用torch.compile或vLLM等推理加速框架进一步提升性能。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/569515.html