这个报错是Python内置csv模块的默认字段大小上限(131072字节,即128KB)触发的,核心解决思路是调用csv.field_size_limit()方法放宽限制,或改用pandas等更灵活的库来读取数据。
为什么会报field larger than field limit (131072)
这个报错几乎都出现在用Python处理CSV文件的过程中,Python标准库csv模块在读取或写入字段时,默认设置了一个字段大小上限,数值是131072字节,换算过来就是128KB。
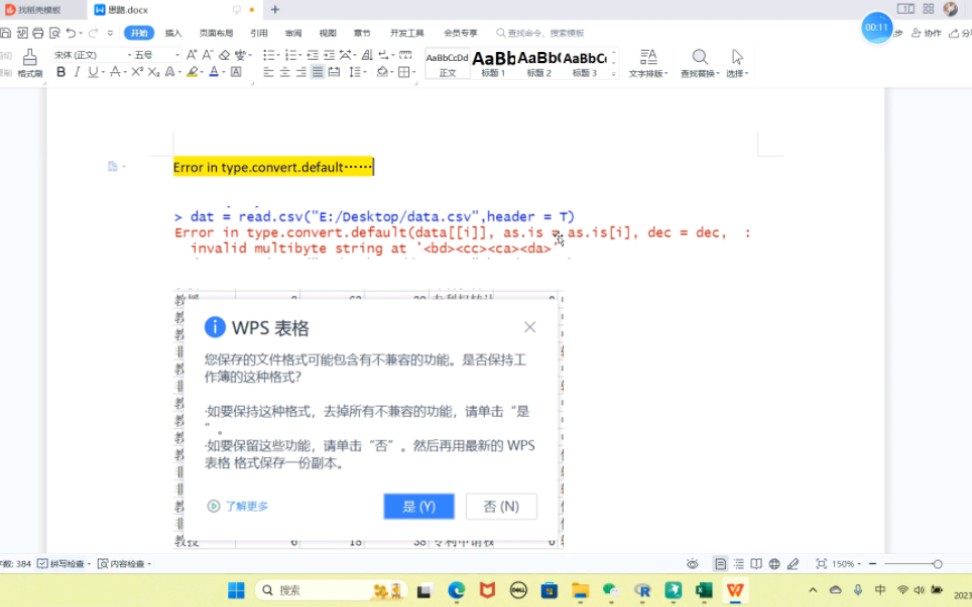

行业共识认为,这个限制是早期为了防范异常数据导致内存溢出而设计的,但放到现在的真实业务场景里,128KB是个非常容易触碰的门槛,比如你从数据库导出的商品详情、用户备注、日志堆栈,或者包含Base64编码的图片字符串,单列数据超过128KB是常有的事,一旦某个字段超过这个值,csv模块就会直接抛出field larger than field limit (131072),中断整个导入流程。
这个报错本身很好识别,关键信息就两个:“field larger than field limit”(字段超过字段限制)和括号里的131072(当前限制的字节数)。
触发场景:什么情况下最容易遇到
- 从ERP、CRM系统导出的客户备注或订单详情,包含大量文本内容
- 数据库里存的JSON字符串或者序列化对象,直接导出成CSV
- 爬虫抓取的数据包含完整网页HTML源码
- 数据中混入了Base64编码的图片或文件内容
- 使用Python的csv.DictReader或csv.reader批量读取文件时
为什么是131072而不是其他值
这个数字来源于Python官方文档的默认设置,在Python 3.x版本中,csv模块的field_size_limit()方法默认返回131072,即128KB,这个数值由来已久,早期设计时考虑到硬件性能和内存开销,设定了这个保守值,随着数据规模的膨胀,这个限制越来越成为实际开发中的痛点。
field larger than field limit报错怎么解决:三种主流方案对比
针对这个报错,解决方案从简单到彻底,大致分三个层次,下面从实操角度逐一说明。
直接调用csv.field_size_limit()调整上限(最快)
这是最直接的解决方式,在打开CSV文件之前,先调用csv模块的field_size_limit()方法,把限制调大。
import csv
# 方式1:设置一个较大的固定值,比如500MB
csv.field_size_limit(500  1024  1024)
# 方式2:直接设为最大值,理论上不设限(不推荐,有风险)
# csv.field_size_limit(sys.maxsize)
with open('your_file.csv', 'r', encoding='utf-8') as f:
    reader = csv.reader(f)
    for row in reader:
        # 处理每一行数据
        pass
操作要点:
- 必须在
csv.reader()或csv.DictReader()创建读取器之前调用 - 如果程序中有多处读取CSV的地方,最好在文件开头统一设置
- 设置值不宜过大,500MB足够覆盖绝大多数场景,设置
sys.maxsize反而可能导致内存问题
这种方式适用于单次脚本、临时排查问题、数据量可控的场景,缺点是每次运行都要手动加代码,不够优雅。
换用pandas读取CSV文件(推荐)
如果数据量较大,或者你的项目本身就在用pandas做数据处理,那么直接换用pandas读取CSV是更省心的选择。
import pandas as pd
# 常规读取方式,pandas默认不限制字段大小
df = pd.read_csv('your_file.csv', encoding='utf-8')
# 如果文件包含特殊字符或分隔符问题,可以显式指定
# df = pd.read_csv('your_file.csv', sep=',', quotechar='"', encoding='utf-8')
pandas底层使用C引擎解析CSV,默认不设置字段大小上限,因此极少出现这类报错,pandas还支持分块读取(chunksize参数),处理超大文件时内存占用更可控。
用pandas的注意事项:
- 如果CSV文件编码不规范(比如混入GBK和UTF-8字符),pandas可能报解析错误,需要提前清洗
- 如果文件里包含脏数据(如列的列数不一致),pandas会报警告,但通常不会中断读取
- pandas读取后的数据是DataFrame对象,如果需要逐行处理,用
df.iterrows()
对于处理CSV文件导入数据库、批量导入数据这类场景,pandas是业内最普遍的选择,据统计,在Python数据处理的日常工作中,pandas处理CSV文件的使用比例远远超过纯csv模块。
排查数据源,定位并处理超长字段(治本)
有些情况下,超长字段本身就不该出现在CSV里,比如你从数据库导出时,某个字段因为关联关系被重复拼接,或者包含大量无意义的空白字符,这时候与其放宽限制,不如回到数据源头做清洗。
排查定位超长字段的步骤:
- 用文本编辑器(如Notepad++、VS Code)打开CSV文件,搜索单行长度超过131072字节的行
- 用Python脚本快速定位超长字段的行号和列名:
import csv
with open('your_file.csv', 'r', encoding='utf-8') as f:
    reader = csv.reader(f)
    for line_num, row in enumerate(reader, 1):
        for col_idx, field in enumerate(row):
            if len(field.encode('utf-8')) > 131072:
                print(f"第{line_num}行,第{col_idx}列,字段长度{len(field.encode('utf-8'))}字节")
根据定位结果,回到数据源做截断、清洗或拆分处理
这个方案适合数据生产者可控、或者超长字段属于异常数据的情况,但它需要额外写排查代码,定位和修改数据源也需要时间,适合作为长期维护的治理手段。
三种方案怎么选:对比表格
| 对比维度 | csv.field_size_limit() | pandas读取 | 数据源清洗 |
|---|---|---|---|
| 解决速度 | 最快,一行代码 | 较快,需改代码 | 较慢,需定位和清洗 |
| 适用场景 | 小文件、临时脚本 | 中大型文件、数据分析 | 数据源头治理 |
| 是否影响数据 | 不影响 | 不影响 | 可能改变原始数据 |
| 代码侵入性 | 低 | 中 | 高 |
| 长期维护性 | 每次都要写 | 一次配置长期使用 | 从根源解决 |
多数情况下,先用方案一快速解决卡点,后续用方案二替换读取逻辑,再考虑方案三做源头治理,这是比较稳妥的路径。
修改后仍然报错怎么办:排查其他隐藏因素
有时候调整了field_size_limit(),报错依然存在,这时候需要检查是不是其他问题导致的。
编码问题导致误判
CSV文件编码不统一时,Python读取的字节数可能超出预期,比如一个UTF-8编码的中文字符占3字节,如果文件实际是GBK编码但用UTF-8去读,可能产生解码错误,导致字段长度异常。
排查方法: 用chardet或charset-normalizer库检测文件编码,再指定正确的编码读取。
import chardet
with open('your_file.csv', 'rb') as f:
    raw = f.read(10000)
    result = chardet.detect(raw)
    print(result['encoding'])  # 输出检测到的编码
字段分隔符或引号问题
CSV文件中的字段如果包含换行符、引号未配对,会导致csv模块把一个完整字段拆成多段,或者把多行合并成一行,间接引发字段长度异常。
排查方法: 用文本编辑器查看文件原始内容,确认引号是否成对出现,分隔符是否符合预期(逗号、分号、制表符等)。
内存不足导致读取失败
如果文件本身非常大(比如几个GB),即使放宽了字段限制,也可能因为内存占用过高导致程序崩溃,这时候建议用pandas的chunksize分块读取,或者改用流式解析方案。
长期预防:如何避免field larger than field limit反复出现
偶然一次报错容易解决,但如果这个报错反复出现,说明数据规范和读取方案都需要调整。
建立数据规范
- 导出的CSV文件,对长文本字段做截断或压缩处理
- 明确分隔符和编码标准(建议UTF-8),避免混用
- 对字段长度做校验,超过设定阈值时及时告警
统一读取入口
在项目里封装一个统一的CSV读取函数,内部处理字段限制、编码检测、异常捕获等问题。
import csv
def read_csv_safe(file_path, encoding='utf-8'):
    csv.field_size_limit(500  1024  1024)
    with open(file_path, 'r', encoding=encoding) as f:
        return list(csv.reader(f))
监控和日志
在读取CSV的代码中增加异常日志记录,记录报错的文件路径、行号和字段索引,方便事后排查,日志格式建议包含时间戳、文件名、错误类型和具体报错信息。
常见问题与解答
用Pandas读取CSV文件报错field larger than field limit是什么原因
Pandas在特定配置下(如使用Python解析引擎)也可能继承csv模块的限制,解决方法是在导入pandas之前先设置csv.field_size_limit(),或者显式指定engine='c'使用C解析引擎。
field larger than field limit (131072)会丢数据吗
不会,这个报错只是中断了读取过程,原始CSV文件不会被修改,只要调整限制后重新读取,数据完整性不受影响,但要注意,如果处理过程中程序崩溃,未写入的数据可能会丢失,建议处理前先备份。
如何检查CSV文件里是否存在超过128KB的大字段
使用上面提到的Python脚本逐行扫描,计算每个字段的字节长度即可,对于超大文件,建议分块扫描,避免一次性加载整个文件到内存。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/567412.html