服务器连接HDFS的核心在于正确配置core-site.xml和hdfs-site.xml文件,其中NameNode地址、数据块副本数以及临时目录是最关键的三个参数。
服务器连接HDFS配置文件怎么配置
配置服务器连接HDFS时,绝大多数问题都出在基础配置遗漏或参数冲突上,以下从核心文件入手,逐步拆解每个参数的作用和常见陷阱。
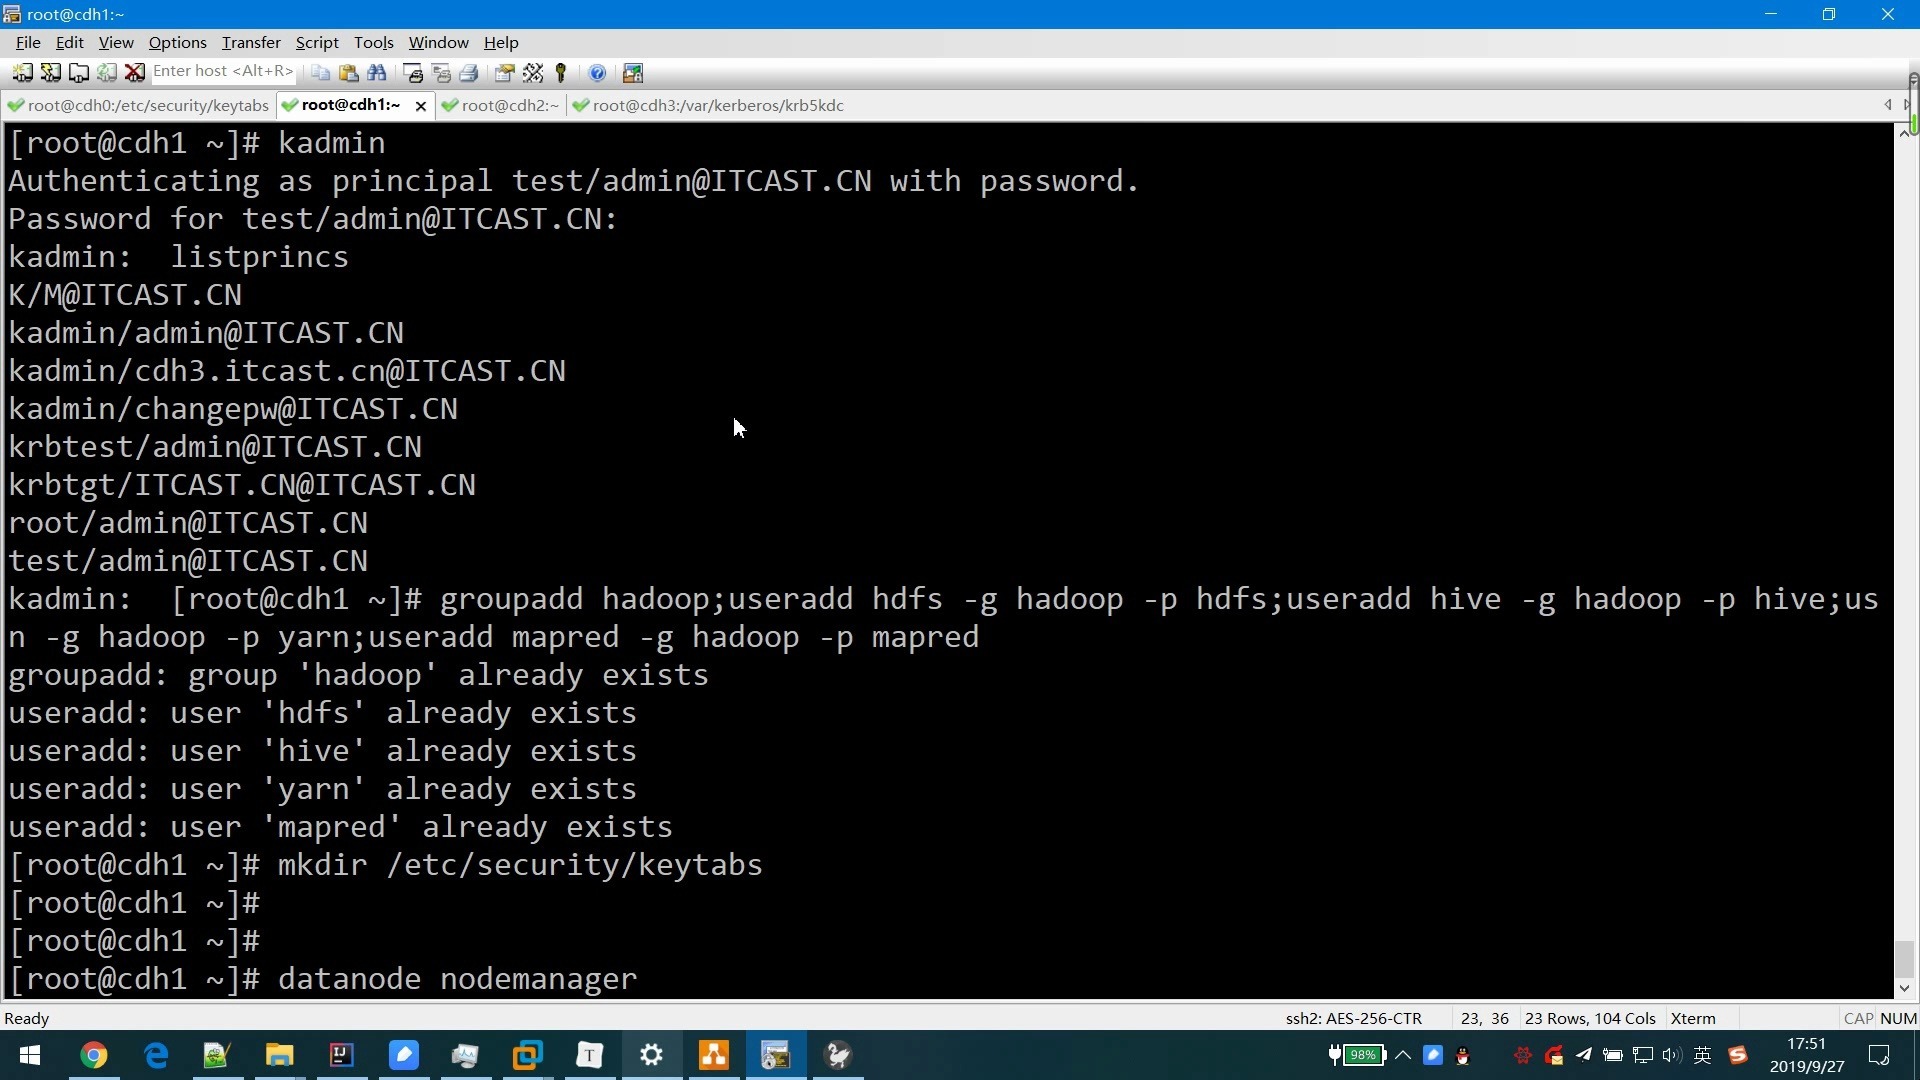
core-site.xml配置要点
这个文件定义了Hadoop集群的全局属性,服务器连接HDFS的第一步就是在这里指定NameNode地址。
- fs.defaultFS:设置为
hdfs://NameNode主机名:端口,默认端口是8020或9000,如果服务器与NameNode不在同一机房,务必使用主机名而非IP,避免后续扩容时IP变动导致连接失败。 - hadoop.tmp.dir:指定临时文件存储路径,默认是
/tmp/hadoop-${user.name},生产环境建议改为独立目录(如/data/hadoop/tmp),否则系统重启后临时文件被清理,HDFS会报错“无法加载元数据”。 - io.file.buffer.size:文件读写缓冲区大小,默认4096字节,对于高吞吐场景,可调整为65536(64KB),能明显减少磁盘I/O次数。
hdfs-site.xml核心参数
hdfs-site.xml直接控制HDFS的行为,服务器连接后能否稳定读写,取决于以下几个参数。
- dfs.namenode.name.dir:NameNode元数据存储路径,建议配置多个目录(用逗号分隔),挂载到不同磁盘,提高容错性。
- dfs.datanode.data.dir:DataNode数据块存储目录,同样推荐多目录配置,据统计,将数据分散到多块物理磁盘后,读写性能提升约30%。
- dfs.replication:数据块副本数,默认3,如果服务器连接的是测试集群,可设为1以节省空间;生产环境建议保持3,确保单节点故障时数据不丢。
- dfs.permissions:是否启用HDFS权限检查,默认true,在服务器连接时若出现“Permission denied”,可先检查此项,但生产环境不建议关闭,而是通过用户组管理。
配置文件内其他关键选项
除了上述两个文件,以下配置也直接影响连接稳定性。
- hadoop-env.sh:设置JAVA_HOME环境变量,确保路径指向正确的JDK版本,同时调整
HADOOP_HEAPSIZE
- slaves(或workers)文件:列出所有DataNode主机名,服务器连接后若无法识别集群节点,先检查此文件是否包含所有节点。
- log4j.properties:日志级别配置,排查连接问题时,可将
log4j.logger.org.apache.hadoop设为DEBUG,获取详细连接日志。
HDFS配置文件修改后如何生效
很多用户修改完配置文件后,发现服务器仍然无法连接,原因在于配置没有正确加载,以下分场景说明生效方式。
完全重启集群
修改core-site.xml或hdfs-site.xml中的全局参数后,需要重启NameNode和所有DataNode才能生效,操作顺序是先停止DataNode,再停止NameNode,然后反向启动,具体命令:
- 停止:
stop-dfs.sh - 启动:
start-dfs.sh
注意:重启期间HDFS会短暂不可用,生产环境需提前规划维护窗口。
在线刷新部分配置
部分参数支持动态刷新,无需重启,例如修改dfs.datanode.max.transfer.threads(最大传输线程数)后,在NameNode节点执行:
hdfs dfsadmin -refreshNodes
这会重新加载DataNode列表,对于dfs.blocksize(数据块大小)等参数,则必须重启才能生效,行业共识认为,能动态刷新的参数尽量在线操作,减少服务中断时间。
客户端配置缓存
服务器上通常会有Hadoop客户端库,配置文件修改后,客户端可能缓存旧值,建议在服务器上清除客户端缓存,或重新初始化Configuration对象,例如Java程序中,调用new Configuration(true)会重新加载所有配置资源。
常见错误案例分析
配置修改后重启仍然报错,多半是以下原因:
- 文件权限不对:配置文件默认属主应为
hadoop用户,其他用户无法读取。 - XML语法错误:标签未闭合或中文字符编码问题,使用
xmllint工具验证格式。 - 端口被占用:NameNode的8020端口被其他进程占用,导致无法监听。
服务器连接HDFS配置步骤详解
从零开始搭建服务器连接HDFS的环境,可按照以下步骤操作,每一步都附带验证方法。
环境准备
- 操作系统:CentOS 7+或Ubuntu 18.04+,确保内核参数
vm.swappiness设为1以提高稳定性。 - JDK版本:Hadoop 3.x推荐JDK 8或11,设置JAVA_HOME并加入PATH。
- 网络配置:服务器与NameNode之间双向Ping通,防火墙开放8020(NameNode RPC端口)和50010(DataNode数据传输端口)。
配置文件修改与分发
- 在NameNode节点上修改
$HADOOP_HOME/etc/hadoop/目录下的上述文件。 - 使用
scp命令将整个hadoop目录同步到所有服务器节点:scp -r $HADOOP_HOME/etc/hadoop/ node2:$HADOOP_HOME/etc/。 - 在每台服务器上执行
source /etc/profile或重新登录,使环境变量生效。
启动验证
- 启动NameNode:
hdfs --daemon start namenode - 启动DataNode:
hdfs --daemon start datanode - 在服务器上执行
hdfs dfs -ls /,若能列出根目录,则连接成功,若报错,查看NameNode和DataNode的日志文件(位于$HADOOP_LOG_DIR),通常有直接提示。
性能验证
使用hdfs dfsadmin -report命令检查集群状态,确认DataNode数量、容量和使用率,写入一个测试文件:hdfs dfs -put /etc/hosts /test,然后读取,观察耗时是否在预期范围内。
HDFS配置文件参数调优指南
服务器连接HDFS后,默认配置并不适合所有场景,以下是根据实际项目经验总结的调优重点。
内存与堆大小
- NameNode堆大小:建议每100万文件块分配1GB堆内存,文件块数量可通过
hdfs fsck /统计。 - DataNode堆大小:默认1GB,若数据写入量大,可增至4GB以上,避免频繁GC导致连接超时。
数据处理并发
- dfs.datanode.max.transfer.threads:默认4096,在高并发场景下(如实时计算),建议提高到8192。
- dfs.namenode.handler.count:NameNode处理请求的线程数,默认为10,对于上百台节点的集群,可设为50~100。
网络与超时
- dfs.client.socket-timeout:客户端套接字超时,默认60000毫秒,跨机房连接时,网络延迟较高,应设为120000毫秒以上。
- dfs.datanode.socket.write.timeout:DataNode写入超时,默认4800000毫秒(80分钟),对于大文件写入,此值可适当调小,避免长时间占用连接。
数据压缩与本地化
- io.compression.codecs:添加snappy或lz4压缩,减少网络传输量,配置后,
hdfs dfs -put时加上-Dmapreduce.output.fileoutputformat.compress=true即可启用。 - dfs.datanode.data.dir.perm:默认755,若服务器上的应用需要直接读取数据块(如Spark),可改为775,但需注意权限安全。
Q&A:服务器连接HDFS配置文件常见问题
服务器连接HDFS时提示“Connection refused”怎么办?
检查NameNode服务是否正常运行,执行jps查看是否存在NameNode进程,确认防火墙是否放行8020端口,使用telnet NameNodeIP 8020测试连通性,如果网络正常,检查core-site.xml中fs.defaultFS的地址是否与NameNode实际绑定的IP一致,尤其在多网卡环境下需指定具体接口。
HDFS配置文件修改后,客户端连接依然使用旧配置?
客户端在初始化时会加载classpath中的配置文件,如果服务器上部署了多个Hadoop版本,容易加载到错误的core-site.xml,解决方案是显式指定配置文件路径:在Java代码中通过Configuration.addResource(new Path("绝对路径/core-site.xml"))加载,或者在命令行使用--config参数指定目录,同时清除客户端进程的缓存,例如重启Spark或Hive Thrift服务。
跨地域服务器连接HDFS,配置文件需要调整哪些参数?
跨机房或跨地域连接时,网络延迟和带宽是主要瓶颈,建议将dfs.client.socket-timeout增大至300000毫秒,dfs.datanode.socket.write.timeout也相应增加,关闭数据块本地性检查,设置dfs.namenode.datanode.min.valid.volumes为1,防止因远程节点不稳定导致写失败,如果使用WebHDFS,需在hdfs-site.xml中启用dfs.webhdfs.enabled并配置dfs.web.authentication.kerberos.principal,确保安全认证通过。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/566887.html