MapReduce统计样例代码的核心在于利用Reducer的Iterable参数遍历所有值,实现分布式归并统计,这是Hadoop入门最经典的编程模式。
MapReduce统计样例代码怎么写?Iterable版完整实现
编写一个MapReduce统计程序,通常需要三个步骤:定义Mapper、定义Reducer、配置Driver,其中Reducer的Iterable参数是汇总所有中间结果的关键,理解它的用法是写出正确代码的前提。
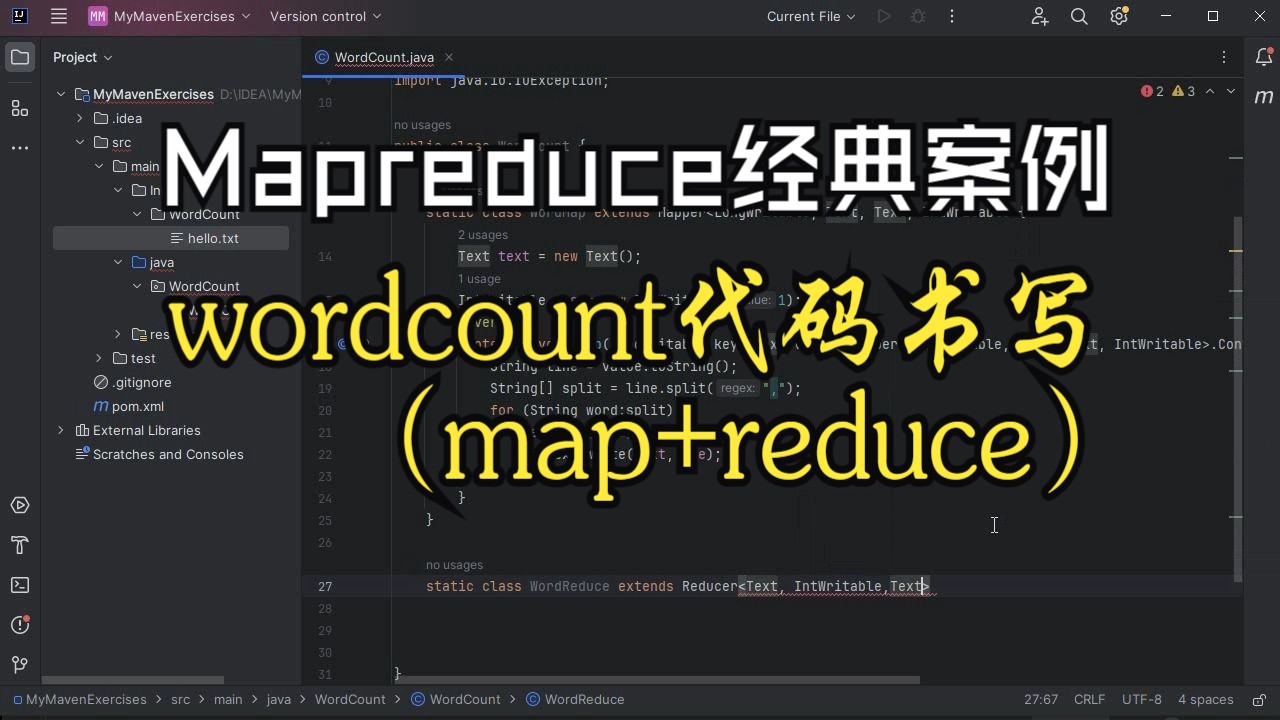
Mapper:将输入数据转为键值对
- 继承Mapper类,实现map方法
- 根据业务逻辑将输入记录拆分为<key, value>,例如词频统计中输出<单词, 1>
- 传递给Reducer的key必须实现WritableComparable,value必须实现Writable
Reducer:通过Iterable遍历所有值
- 继承Reducer类,实现reduce方法
- 方法签名中values参数类型为Iterable
,代表该key对应的所有value集合 - Iterable只能被遍历一次,因为底层是迭代器模式,第二次遍历会得到空结果
- 如果需要多次访问,应在第一次遍历时将所有值复制到List中
Driver:配置作业并运行
- 设置Mapper和Reducer类,指定输入输出类型
- 设置输入路径和输出路径,输出路径必须不存在
- 调用Job.waitForCompletion(true)提交作业
注意事项:Iterable的消费陷阱
在实际开发中,一个常见陷阱是误以为Iterable可以多次遍历,例如在Reducer中先遍历一遍统计总数,再遍历一遍计算平均值,第二次遍历时会发现values为空,正确的做法是在第一次遍历时同时计算总数并保存所有值,或使用List复制。
MapReduce与Spark对比:统计场景谁更优?
很多开发者会在学习MapReduce后转向Spark,但两者在统计场景下各有优劣,下表整理了关键差异:
| 对比维度 | MapReduce | Spark |
|---|---|---|
| 计算模型 | 两阶段(Map + Reduce) | DAG图,支持多种算子 |
| 中间数据存储 | 写入磁盘,IO开销大 | 优先内存,支持缓存 |
| 迭代计算 | 需要多次写盘,效率低 | 内存迭代,性能优异 |
| 易用性 | 代码量较大,概念直观 | 算子丰富,抽象层次高 |
| 学习成本 | 较低,容易理解分布式原理 | 较高,需理解RDD/DataFrame |
| 适用场景 | 离线批量处理,对稳定性要求高 | 迭代计算、交互式查询、实时流 |
从行业共识来看,MapReduce在稳定性和兼容性方面更成熟,而Spark在内存计算上优势明显,如果你的统计任务是一次性离线处理,且团队已在Hadoop生态中,MapReduce完全胜任;如果需要频繁迭代或实时分析,Spark更合适。
MapReduce统计场景有哪些?实际案例解析
MapReduce统计代码在多个真实业务场景中被广泛使用,以下列举三个典型示例。
日志错误统计
- 输入:服务器日志文件,每条记录包含等级(INFO、WARN、ERROR)
- 目标:统计各等级日志数量
- Mapper:输出<等级, 1>,Reducer:遍历Iterable求和
- 结果:一行一条错误级别的总量
独立IP计数
- 输入:Web访问日志,每行包含访问IP
- 目标:统计有多少个不同的IP访问(去重计数)
- 方法:Mapper输出<IP, 空值>,Reducer遍历Iterable只输出一次,或使用Combiner提前去重
- 由于Iterable只能遍历一次,但这里每个key只出现一次,所以直接输出即可
用户行为汇总
- 场景:电商平台统计用户当日购买金额
- 输入:订单表,包含用户ID和金额
- Mapper:输出<用户ID, 金额>
- Reducer:遍历Iterable累加,输出总金额
- 优化:使用Combiner在Map端预聚合,减少网络传输量
初学者常见问题:MapReduce统计代码调试与优化
以下几个问题经常困扰刚接触MapReduce的开发者。
问题:Iterable无法重复使用如何解决?
在Reducer中,Iterable values对应的迭代器只能遍历一次,如果需要多次遍历,例如先计算总和再计算平均值,必须在第一次遍历时将值保存到ArrayList或自定义容器中,示例:在循环中同时维护总和和值的列表,或直接使用List来存储所有值。
问题:统计任务速度慢,如何优化?
- 添加Combiner:在Map端执行同Reduce一样的汇总逻辑,减少传输到Reduce的数据量
- 调整Partitioner:使数据分布均匀,避免数据倾斜导致某个Reducer过载
- 使用压缩:对中间结果使用Snappy压缩,减少磁盘IO
- 合理设置Map和Reduce任务数量:避免过多小任务或过少大任务
问题:MapReduce统计代码和Spark相比,哪个学习成本更低?
MapReduce概念更基础,代码结构固定,适合初学者理解分布式计算的核心思想,Spark虽然API更简洁,但需要掌握RDD、DataFrame、算子调度等概念,入门门槛相对较高。多数开发者建议先从MapReduce入手,再过渡到Spark。
MapReduce统计样例代码常见问题
问题1:MapReduce统计代码中,Mapper和Reducer的输入输出类型必须一致吗?
不必须,Mapper输出类型与Reducer输入类型必须一致,但Reducer输出类型可以不同,例如Mapper输出<Text, IntWritable>,Reducer输入<Text, Iterable
问题2:Iterable变量在Reducer中只能遍历一次,这是设计缺陷吗?
这是设计选择,而非缺陷,Iterable基于迭代器模式,目的是减少内存占用,避免将所有值一次性加载到内存,如果数据量极大,复制到List可能导致内存溢出,因此需要根据业务权衡:若数据量小,可复制;若数据量大,应设计只需一次遍历的算法。
问题3:MapReduce统计场景下,Combiner和Reducer的代码可以完全一样吗?
在多数情况下可以,但必须保证Combiner的输入输出类型与Mapper输出类型一致,且Combiner的处理逻辑满足结合律和交换律,例如求和、计数、最大值都可以,但求平均值等场景不能直接复用,因为Combiner只汇总部分数据,无法得到全局平均值。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/564886.html