济南GPU算力租用报价按训练时长核算的核心逻辑,是把“单价”乘上“实际占用时长”,再叠加内存、存储、带宽等附加项,最终得出一个按小时或按秒计费的账单。 这张账单里最容易被忽视的,是“时长”的起止点怎么算是镜像拉取完成开始计费,还是进程启动才算;是任务结束就停表,还是要等资源释放完毕,搞清楚这条时间线,比单纯比价更重要。
济南GPU算力租用价格到底怎么算出来的
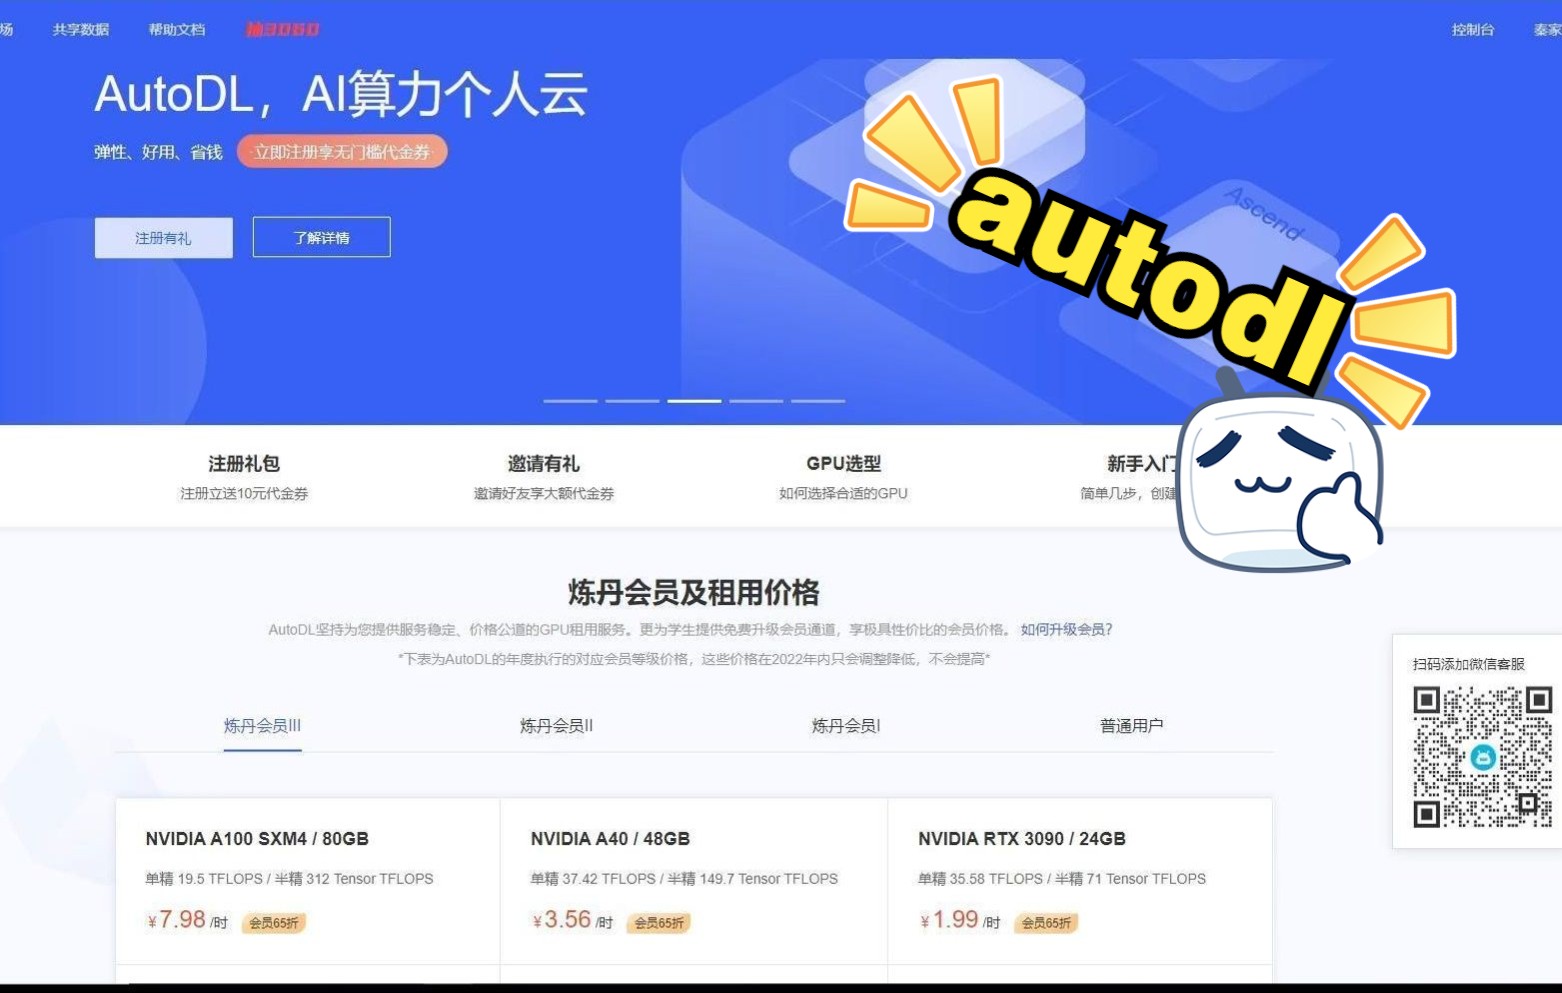
济南的算力市场这几年发展很快,除了浪潮云、联通云这些本地大玩家,还有AutoDL、恒源云、揽睿星舟等全国性平台在济南节点部署资源,各家报价体系虽然看起来五花八门,但拆开来看,底层逻辑是一致的:按训练时长收费 = GPU单价 × 运行时长 + 附加资源费。
具体到济南市场,影响报价的因素有几个维度:
- GPU型号:RTX 4090、A100 80G、H800、L20S、国产算力(昇腾910B、寒武纪)价格差异很大,同一平台内,4090单卡时租大致在2元到4元区间,A100在8元到15元区间,H800在15元到25元区间。
- 计费粒度:绝大多数平台按秒计费,按小时出账单,但有些平台设置了最短计费时长,比如不足1小时按1小时算,这对调试阶段的小任务影响很大。
- 附加资源费:内存、系统盘、数据盘都是单独计费的,以某平台为例,4090机型配30GB内存和50GB系统盘,基础时租3.5元,如果内存加到60GB,时租涨到4.2元。
- 带宽费用:济南本地节点之间内网传输通常免费,但公网下行流量按8元/GB左右收取,模型下载、镜像拉取都要走这笔开销。
济南GPU算力租用报价单里的“训练时长”从哪一秒开始算
这是最容易产生认知偏差的地方,行业共识认为,计费起点是实例创建成功的那一刻,而不是训练脚本跑起来的那一刻,你从镜像市场拉起一个PyTorch容器,到SSH能连上,中间可能花了40秒,这40秒已经计入账单了。
更关键的是状态切换的计费逻辑:
- 运行中:按所选配置的时租单价全额计费。
- 关机中:部分平台支持关机不计费(只收存储费),但有些平台的“关机”只是停止计费GPU算力,CPU和内存仍按一定折扣计费。
- 排队中:高峰期创建实例可能需要排队,排队期间不计费,但排队时长不纳入任何保障。
实操中,建议在训练脚本里加入自动关机逻辑,比如用python train.py配合--shutdown-on-failure参数,或者在平台控制台设置定时关机策略,避免训练结束后空跑两三个小时,这两个小时,在账单上就是纯浪费。
济南大模型训练租GPU怎么收费:一个7B模型的实际核算案例
拿一个具体场景来算账,假设你要在济南节点微调一个7B参数的LLM,用DeepSpeed ZeRO-3做分布式训练,需要4张4090。
- 硬件配置:4×RTX 4090,每张配24GB显存,主机内存64GB,系统盘100GB,数据盘200GB。
- 平台时租:4090单卡时租3.8元,内存按0.1元/GB/小时计,系统盘0.1元/GB/小时(按实际使用量计费),数据盘0.08元/GB/小时。
- 训练时长:跑3个epoch,数据量50万条,batch size调大后总耗时约11小时40分钟。
账单拆解如下:
| 项目 | 计价方式 | 金额 |
|---|---|---|
| GPU算力 | 4卡 × 3.8元 × 11.67小时 | 38元 |
| 内存 | 64GB × 0.1元 × 11.67小时 | 69元 |
| 系统盘 | 100GB × 0.1元 × 11.67小时 | 70元 |
| 数据盘 | 200GB × 0.08元 × 11.67小时 | 72元 |
| 合计 | 约555.49元 |
注意几点:系统盘按容量计费,即便实际只用了20GB,也按100GB收,数据盘同理,如果你用平台自带的公开数据集,挂载在只读目录下,这部分空间通常不收费,镜像拉取和容器启动阶段(约3分半钟)也计入GPU时租,体现在账单里就是0.22元左右。
济南GPU算力租用按小时计费与包月计费怎么选
按训练时长核算还有一个衍生问题:同样一个任务,按小时租和包月租,成本差多少? 济南的算力平台上,包月价格通常是时租价格的30到50倍,以4090为例,时租3.8元,包月价约1600元,相当于每天跑不超过14小时才划算。
分场景看:
- 周末比赛、课程作业、论文复现:这类任务总时长在10小时以内,按小时租完全够用,平台一般有“无卡模式”或“低配模式”供调试代码,调试时用CPU顶一下,正式跑再用GPU,能省不少钱。
- 持续一周以上的微调任务:如果每天都要跑满8小时以上,包月更划算,但要注意,包月机的续费是按整月走的,任务提前结束,剩余时间不退。
- 断点续训场景:这类任务时长不固定,建议选择按小时计费,配合自动快照功能,每次断点保存模型权重,如果实例被回收,重新创建后从快照恢复,账单只算新一轮的时长。
按秒计费与按小时计费在济南GPU算力租用平台上的实际差异
大多数平台宣传“按秒计费”,但出账是按小时四舍五入的,比如你跑了1小时01秒,有些平台收2小时的钱,有些平台收1小时整,这个细节在平台官网的计费说明里通常写得很隐蔽,建议下单前在帮助中心搜“计费精度”或“账单周期”。
另一重差异体现在抢占式实例上,济南部分平台提供竞价实例,价格是常规价的20%到40%,但实例可能随时被中断,对训练任务来说,除非你做好了完整的断点续训方案,否则不建议用竞价实例跑长任务,短时间的数据预处理、评测推理倒是可以试试。
济南GPU算力租用价格查询时容易踩的坑
查价格的时候,很多人的习惯是直接看官网的“产品定价”页,但实际成交价和挂牌价之间,往往隔着几层折扣。
- 新用户券:各平台首充往往有5折到7折的优惠券,到账后按原价扣费,优惠券抵扣差额,如果你有多个平台账号,可以先用优惠券跑短任务做测试,再决定长任务放在哪家。
- 充值返送:部分平台充1000送150,这相当于变相降价约13%,但返送金额通常有有效期,建议规划好后续用量再充值。
- 闲时折扣:济南本地某些平台推出夜间(凌晨0点到早上8点)GPU时租7折,适合不赶时间的批量推理任务。
- 私有化部署报价:如果训练量特别大,超过500卡时/月,找平台销售谈私有化部署或者专属集群,价格能压到挂牌价的50%到60%,但起租周期长,通常要签3个月以上合同。
济南GPU算力租用怎么选配置既省钱又不影响训练速度
配置选型直接决定单位训练时长的成本,业内专家指出,很多用户习惯性地把显存选大一号,但实际利用率很低,判断标准很简单:看训练时的显存占用峰值,在训练脚本里加一段显存监控代码,跑一个step打印一次torch.cuda.max_memory_allocated(),连续观察几十个step,取最大值,如果峰值不到显存上限的80%,说明配置有压缩空间。
- 7B模型全参数微调,batch size为1时,显存需求约16GB到20GB,用4090的24GB版刚好。
- 如果改用LoRA或QLoRA,显存需求能压到8GB以内,此时用RTX 4080甚至4070 Ti Super就能跑,时租成本直接降一个档次。
- 多卡训练时,优先选同型号同规格的GPU,避免因显存不均导致并行效率下降,反而拉长总训练时长。
算清楚济南GPU算力租用按训练时长核算这笔账
怎么把训练时长压缩到最短
训练时长是核算公式里的核心变量,同样的模型,不同人跑出来的时长能差出30%到50%,实操层面能见效的做法有这些:
- 用混合精度训练:PyTorch的
torch.cuda.amp能把FP32的张量自动转成FP16或BF16,显存占用减半,训练速度提升20%到40%。 - 加大batch size并同步调整学习率:在显存允许的前提下,batch size翻倍,学习率也相应调整,单位时间处理的数据量更大。
- 打开
torch.compile:对GPU利用率提升明显,尤其是A100/H800这类新架构,编译后能压掉不少kernel launch开销。 - 数据加载不要用默认设置:
num_workers设成4到8,pin_memory=True,prefetch_factor适当调大,避免GPU空转等数据。
训练中断后的账单怎么算
训练中断是时长核算里最让人头疼的场景,平台侧的规则一般是:
- 手动停止:账单截至停止时刻,已用时长正常计费。
-
节点故障
:平台自动迁移实例,原实例的时长通常减免,新实例从迁移完成后重新计费,但迁移过程可能需要几分钟到十几分钟,这段时间不计费。 - 余额不足导致停机:按欠费时刻截断计费,补缴后实例恢复,但需要重新拉取镜像和数据,这部分时间另算。
建议在训练脚本里加上定时保存checkpoint的逻辑,比如每500步保存一次到数据盘,这样即使实例被回收,重新创建后也能从最近的checkpoint继续跑,损失的时长最多是500步的耗时。
长短期任务混合怎么优化整体成本
如果你的需求是“日常小任务不断,隔三差五有大任务”,可以考虑多平台组合策略,小任务放在AutoDL这类性价比平台,按小时租;大任务放到浪潮云这类本地企业级平台,走包月或专属集群,济南本地还有不少小型算力服务商,通过二手市场转售的算力资源时租价格更低,但稳定性需要自己测试,建议先跑一个多小时的压力测试再决定是否长期使用。
济南GPU算力租用多少钱一小时的真实水平
综合来看,济南市场上主流GPU的时租价格大致落在这些区间:
- RTX 4090:3到4元/小时,适合7B以下模型微调、LoRA训练、SD出图。
- A100 80G:10到15元/小时,适合13B到70B模型的全参数微调。
- H800:18到25元/小时,适合百亿级模型预训练或大规模RLHF。
- L20S:6到8元/小时,性价比高,适合推理和中等规模训练。
- 昇腾910B:8到12元/小时,国产算力,生态逐步完善,部分场景有政策补贴。
这些价格是2026年下半年到2026年初的常见水平,实际成交价会因平台活动、充值金额、租用时长浮动,但万变不离其宗:把训练时长算准,把附加资源压缩到刚需,账单自然就降下来了。
常见问题
济南GPU算力租用时,训练时长不足1小时怎么计费?
多数平台按秒计费,但出账周期按小时结算,不足1小时的部分,按实际秒数折算费用,例如跑了35分钟,账单按2100秒折算,而不是按1小时收,但部分平台设置了最低计费时长(通常为1小时),下单前查看计费规则确认即可。
济南GPU算力租用平台上的“关机不计费”对训练任务有效吗?
有效,但前提是训练任务已经结束,实例处于关机状态,如果训练脚本还在运行,强制关机可能导致模型权重丢失,建议在脚本中设置训练完成后的自动关机指令,例如在Python代码末尾调用os.system("shutdown -h now"),这样能确保训练结束后立即停止计费。
济南GPU算力租用包月套餐和按小时计费哪个更适合长期训练?
包月套餐的定价通常在单卡时租价格的30到50倍区间,如果每天实际训练时长超过8小时且持续多天,包月更划算;如果每天训练不到4小时,按小时计费更灵活,手头有明确的训练计划时,先估算总时长再对比两种模式的费用,不会出错。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/564365.html