查询Hive表数据,核心是掌握HiveQL的SELECT语法体系,配合对执行引擎和存储结构的理解,才能在不同场景下高效取数。无论你是刚接触数据仓库的新人,还是已经写过几百条SQL的取数老手,Hive查询的进阶之路都绕不开语法细节、执行原理和排错技巧这三座大山,这篇文章直接围绕“怎么写”“怎么快”“怎么排查”展开,全程干货,不绕弯子。
查询Hive表数据的基本姿势有哪些
很多人第一次接触Hive,会把它当成一个普通的数据库来用,实际上Hive的定位是数据仓库工具,它本身不存数据,只是把SQL翻译成分布式计算任务,理解这一点,你才能明白为什么同样的SQL,在不同引擎上跑出来的速度天差地别。
三种主流查询入口的适用场景
- Hive CLI:老牌命令行工具,适合服务器上快速验证SQL,但界面简陋,不支持自动补全,如果你只是临时看几条数据,用它最直接。
- Beeline:基于HiveServer2的轻量客户端,支持JDBC连接,生产环境首选,它解决了CLI的并发问题,也支持变量传递,适合写脚本定时跑数。
- Hue/商业BI工具:图形化界面,适合不熟悉命令行的业务同学,但要注意,这类工具底层也是走HiveServer2,SQL写得不规范一样会慢。
从连接数据库到执行第一条SQL
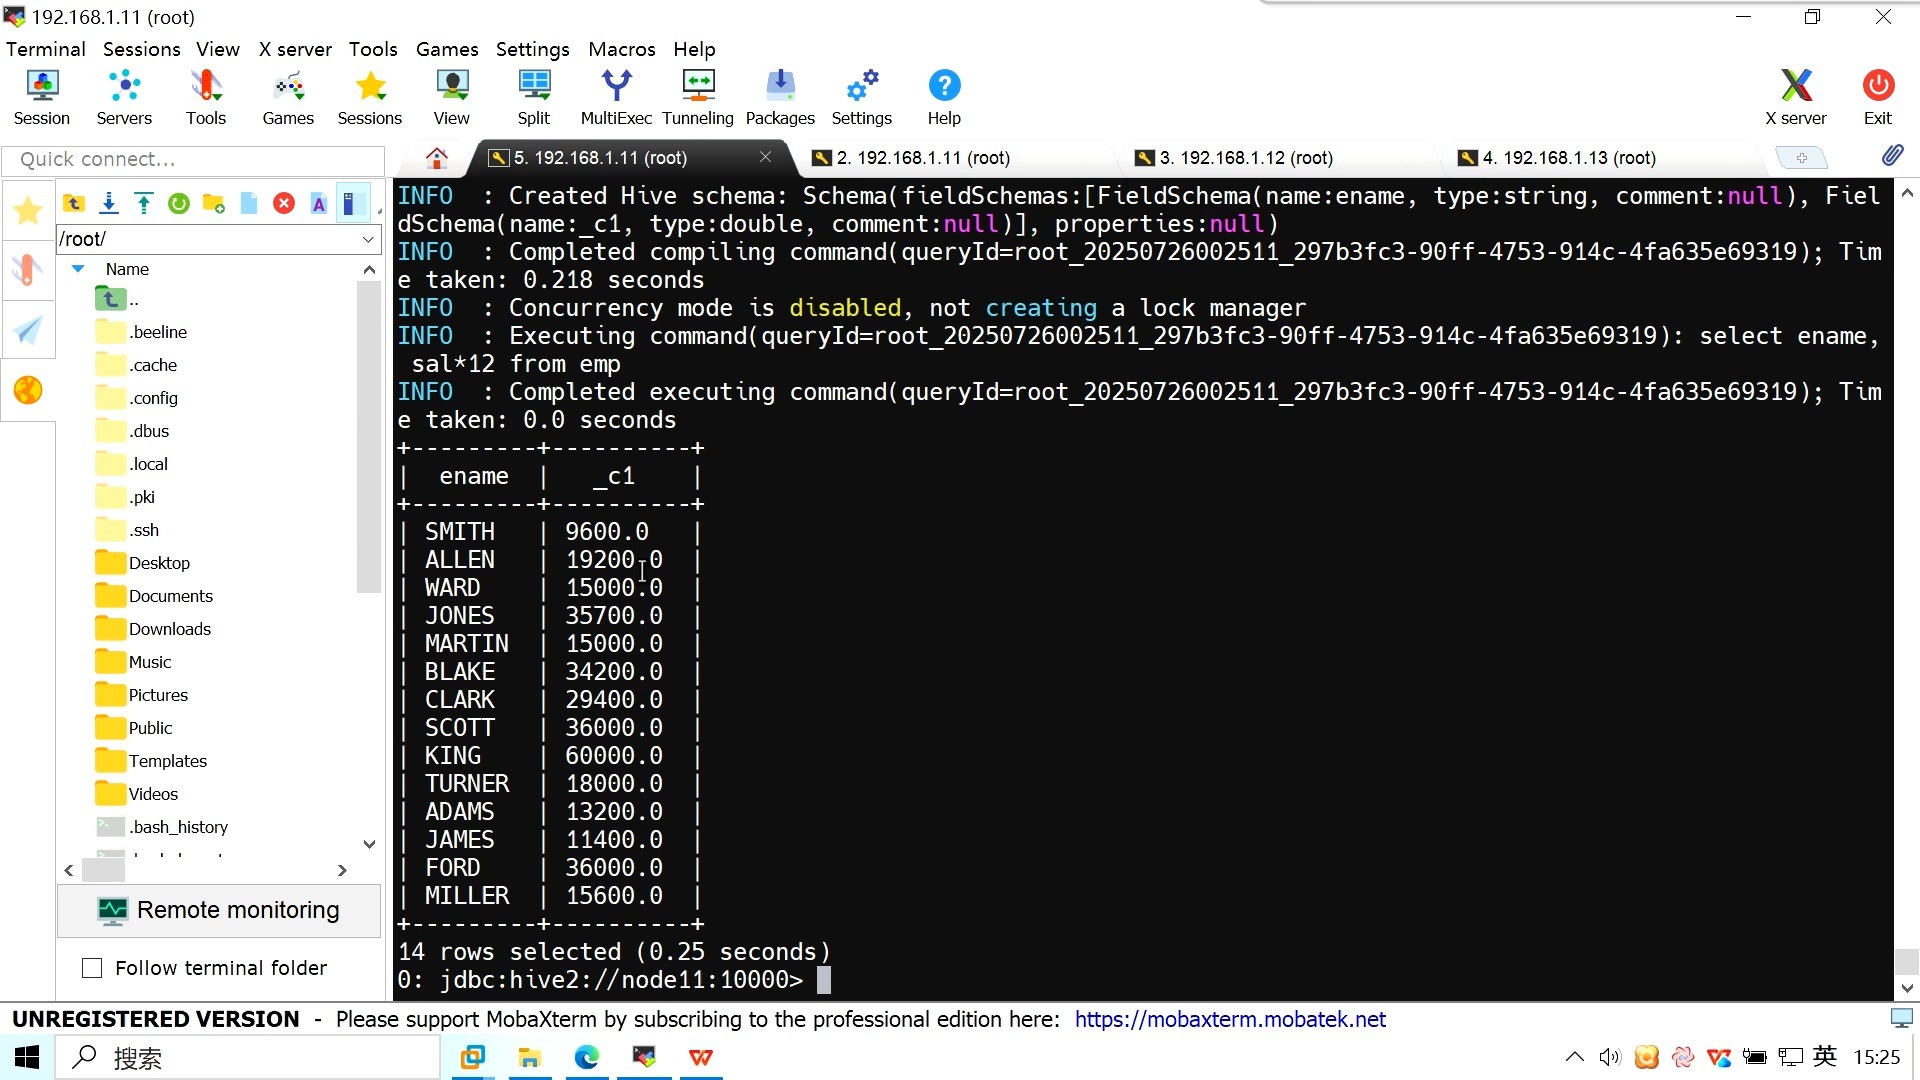
假设你已经在服务器上配好了环境,用Beeline查数的手动流程是这样的:
- 连接HiveServer2,指明库名和队列优先级。
- 查看当前库下有哪些表。
- 先跑一个
LIMIT 5确认数据没问题,再放开全量查询。养成先用小数据量试探的习惯,能帮你省掉大量因字段名写错导致的资源浪费。
hive查询表数据常用操作有哪些
基础SELECT语句这里不啰嗦,重点说几个实际工作中高频但容易踩坑的进阶操作。
WHERE过滤的隐藏陷阱
- 分区裁剪:如果表是分区表,WHERE条件里务必带上分区字段,全表扫描在数据量大时不是慢一点的问题,而是根本跑不完的问题。
- 字符串比较:用比较字符串时,Hive不会自动去空格,你查
WHERE name = '张三'
'张三 ',写SQL前先确认是否存在不可见字符,用trim()函数处理一下更稳妥。
JOIN关联查询的注意事项
- 小表放左边:Hive的MapJoin优化机制会把小表加载进内存,旧版本中需要你手动写
/+ MAPJOIN(b) /,新版本(Hive 0.11+)会自动优化,但当小表超过内存阈值时,任务会直接报错,此时需要调整参数或改用大表驱动。 - 避免笛卡尔积:ON条件漏写一个关联键,结果集就是几何级增长,排查数据量异常的第一件事,就是检查JOIN条件是否完整。
聚合函数与分组排序
GROUP BY后面跟的字段,必须是SELECT列表中出现的非聚合字段,这是SQL的硬性规定,Hive也不例外。- 想取每个分组的前N条记录,用
ROW_NUMBER() OVER(PARTITION BY ... ORDER BY ...)窗口函数,比子查询+JOIN的效率高得多。 DISTINCT和GROUP BY在去重场景下功能等价,但数据倾斜严重时,GROUP BY配合skewed参数处理会更从容。
子查询的写法差异
Hive对子查询的支持是逐步完善的,早期版本只支持嵌套在FROM子句中的子查询,写在WHERE里的子查询会报错,现在虽然支持了,但关联子查询的执行效率依然远低于JOIN,能改写就改写。
hive查询很慢怎么优化
慢查询是Hive使用中最头痛的问题,也是面试和实际工作中被问得最多的场景,优化思路基本围绕“让数据扫描得更少”和“让计算并行得更充分”两个方向。
从数据存储层面优化
- 列式存储优先:ORC和Parquet格式相比老旧的TextFile,扫描效率有数量级提升,行业共识认为,ORC格式加压缩是Hive查询优化的基础配置。
- 合理设置分区粒度:按天分区是常见做法,但如果你经常查小时级数据,按小时分区会更快,分区粒度越细,查询时能跳过的不相关数据就越多。
- 利用分桶表做抽样:当数据量极大且需要随机采样时,分桶表配合
TABLESAMPLE可以秒级返回结果,不需要全表扫描。
从SQL执行层面优化
- 只查需要的列,不要随手
SELECT,列数少意味着IO量小,这在分布式环境下效果被放大。 - 用
EXPLAIN看执行计划,是定位性能瓶颈最直接的手段,某条SQL跑得慢,先看是不是触发了全表扫描,再看是不是产生了数据倾斜。 - 严格过滤后再JOIN:先子查询把表缩到最小,再去做关联操作,比大表直接JOIN再过滤快得多。
调整执行引擎和参数
- 如果你的集群支持Spark或Tez引擎,在Beeline里设置
set hive.execution.engine=spark;,复杂查询的响应速度通常能提升数倍。多数情况下,SQL代码不用改,换引擎就有效果。 - 小文件过多会导致任务启动开销巨大,通过
set hive.merge.smallfiles.avgsize=128000000;合并小文件,可以显著减少Map数量,提升查询稳定性。
查询结果异常和报错怎么排查
写SQL不报错是不可能的,关键是报错之后能不能快速定位问题。
结果总是NULL
- 先确认关联字段的两边数据类型是否一致,INT和STRING隐式转换在某些版本中会失效,导致关联不上,结果全是NULL。
LEFT JOIN后右表字段为NULL是正常现象,但如果右表主键本身就存在NULL值,那就要权衡是不是该用INNER JOIN。
内存溢出或容器被杀
- 任务报
Container killed by the ApplicationMaster,八成是单个Reducer处理的数据量过大,尝试增加Reducer数量,或者用DISTRIBUTE BY随机打散数据,避免某个Reducer独吞大块数据。 - 查询结果集太大时,Beeline客户端会先把数据拉到本地再输出,这时可能卡死,用
INSERT OVERWRITE LOCAL DIRECTORY把结果写到服务器文件里,再分块查看。
查询时乱码怎么办
- 表字段注释中文乱码,通常是Hive元数据库的字符集设置问题,在MySQL元数据库中执行
ALTER TABLE COLUMNS MODIFY COLUMN COMMENT VARCHAR(256) CHARACTER SET utf8mb4;可以修复,但需要运维权限。 - 查询结果本身乱码,检查终端编码是否为UTF-8,以及Beeline启动参数里是否添加了
--default-character-set=utf8
Hive查询和其他工具的对比
经常有人问Hive能不能替代关系型数据库,或者有了Hive是不是就不用学Spark SQL了,这里集中对比一下。
Hive和MySQL/PostgreSQL的差异
- 都是一个SQL标准,但Hive底层是分布式计算,MySQL是单机存储引擎。Hive的查询延迟通常在秒级到分钟级,不适合在线事务处理。
- Hive不支持事务、不支持行级更新,你要修改一条数据,只能先定位再覆盖写,和MySQL的
UPDATE体验完全不同。
Hive和Spark SQL的取舍
- 都是构建在Hadoop生态上,但Spark SQL把中间结果缓存在内存里,迭代计算比Hive快得多。数据量中等且需要交互式探查时,Spark SQL更合适。
- Hive的优势在于元数据管理成熟,表结构变更、权限控制、UDF扩展都更完善,银行数据仓库和传统企业数仓,多数还是以Hive为底座,再用Spark SQL做加速查询。
常见问题解答
Hive查询表数据的方式有哪些?
主要有三种:Hive CLI适合快速验证,Beeline适合生产环境脚本和自动调度,Hue或商业BI工具适合非技术人员,实际工作中用Beeline为主,配合可视化工具做数据探查。
为什么同样的SQL在Hive里跑得比MySQL慢很多?
Hive要启动分布式计算任务,调度和通信开销远大于单机数据库,数据量在GB级别以下时,这个开销非常明显,数据量到TB级别以上,Hive的吞吐能力才会体现出来,如果只是小数据量查询,应该考虑用MySQL或Impala这类工具。
Hive查询结果集太大导致客户端卡死怎么办?
不要直接在客户端输出全量数据,改用INSERT OVERWRITE LOCAL DIRECTORY将结果写入本地文件,再用less或split命令分块查看,需要导出给下游系统时,也可以直接生成到HDFS路径,让下游任务主动拉取。
查询Hive表数据,语法只是基本功,真正的分水岭在于你是否理解数据怎么存储、任务怎么执行、瓶颈怎么定位,从今天起,试着在你写的每条SQL前加上EXPLAIN,花两分钟看执行计划,你的进步速度会比盲目刷题快得多。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/564309.html