在深圳租用GPU进行AI项目,训练和推理的配置需求有着本质区别:训练追求算力上限与显存冗余,推理侧重延迟控制与吞吐优化,选错方案不仅浪费预算,更会拖慢部署节奏。
深圳GPU租用,AI训练与推理配置区别在哪里
训练和推理对GPU资源的消耗逻辑完全不同,训练阶段要反复计算梯度、更新参数,整个过程需要极高的并行计算能力和海量显存来缓存中间激活值;推理阶段只做一次前向传播,更看重单次请求的响应速度和单位时间能处理的请求数量,如果不弄清楚这两者的区别,直接照搬配置方案,很可能出现“训练卡顿、推理空转”的尴尬局面。

显存考量的分水岭:训练要“存得下”,推理要“跑得快”
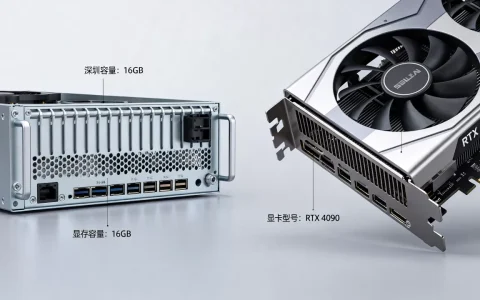
训练任务的显存需求通常由模型参数量、批次大小和数据精度共同决定,以当前主流的大语言模型为例,一个70B参数的模型用FP16精度加载,单卡显存占用就超过140GB,即使使用模型并行,每张卡也需要至少80GB显存才能跑出合理批次,而推理任务经过量化(如INT8/FP8)和算子融合后,显存占用可以压缩到训练时的十分之一以下,16GB或24GB的显存已经能覆盖相当一部分场景。
- 训练推荐显存规格:80GB以上(如A100 80GB、H100 80GB)
- 推理推荐显存规格:16GB-24GB(如T4 16GB、L4 24GB、A10 24GB)
算力需求的错位:训练要并行,推理要及时
训练依赖的是稠密算力,需要GPU在FP16或BF16精度下持续输出高吞吐,多卡并行时还要靠NVLink等高速互联来减少通信延迟,推理则更看重单次推理延迟和并发处理能力,通常使用INT8或FP8精度,利用Tensor Core的稀疏计算特性来加速,对卡间互联要求不高,PCIe带宽即可满足多数场景。
行业共识认为,训练任务中GPU的利用率通常能拉到90%以上,而推理任务由于请求到达不均匀,利用率往往只在30%-50%之间,因此推理集群更强调弹性伸缩和负载均衡,而非单卡绝对算力。
网络架构的隐性门槛
训练集群中卡间通信频率极高,梯度同步依赖NVLink或InfiniBand,带宽不足会直接导致算力浪费,推理集群则更关注前端网络的稳定性用户请求从公网到达机房,再经过负载均衡分发到推理卡,整个过程要求端到端延迟控制在几十毫秒内,深圳本地数据中心由于靠近用户聚集区,网络延迟通常低于环京和环沪机房,尤其适合实时推理场景。
深圳GPU租用价格差异:训练型与推理型实例的账单对比
价格是深圳GPU租用中最直接的决策因素,训练和推理不仅在硬件配置上分岔,在计费模式上也存在明显差异。
按小时租用:训练型价格是推理型的数倍
在深圳主流GPU租用平台,训练型实例(如A100 80GB)的按小时价格通常是推理型实例(如T4 16GB)的3-5倍,如果按包月计算,一台A100的月租金可能达到数万元,而同配置的T4仅需数千元,但训练任务往往需要连续运行数天甚至数周,推理任务则更接近波动式负载,按需弹性实例反而更划算。
- 训练场景:推荐包月或竞价实例,抢占式租用可将成本降低50%以上,但需容忍中断。
- 推理场景:推荐按小时或按调用量计费,配合自动扩缩容,避免资源闲置。
隐藏成本:显存与互联的附加费用
训练集群如果租用NVLink版本,价格会比标准PCIe版本高出不少,部分深圳机房还根据带宽按量收费,训练时频繁的数据传输会推高账单,推理实例则通常选择标准网络,附加费用更低。不要只看GPU单价,要把显存、互联、带宽打包计算总成本。
地域因素对价格的影响
深圳本地电力和带宽成本较高,GPU租用价格普遍比贵州、内蒙古等西部数据中心贵20%-30%,但胜在网络延迟低,尤其适合对实时性敏感的推理任务,如果训练任务对延迟不敏感,可以考虑跨地域混部训练数据在西部离线处理,模型再同步到深圳机房进行推理部署。
从训练到推理:深圳GPU租用配置的迁移实操
模型开发完成后,从训练环境切换到推理环境并不是简单换张卡,需要一系列适配步骤,以下是一套可复用的操作路径。
模型导出与格式转换
训练完成后,将模型权重导出为开放格式,推荐使用ONNX作为中间表示,再针对推理GPU进行优化。
- 使用torch.onnx.export导出PyTorch模型
- 使用tf2onnx导出TensorFlow模型
- 转换时固定输入尺寸,启用动态批处理
选择推理GPU并验证兼容性
根据量化精度和延迟要求选定推理实例,以T4为例,其INT8算力是FP16的2倍,绝大多数模型经过量化后精度损失可忽略。
- 在深圳机房申请一台T4实例,部署TensorRT或Triton Inference Server
- 加载优化后的模型,测试单次推理延迟和吞吐量
- 调整批量大小,在延迟和吞吐之间找到平衡点
配置弹性伸缩与监控
推理流量随时间波动,建议配置基于CPU/GPU利用率的自动扩缩容策略,同时监控每张卡的显存占用和推理队列长度,避免因并发过高导致OOM或超时。
- 设置最小实例数(保证基线流量)和最大实例数(防止预算超支)
- 启用日志采集,记录每次推理的响应时间,便于后续调优
深圳GPU租用市场现状与选择建议
深圳的GPU租用市场已经相当成熟,既有头部云厂商的中转服务,也有本地IDC厂商的自营资源,选择时需要关注几个关键点。
机房位置与网络延迟
深圳本地机房主要分布在南山、宝安和龙华,南山机房靠近科技园,网络延迟最低,适合实时推理;宝安机房拥有更大规模的电力容量,适合长时间训练任务,建议优先选择后者,因为训练任务对网络延迟不敏感,而电力冗余能保证设备稳定运行。
租用模式的灵活性
- 按小时租用:适合短期测试和弹性推理,成本可控但单价高。
- 包月租用:适合长期训练任务,能拿到不错的折扣,但需承担资源闲置风险。
- 竞价实例:适合可中断的训练任务,价格约为包月的20%-30%,但随时可能被回收。
服务商的附加能力
除了硬件本身,优秀的服务商会提供镜像管理、网络加速、故障告警等配套服务,深圳本地有不少初创团队提供“裸金属+运维托管”模式,比纯云服务更灵活,适合对硬件有特殊要求的深度用户。
深圳GPU租用配置常见疑问解答
训练和推理可以用同一块GPU轮流跑吗?
可以,但效率不高,训练任务会长时间占用显存并拉高温度,频繁切换环境会导致推理请求排队超时,如果预算有限,建议在非高峰时段用同一块GPU做低优先级训练,高峰时段切回推理,但必须做好环境隔离和资源限制。
深圳哪里租GPU最划算?
没有绝对划算的方案,取决于你的需求组合,如果主要做推理,优先选择按小时计费的T4或L4实例,利用深圳本地机房的低延迟优势;如果做训练,可以考虑跨地域混部,把训练任务放在西部机房,推理留在深圳,部分深圳本地IDC提供“训练包月送推理时长”的打包套餐,对长期项目比较友好。
怎么判断我的模型该用多少显存?
一个简单估算方法:模型参数量(十亿)乘以2(FP16下每参数占2字节),再乘以1.2(中间激活缓存系数),得到显存需求(GB),例如7B参数模型,7×2×1.2≈16.8GB,加上批次扩展,24GB显存就比较稳妥,推理时经过量化,显存需求可进一步降低至40%左右。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/560964.html