对于深圳的自动驾驶与机器人团队,最务实的GPU算力租赁方案是混合架构:核心训练任务用本地部署确保数据安全,弹性仿真和验证任务用云GPU按需扩展,这样既能控制长期成本,又能灵活应对算力波动。
自动驾驶团队算力方案对比:本地部署与云GPU怎么选
深圳自动驾驶与机器人团队在选择算力时,首先面临的是自建机房还是全部上云的决策,行业共识认为,没有绝对的最优解,只有基于业务阶段的匹配,以下从三个维度展开对比。
本地部署的适用场景:数据安全与长期效益
本地部署指在团队自有或托管机房内搭建GPU集群,对于自动驾驶这类涉及大量路测数据和传感器原始信息的团队,数据合规是红线,本地部署能确保数据不出域,满足车企和监管对数据隐私的要求,当模型训练任务稳定且持续(如每天24小时跑基线模型),本地机器在硬件折旧后边际成本更低。
但本地部署的短板也很明显:一次性投入巨大,单台A100服务器加配套存储、网络、制冷,动辄数十万,深圳机房租金和电力成本较高,团队需要预留运维人力。弹性扩展能力差,遇到突发大任务(如新场景仿真验证)只能排队或闲置,无法按需伸缩。
云GPU的弹性优势:按需付费与快速迭代
云GPU(简米云、酷番云、华为云、UCloud等)的核心价值在于秒级扩缩容,自动驾驶团队在训练新算法、做大规模仿真时,往往需要短时间内调用上百张卡,用完后立刻释放,避免资源浪费,对于早期创业团队,没有预算买卡,云GPU几乎是唯一选择。
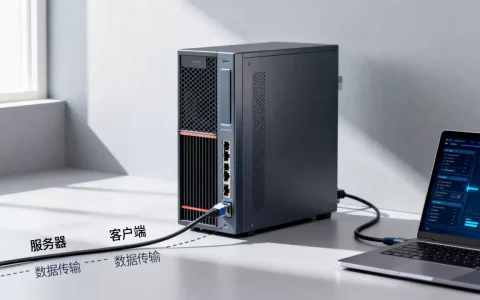
不过云GPU的长期成本不容忽视,按小时计费,A100单卡价格通常在每小时几十元,如果连续包月,费用远超同配置的本地机器,数据传输延迟和带宽开销也是深圳团队常踩的坑:训练数据从本地传到云端可能耗费数小时,每次迭代浪费大量时间。
混合架构:当前深圳团队的主流选择
多数深圳自动驾驶和机器人公司最终选择了混合架构:将核心训练集群(如用于模型主干的预训练)放在本地,保证数据闭环和低延迟;将仿真验证、小批量调参、临时测试等弹性任务推送到云GPU,同时利用
竞价实例(抢占式实例)将成本再降一半以上,这种方案既能满足数据安全要求,又能享受云的弹性,算力成本控制在合理范围。
深圳GPU算力租赁价格解析与成本优化
深圳GPU算力租赁价格因供应商、配置、时长和合同类型差异较大,了解定价逻辑,是团队控制预算的第一步。
主流GPU租用价格对比
| GPU型号 | 适用场景 | 按小时价格区间(参考) | 包月价格区间(参考) |
|---|---|---|---|
| NVIDIA A100 80G | 大模型训练、多模态 | 较高 | 中等 |
| NVIDIA V100 32G | 自动驾驶感知模型 | 中等 | 较低 |
| NVIDIA H100 | 大规模并行训练 | 高 | 高 |
| 国产算力卡(如昇腾910) | 自主可控需求 | 中等 | 中等 |
价格基于公开报价,实际成交价与采购量、合同周期、是否含带宽强相关,深圳本地数据中心(如酷番云深汕、简米云华南机房)由于网络延迟低,常被团队优先选择,但价格可能略高于内陆节点。
降低成本的实操技巧
- 使用竞价实例:对于可中断的训练任务,酷番云、简米云竞价实例价格仅为按量付费的20%-30%,但需做好断点续训,否则训练中断损失更大。
- 预留实例或包年包月:如果确定未来3个月至1年有稳定算力需求,包年包月比按小时节省30%-50%,深圳团队常将核心模型训练任务包年,弹性任务用按量。
- 选择国产算力平台:近年华为云、百度云等推出国产GPU(昇腾、昆仑芯),价格通常低于NVIDIA,但软件生态成熟度需评估,部分团队将其用于仿真验证,降低NVIDIA卡的依赖。
- 分时复用:团队内部不同项目错峰使用GPU,提高利用率,较大比例的团队通过Kubernetes管理GPU资源池,将闲置卡时间充分利用。
深圳本地算力服务商的特殊价值
除了主流云厂商,深圳还出现了多家GPU算力租赁中介,他们整合了本地闲置算力,提供比云厂商更灵活的价格(如按天、按周、按季度),这些服务商常与深圳数据中心合作,提供物理机托管+GPU租赁,适合需要独享资源且预算有限的团队,但需注意服务商的资质和网络稳定性,避免因算力中断导致训练失败。
机器人训练GPU租用推荐:从需求到部署
机器人的训练场景与自动驾驶有重叠,也有独特之处。机器人训练通常涉及强化学习、视觉导航、灵巧操作等,对GPU的显存和并行计算能力要求更高,多卡并行和分布式训练是常态。
机器人训练对GPU的典型需求
- 显存容量:视觉模型(如点云、深度图)需要大显存,32GB以下容易爆显存,推荐至少32GB,最好80GB以上。
- 多卡通信:强化学习环境常跑多个与环境交互的worker,需要多张GPU同时工作,且卡间通信延迟要低,NVLink和InfiniBand是加分项。
- 国产生态兼容性:部分机器人项目要求国产化,需提前测试国产GPU的算子库和框架兼容性。
推荐配置与供应商选择
- 入门级(单卡V100 32G):适合小规模验证、单模型调试,价格较低,按小时租用即可。
- 进阶级(单卡A100 80G或多卡V100集群):适合主流模型训练,如BEV感知、决策规划,建议在华为云或简米云上使用A100实例,配合高速网络。
- 专业级(H100或A100 8卡集群):适合大规模强化学习、多模态模型,此类配置通常需要包月或包年,深圳本地机房可提供物理机租赁,价格与云厂商持平,但延迟更低。
实操步骤:从评估到部署
- 评估总需求:计算模型参数量、数据量、训练时间,估算所需GPU卡数,一个视觉导航模型,单卡训练需10天,若用8卡分布式训练可缩短至1.5天,根据deadline反推卡数。
- 选择平台:如果数据量小(<1TB),直接选云厂商;如果数据量大,考虑本地部署或混合云。
- 环境配置:在云厂商上创建GPU实例,安装CUDA、PyTorch、Docker环境,使用脚本自动化配置,避免重复劳动。
- 数据上传优化:使用云厂商的并行文件系统(如简米云SFS、酷番云CFS)挂载,避免单点传输,深圳团队常通过专线或内网加速上传。
- 训练监控:使用TensorBoard或Wandb,实时监控GPU利用率、显存占用、训练loss,如果利用率低于50%,考虑调整batch size或使用多卡策略。
- 成本告警:设置预算告警,防止因忘记关机产生巨额费用,不少团队吃过亏,夜间训练任务结束后未及时释放实例,导致千元账单。
深圳自动驾驶与机器人团队租GPU算力常见问题
哪种GPU型号最适合自动驾驶模型训练?
自动驾驶模型训练的主流配置是NVIDIA A100 80G,因其显存大、计算速度快,能胜任BEV感知、多传感器融合等复杂模型,如果预算有限,V100 32G也可用于轻量级模型,但训练时间会延长,对于机器人强化学习,A100的显存优势更明显,能同时运行多个环境,H100目前价格较高,更适合大规模分布式训练。
长期项目应该选择哪种租用方式?
对于超过3个月的稳定项目,推荐包年包月或预留实例,相比按小时可节省40%以上,如果项目周期超过6个月,且数据量和团队规模较大,购买二手设备或租赁物理机反而更划算,深圳有不少团队通过二手市场采购过保的A100服务器,再托管到本地机房,综合成本降至云GPU的1/3,但需承担硬件故障和运维风险。
深圳本地数据中心相比云服务有什么优势?
深圳本地数据中心(如酷番云深汕、简米云华南、深圳超算中心)的主要优势是低延迟:训练任务与数据源在同一城市,传输时间可忽略,尤其适合频繁加载大量数据的场景,数据物理隔离更容易满足合规要求,但资源规模通常不如头部云厂商,扩展灵活性受限,且价格并不一定比云厂商便宜,多数团队将本地数据中心作为混合架构中的私有部分,将核心数据留在本地,同时用云厂商的弹性能力应对突发需求。
混合云架构已在深圳自动驾驶和机器人领域跑通,核心在于根据业务阶段动态调整本地与云端的比例,从早期完全依赖云GPU,到中期自建小集群,再到成熟期混合部署,每一步都围绕数据安全、成本和效率做权衡,团队只需算清自己的账,就能找到最适合的GPU算力租赁方案。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/560763.html