在IO编程中,缓存是连接内存与磁盘的关键桥梁,合理利用缓存策略能大幅提升IO性能,降低延迟和资源消耗。
IO编程缓存优化:从缓冲区到内存映射
调整缓冲区大小:读写效率的直接影响因素
每次IO操作都伴随着系统调用,而系统调用是开销较大的操作,通过设置缓冲区,可以将多次小规模读写合并为一次批量操作,显著减少调用次数。
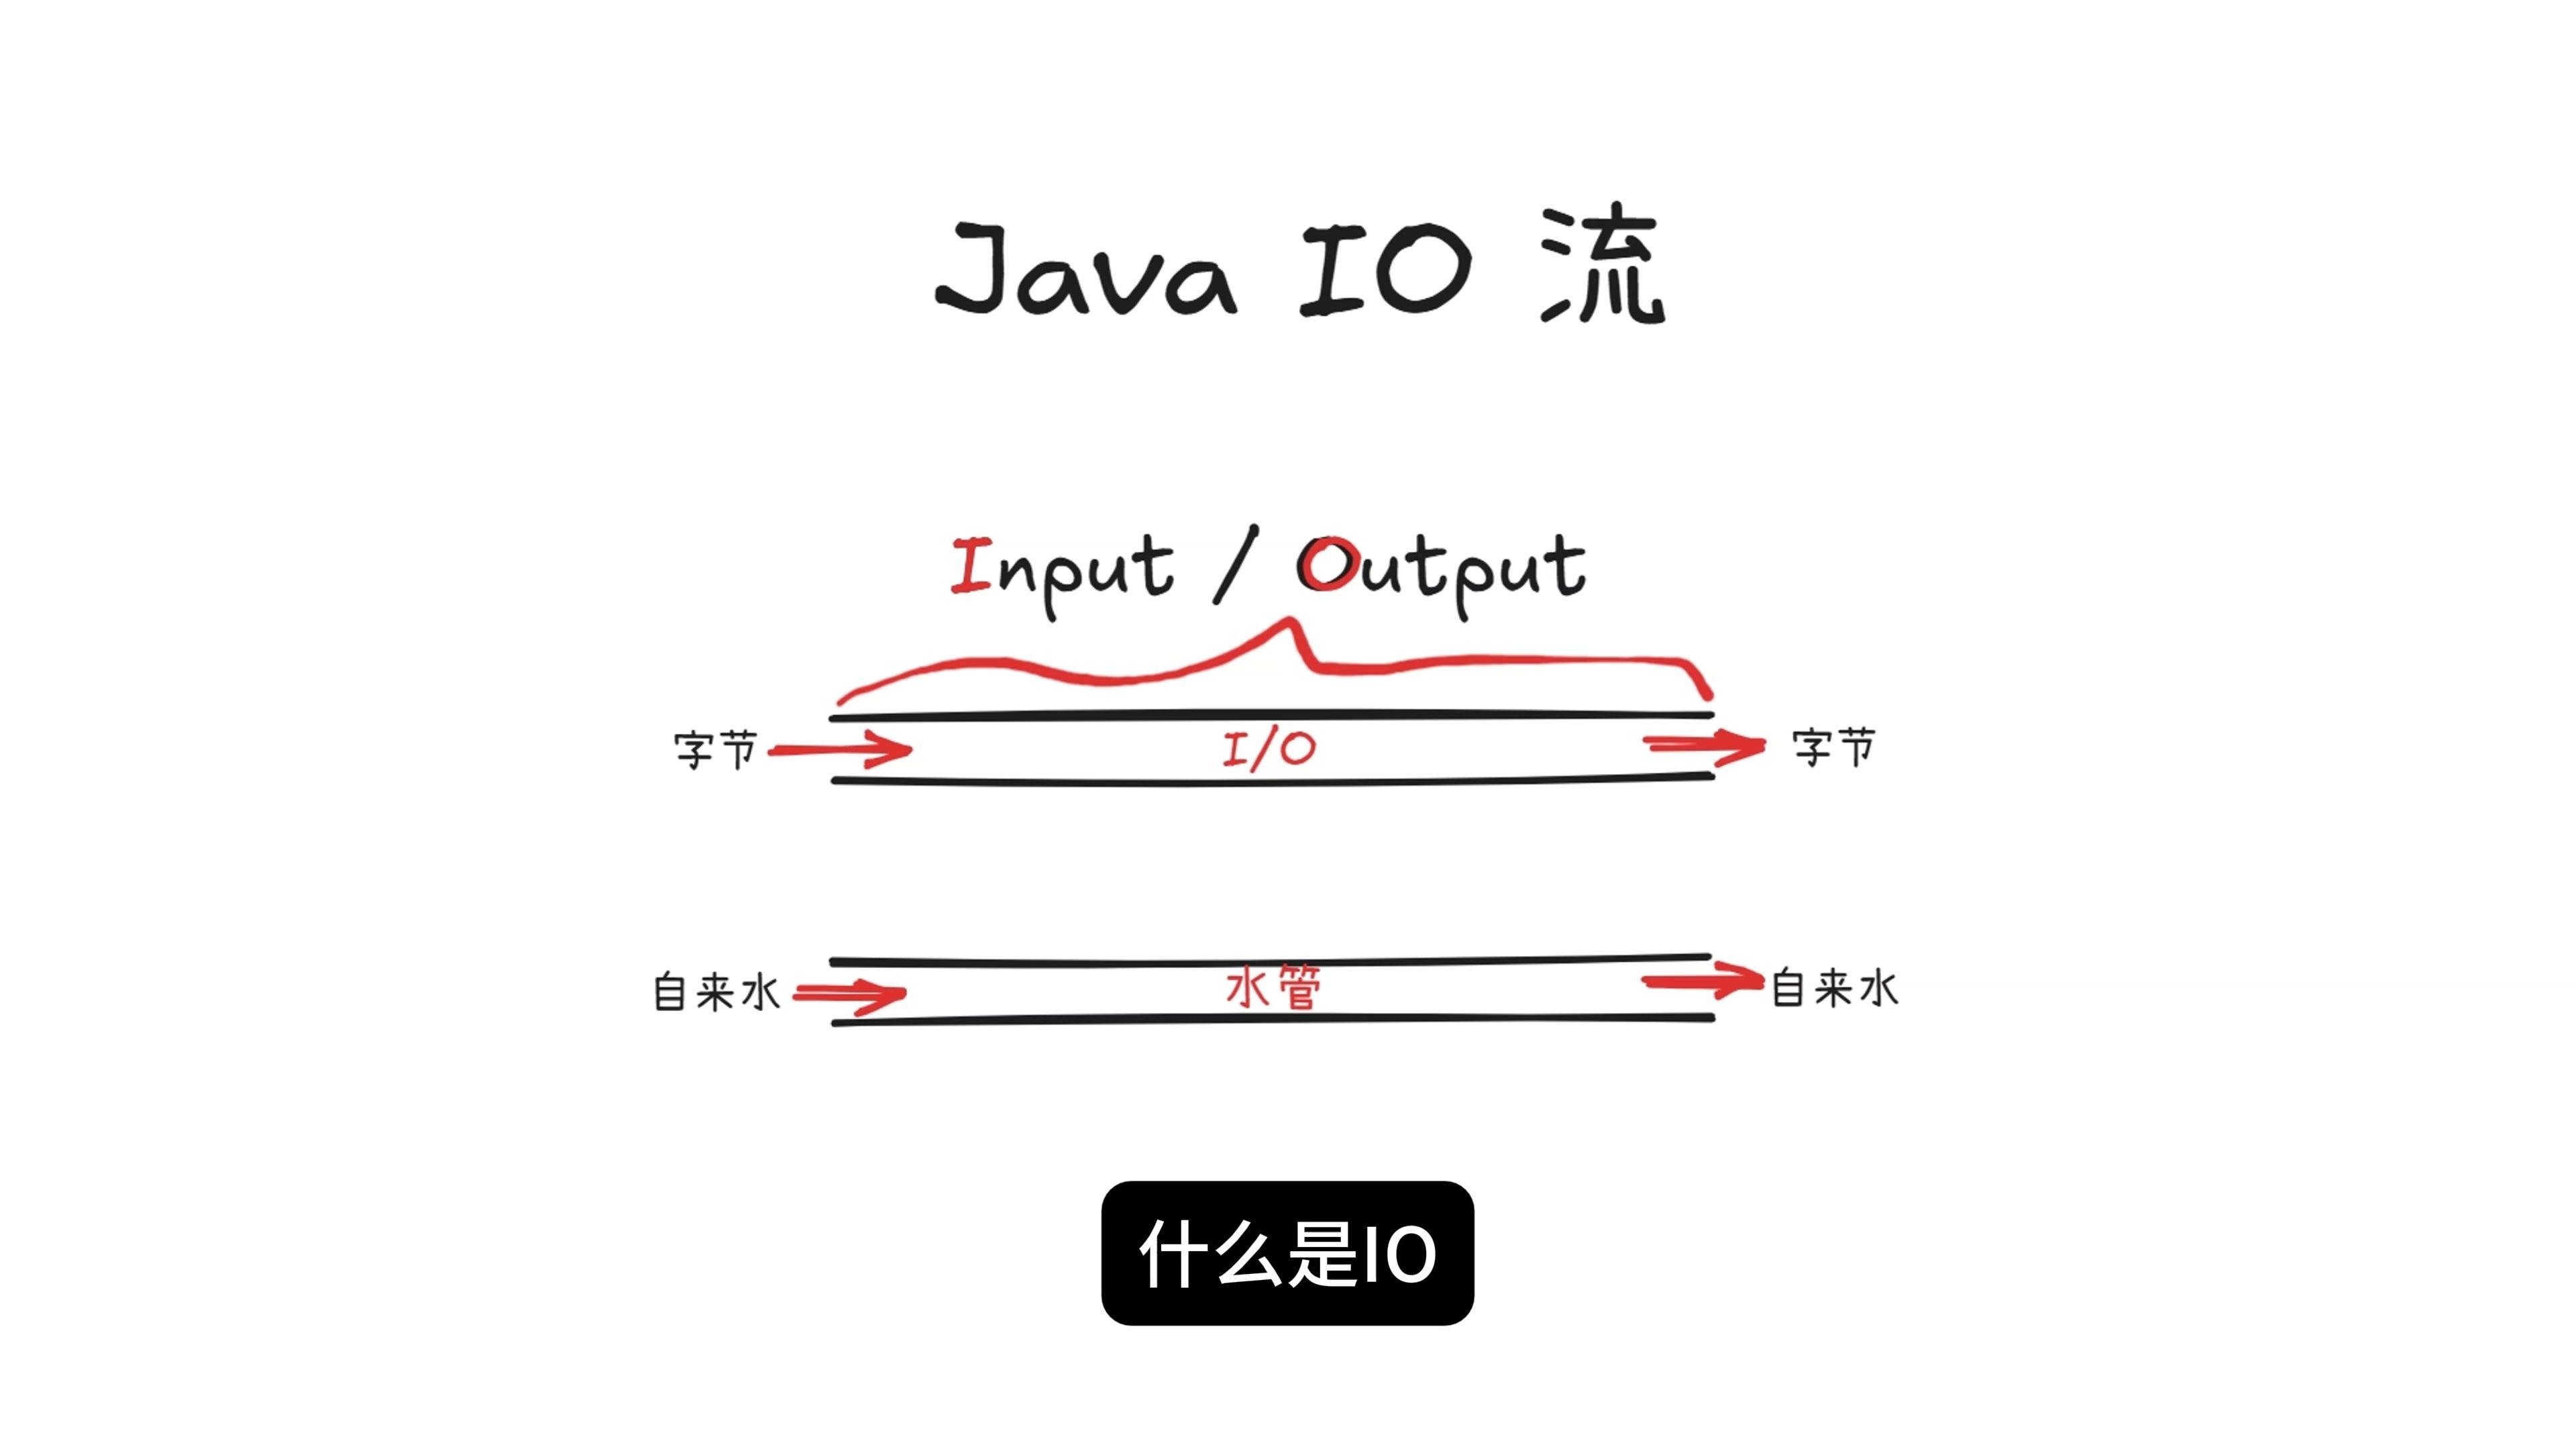
- 在Java中,BufferedInputStream默认缓冲区大小为8KB,你可以通过构造函数传入自定义大小。
- 实际场景中,读一个100MB的日志文件,使用8KB缓冲区需要发起约12800次系统调用;若将缓冲区增至64KB,调用次数降至1600次,整体耗时能减少一半以上。
- 但缓冲区并非越大越好:过大会浪费内存,且在物理内存有限的服务器上可能引发频繁换页,反而拖慢性能。
- 调优建议:在压测环境中逐步增加缓冲区大小,观察吞吐量随内存消耗的拐点,选择性价比最高的尺寸。
内存映射文件:绕过系统调用的大文件方案
内存映射(Memory-Mapped File)将文件直接映射到进程的虚拟地址空间,读写操作如同操作内存,完全避免了用户态与内核态之间的数据拷贝。
- 适用场景:大文件的随机读写,例如数据库索引文件、视频编辑软件中的素材文件。
- 代码层面,Java通过FileChannel.map()创建映射,映射后返回MappedByteBuffer,操作它就像操作一个byte数组。
- 代价:映射建立需要一定开销,且映射区域大小受虚拟地址空间限制(但现代系统足够大)。
- 业内专家指出,对于超过几百MB的文件,内存映射方式比传统读写快数倍,特别是在随机访问模式下,优势更加明显。
Java IO与NIO缓存效率对比:何时选择NIO?
传统IO(BIO)的缓存机制
传统IO基于流(Stream),每个read/write都是一次系统调用。
- BufferedInputStream/BufferedOutputStream在用户态维护一个byte数组,通过减少系统调用来提升效率。
- 但BIO是阻塞的:每个线程在调用read时必须等待数据就绪,浪费CPU资源。
- 多线程并发时,每个连接需要一个线程,线程切换成本高,不适合高并发场景。
NIO(New IO)的缓存与通道
NIO引入了Channel和Buffer的概念,所有数据读写都通过Buffer进行。
- 支持直接缓冲区(DirectBuffer),分配在操作系统的内存,Channel与Buffer之间的数据传输无需额外拷贝。
- 配合Selector多路复用,一个线程可以管理成百上千个通道,非阻塞模式让线程永远不会被挂起。
性能对比表
| 对比维度 | 传统IO (BIO) | NIO |
|---|---|---|
| 缓存方式 | 用户态byte数组 | 堆内/直接缓冲区 |
| 系统调用次数 | 每次读写都调用 | 通过Buffer批量处理,调用次数少 |
| 并发模型 | 多线程,每连接一线程 | 单线程管理多个通道(Selector) |
| 适用场景 | 连接数少且长连接 | 高并发、短连接或文件传输 |
| 直接缓冲区支持 | 无 | 有,减少一次拷贝 |
行业共识认为,在连接数超过几百时,NIO的吞吐量显著优于BIO,且CPU占用更低。
直接缓冲区与堆内缓冲区的选择
- DirectBuffer:创建和销毁成本高,但写入Channel时零拷贝,适合长生命周期、大块数据。
- HeapBuffer:在JVM堆内分配,创建快,但写入Channel时需临时拷贝到DirectBuffer,适合短生命周期、小数据量。
- 选择原则:如果数据需要反复使用,且生命周期较长,优先用DirectBuffer;如果只是临时组装,用HeapBuffer更经济。
Linux IO模型选择场景:阻塞与非阻塞的权衡
阻塞IO:简单但低效
- 进程发起read后,如果没有数据就绪,进程会阻塞直到数据到达。
- 适合连接数极少、对延迟不敏感的场景,如简单的日志收集脚本。
- 缺点:每个连接需要一个独立线程,当连接数增加时,线程数暴涨,上下文切换开销急剧上升。
非阻塞IO与IO多路复用
- 非阻塞模式下,read立即返回,如果没有数据则返回
-1或EWOULDBLOCK,需要上层轮询。 - 多路复用(epoll、select、poll)监听多个文件描述符,当某个fd可读时可写时再通知进程,避免了轮询开销。
- Redis 是典型例子:单线程使用epoll处理数万个客户端连接,每个请求处理时间极短,结合自定义内存缓存,实现了极致性能。
异步IO(AIO)
- 内核完成整个IO操作后再通知进程,理论上效率最高。
- 但Linux AIO(libaio)在磁盘文件上表现不如epoll稳定,且编程复杂度高,业界共识认为它更适合大文件异步读写,而非网络IO。
缓存替换策略LRU与LFU:不同场景如何选?
LRU(最近最少使用):最通用的选择
- 淘汰最久未访问的缓存项,实现简单,常见于Redis、Memcached。
- 默认策略:volatile-lru(针对有过期时间的key)或allkeys-lru。
- 适用场景:数据访问模式有明显的时间局部性,即最近访问过的数据很可能再次被访问。
LFU(最不经常使用):应对突发热点
- 淘汰访问频率最低的项,能避免一个热点数据因长时间未被访问而被LRU误淘汰。
- 实现需维护每个key的访问频次,复杂度较高。
- 在Redis中,通过maxmemory-policy lfu启用,适合访问模式有长期频率差异的场景,例如缓存。
其他策略快速对比
- FIFO:先进先出,适合流式数据,实现简单但命中率低。
- TTL:过期自动淘汰,适合时效性强的数据,如验证码。
- Random:随机淘汰,极少使用,仅在无法判断访问模式时作为兜底。
IO编程缓存常见问题与解答
问题1:IO编程中缓存设置多大合适?
缓存大小取决于IO模式、数据大小和内存资源,对于顺序读写,较大缓存(如1MB)能提升吞吐;对于随机读写,小缓存(如4KB)减少浪费,实践中通过压测确定最佳值,通常从2KB开始逐步增大,观察吞吐量曲线。
问题2:内存映射文件比普通IO快多少?
内存映射文件避免了多次拷贝和系统调用,对于大文件随机访问,性能提升明显,但映射建立有开销,不适合频繁打开关闭的小文件,据统计,在文件大于几百MB时,映射方式比传统读写快数倍。
问题3:NIO的DirectBuffer与HeapBuffer区别是什么?
DirectBuffer分配在操作系统内存,写入通道时无需拷贝,但创建和销毁成本高;HeapBuffer在JVM堆内,但写入通道时需临时拷贝到DirectBuffer,适合短生命周期数据,选择时需权衡分配频率和传输大小。
IO编程中的缓存优化并非单一技巧,而是需要结合IO模型、缓存策略和硬件特性综合设计,理解底层原理,才能在实际项目中做出正确取舍。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/558716.html