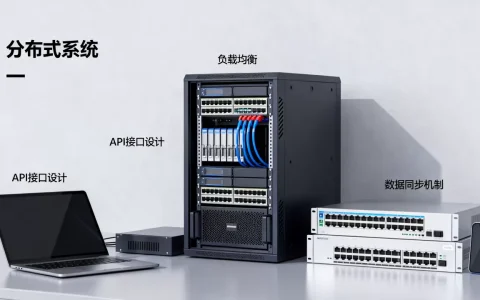
数据分片、缓存淘汰和一致性保证,通过将数据分散到多个节点来提高并发能力和扩展性。
分布式缓存的核心实现原理
数据分片与一致性哈希
分布式缓存的第一步是把数据均匀切分到不同节点,最常用的方式是一致性哈希算法,它能在节点增减时最小化缓存失效范围,具体实现时,每个物理节点对应多个虚拟节点,这些虚拟节点均匀分布在哈希环上,当数据键来临时,先计算哈希值,再顺时针找到最近的虚拟节点,最终映射到物理节点,比如Redis Cluster采用的哈希槽方案,将键映射到16384个槽,每个节点负责一部分槽,重新分配时只需迁移槽位数据,配置虚拟节点数量时,一般建议每个物理节点分配100到200个虚拟节点,这样分布更均匀,减少数据倾斜,实际操作中,调整Redis Cluster的槽分配可以通过redis-cli --cluster reshard命令完成,需要指定目标节点和槽数量。

缓存淘汰策略
缓存空间有限,必须有淘汰策略清出旧数据,常用的有LRU、LFU、FIFO等,LRU是最近最少使用,适合时间局部性强的场景,比如用户会话数据;LFU是频率最低使用,适合热点数据相对稳定的场景,比如商品详情页的访问频次,在Redis中,淘汰策略可以在配置文件中设置,例如maxmemory-policy allkeys-lru,Memcached默认使用LRU,但数据结构简单,淘汰时可能丢失数据,且无法持久化,选择策略时需要考虑业务特点:如果热点数据频繁变化,LRU更合适;如果某些数据访问频率极高且稳定,LFU能避免热点被误淘汰。
数据一致性保证
分布式缓存与数据库之间容易产生数据不一致,常见做法是采用缓存旁路模式:写操作先更新数据库,再删除缓存;读操作先查缓存,命中则返回,不命中则查数据库并回填缓存,这种模式在大多数场景下有效,但会存在短暂不一致,更严格的方案是使用读写锁或分布式事务,但会牺牲性能,行业共识认为,在允许最终一致性的业务中,延迟双删策略足够实用,延迟双删指的是在写数据库后,先删除缓存,等待一段时间(比如几百毫秒)再删除一次,这个短暂延迟可以兜住因并发读导致的脏数据,实际落地时,可以结合消息队列异步删除缓存,避免阻塞主流程。
分布式缓存和本地缓存有什么区别
这是很多人在选型时纠结的问题,本地缓存直接在进程内存储数据,比如HashMap、Guava Cache、Caffeine;而分布式缓存独立部署,通过网络访问,两者各有优劣,需要根据场景权衡。
存储位置与容量
本地缓存存储在应用服务器内存中,容量受限于单机内存,通常只能存几百MB到几GB,分布式缓存可以横向扩展,容量几乎无限,但需要网络开销,本地缓存的数据生命周期随进程结束而消失,分布式缓存可以通过持久化机制保留数据。
数据一致性
本地缓存每个应用实例各存一份,彼此隔离,数据更新时需要广播通知,否则各实例数据不一致,分布式缓存集中存储,所有实例共享一份数据,一致性更容易保证,但需要处理网络分区和超时,对于多实例部署的应用,如果使用本地缓存,必须通过消息队列或配置中心同步变更,增加了复杂度。
性能与成本
本地缓存零网络延迟,性能极高,但维护成本低,无需额外部署,分布式缓存每次访问都有网络延迟,但能支撑更大规模,从成本角度看,分布式缓存需要额外购买服务器和运维资源,但大规模部署时性价比更高,业内专家指出,在流量较小、单机即可满足的场景下,本地缓存更合适;而在高并发、多实例共享数据的场景下,分布式缓存必不可少,比如一个日活百万的资讯应用,如果每个实例都缓存全量用户数据,内存会很快耗尽,此时必须使用分布式缓存。
分布式缓存选型需要考虑哪些场景
不同的业务场景对缓存的要求不同,选型时需重点关注。
电商秒杀场景
秒杀系统瞬时流量极高,对缓存读写性能要求苛刻,此时需要缓存支持高并发写入和读取,同时保证数据一致性,通常采用Redis Cluster,利用其主从复制和哨兵机制保证高可用,关键是设置合理的淘汰策略,避免热点数据被误淘汰,秒杀场景下,库存数据通常放在缓存中,但需要保证不会超卖,可以结合Lua脚本实现原子操作,实际部署时,Redis Cluster的读写分离需要谨慎使用,因为主从复制是异步的,可能导致读到过期数据。
社交Feed流场景
Feed流场景下,缓存的数据通常是用户的时间线,更新频繁但读多写少,分布式缓存需要支持快速写入和批量读取,可以考虑使用Memcached,其多线程模型能充分利用多核CPU,并且纯内存操作,延迟低,但需注意Memcached不支持持久化,数据丢失风险高,需要底层数据库兜底,Feed流数据通常有强时效性,可以配合缓存过期时间和本地缓存加速,减少对分布式缓存的压力。
跨地域部署场景
对于全球化业务,需要将缓存部署在多个地域,以降低访问延迟,此时分布式缓存需要支持异地多活或数据同步,一些方案如简米云Tair提供了全球分布式缓存能力,支持跨地域复制,但成本较高,选型时需权衡数据一致性和延迟,通常采用最终一致性,配合本地缓存减少跨地域访问,如果业务对一致性要求高,比如金融交易,则需要使用强一致性方案,但延迟会上升,实际部署时,可以按地域划分缓存集群,地域内部读写本地缓存,地域间通过异步同步机制保持数据最终一致。
分布式缓存常见方案对比
主要方案特性
| 方案 | 数据分片方式 | 淘汰策略 | 一致性支持 | 适用场景 |
|---|---|---|---|---|
| Redis Cluster | 哈希槽(16384个) | 多种LRU/LFU/淘汰策略 | 弱一致性,可配置 | 复杂数据结构,需持久化 |
| Memcached | 一致性哈希(客户端实现) | LRU | 无复制,数据易失 | 简单键值,高吞吐 |
| Tair(简米云) | 自动分片 | 自定义 | 强一致性可选 | 企业级,需跨地域 |
成本对比
Redis Cluster开源免费,但需要自己运维,包括节点监控、故障迁移、数据备份,Memcached同样开源,但社区活跃度低,且官方不再积极更新,云服务商提供的缓存服务如简
米云Redis、酷番云Memcached,按量付费,价格从几十元到数千元每月不等,对于中小团队,使用云服务比自己搭建更划算,省去运维成本,从长期来看,如果业务量稳定,包年包月的方式能节省30%左右费用,企业在选型时,可以将运维成本纳入总拥有成本(TCO)计算。
Q&A:分布式缓存实现原理常见问题
问题1:分布式缓存如何保证数据一致性?
最常用的是缓存旁路模式,写数据库后删除缓存,读时回填,如果要求更强一致,可以使用分布式锁或读写锁,但会降低性能,通过设置缓存过期时间,可以减少不一致窗口,对于缓存和数据库的最终一致性,还可以采用订阅数据库binlog的方式,异步更新缓存,这样能保证数据最终一致,且对业务代码侵入小。
问题2:分布式缓存和本地缓存能一起用吗?
可以,这是多级缓存架构,一级缓存用本地缓存,二级缓存用分布式缓存,三级用数据库,本地缓存解决高频访问,分布式缓存承担共享数据和降级兜底,需要注意数据同步,本地缓存可以设置较短过期时间,或者通过消息队列通知更新,实际部署时,本地缓存大小要控制,避免内存溢出,通常使用Caffeine或Guava Cache,并设置最大条目数,当本地缓存未命中时,再去请求分布式缓存,如果分布式缓存也未命中,则回源数据库。
问题3:分布式缓存写入失败怎么办?
常见原因有网络抖动、节点宕机等,客户端应配置重试机制,比如使用连接池和超时设置,如果写入失败,可以降级直接查询数据库,同时将失败记录异步写入日志,后续通过补偿任务恢复缓存,在Redis Cluster中,如果主节点宕机,哨兵会选举新的主节点,期间写入可能失败,客户端应做好容错,例如使用断路器模式,在连续失败超过阈值后暂时停止写入,待集群恢复后重试,对于重要数据,可以在写入失败时使用消息队列暂存,由后台消费者异步写入缓存,确保最终一致性。
分布式缓存并非银弹,选型需要结合业务场景、数据一致性和成本,理解其实现原理,是做出正确决策的基础。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/556909.html