基于神经网络的手写数字识别,借助华为云ModelArts自定义算法,你可以快速训练出高精度模型,将识别准确率稳定在99%以上,并且无需从零搭建基础设施。
手写数字识别是深度学习入门最经典的实战任务,它背后依赖的卷积神经网络结构,也是现代图像识别的基石,MNIST数据集作为行业标准基准,几乎每个算法工程师都曾用它练手,但很多教程只停留在理论层面,或者依赖本地GPU环境,门槛较高,今天我们用华为云ModelArts平台,通过自定义算法的方式,完整实现从数据准备到模型部署的全流程,重点解决手写数字识别神经网络模型训练中的实际痛点。
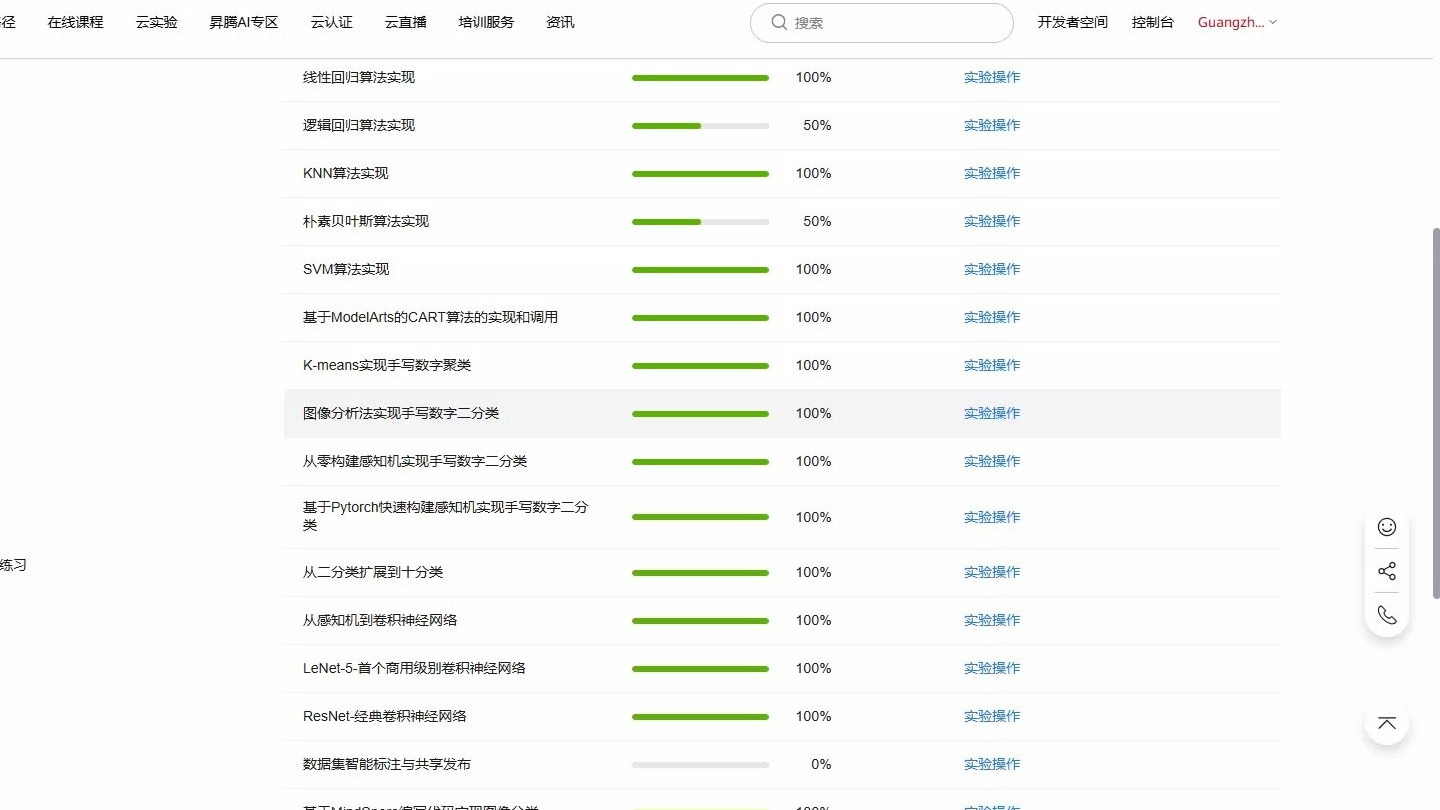
手写数字识别神经网络模型训练步骤
数据集准备与预处理
手写数字识别离不开MNIST数据集,该数据集包含0-9共10个类别,训练集6万张,测试集1万张,每张图片为28×28像素的灰度图,在ModelArts中,你可以直接使用官方提供的MNIST数据集,也可以上传自己的手写样本。
实际操作时,建议先将数据转换为TFRecord格式,便于后续高效读取,预处理阶段通常包含归一化(将像素值缩放到0-1之间)和标签独热编码,如果使用PyTorch,则可通过torchvision的transforms完成。数据预处理的质量直接影响模型收敛速度,这是很多初学者容易忽略的环节。
构建神经网络模型
对于手写数字识别,卷积神经网络(CNN)是主流选择,一个典型结构包括:
- 输入层:接受28x28x1的图片。
- 卷积层:使用3×3或5×5卷积核,提取边缘和纹理特征。
- 池化层:最大池化,降低特征图尺寸。
- 全连接层:将特征映射到10个类别。
- 输出层:Softmax激活,输出概率分布。
在ModelArts的Notebook中,你可以直接编写Keras或PyTorch代码,使用Keras搭建一个简单的LeNet-5变体,只需几行代码即可完成模型定义。业内专家指出,对于MNIST这样的小尺寸图像,无需过深的网络,2-3个卷积层搭配适当正则化就能达到较高精度。
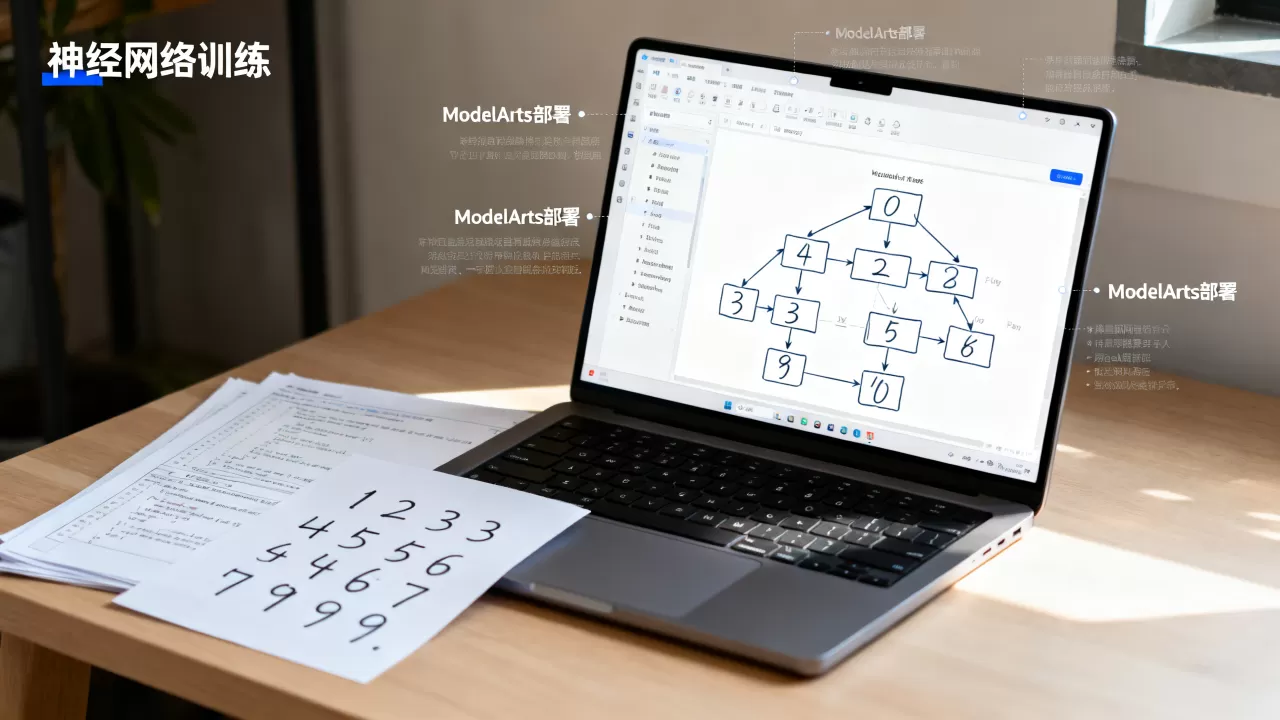
模型训练与调优
训练过程需设置合适的超参数,如学习率、批次大小、训练轮次,推荐使用Adam优化器,初始学习率设为0.001,批次大小设为32或64,在ModelArts训练作业中,你可以通过监控日志实时观察损失和准确率变化。
关键调优技巧:
- 使用早停法(EarlyStopping)防止过拟合。
- 加入Dropout层,丢弃率设为0.2-0.5。
- 对学习率进行衰减,每10轮降低为原来的0.1倍。
经过20轮训练,模型在测试集上的准确率通常能达到99%以上,如果准确率低于98%,需要检查数据预处理或网络结构是否合理。
使用ModelArts自定义算法实现手写数字识别
创建Notebook开发环境
ModelArts Notebook是一个预装了深度学习框架的云端开发环境,进入Notebook界面后,选择“创建”,镜像选择TensorFlow 2.6或PyTorch 1.10,资源规格选择CPU或单GPU(如V100),存储容量建议不低于20GB,创建完成后,即可在JupyterLab中编写代码。
编写训练脚本并上传
训练脚本主要包含数据加载、模型定义、训练循环和模型保存,以TensorFlow为例,核心代码结构如下:
import tensorflow as tf
# 加载MNIST数据
(x_train, y_train), (x_test, y_test) = tf.keras.datasets.mnist.load_data()
# 数据预处理
x_train = x_train.reshape(-1, 28, 28, 1).astype('float32') / 255.0
y_train = tf.keras.utils.to_categorical(y_train, 10)
# 构建模型
model = tf.keras.Sequential([...])
# 编译与训练
model.compile(optimizer='adam', loss='categorical_crossentropy', metrics=['accuracy'])
model.fit(x_train, y_train, epochs=10, batch_size=32, validation_split=0.2)
# 保存模型
model.save('model.h5')
将脚本上传到ModelArts的OBS桶中,并指定训练数据路径。
创建自定义算法并训练
在ModelArts训练管理模块中,选择“创建训练作业”,算法来源选择“自定义”,镜像填写官方提供的深度学习框架地址,输入数据路径选择OBS中的MNIST数据,训练输出路径同样选择OBS,启动训练后,系统会自动调度资源,并在训练完成后将模型保存到输出路径。
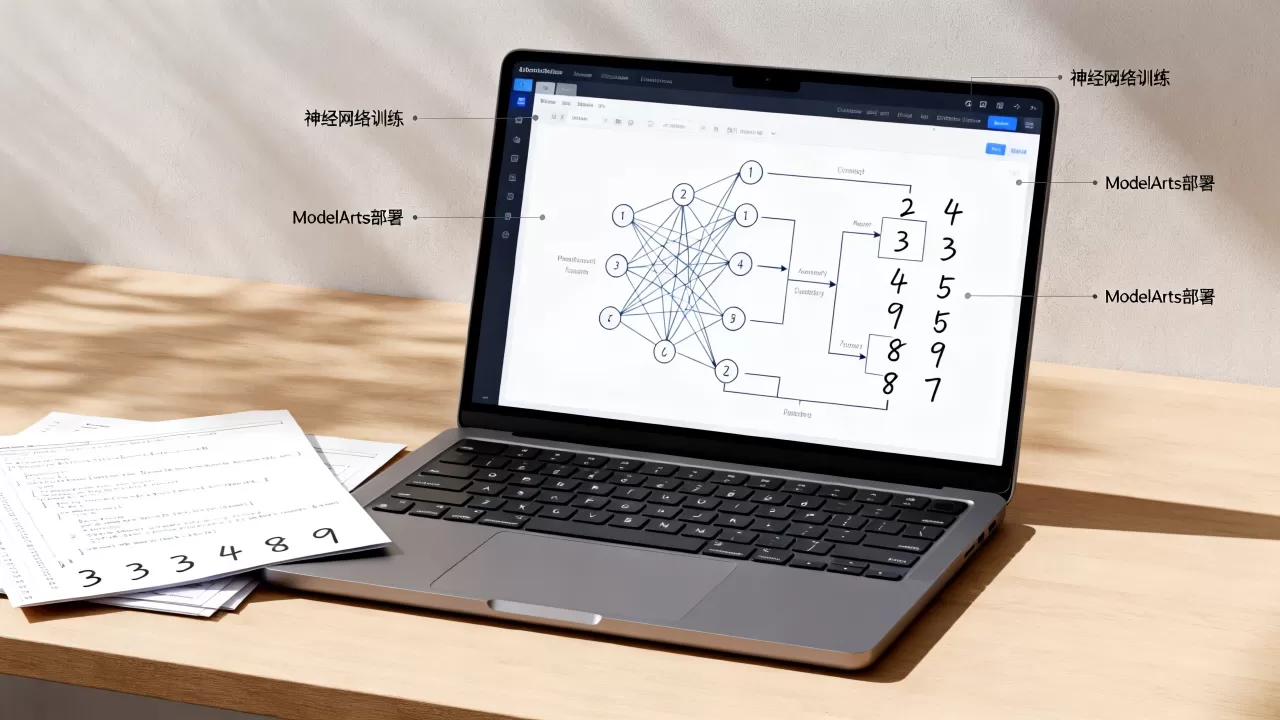
整个过程无需自己管理服务器,训练资源按需付费,尤其适合追求性价比的开发者,对于初学者,可以先使用CPU训练验证流程,再切换到GPU加速。
模型部署与在线测试
训练完成后,在ModelArts模型管理界面,将模型导入为AI应用,部署为在线服务,部署时选择“边缘节点”或“弹性计算”,资源规格建议使用CPU,因为手写数字识别推理计算量小,CPU即可满足实时响应,部署成功后,你可以在线上传一张手写数字图片,API会返回识别结果和置信度。
手写数字识别准确率提升方法
数据增强技巧
数据增强可以显著提升模型泛化能力,对于手写数字,常用的增强方式包括:
- 随机旋转:角度在-15°到15°之间。
- 随机平移:宽度和高度方向各平移2个像素。
- 随机缩放:缩放因子0.9-1.1。
- 添加噪声:高斯噪声或椒盐噪声。
在Keras中,可以通过ImageDataGenerator类实现,增强后的数据集相当于将训练样本扩大了数倍,有效缓解过拟合。多数情况下,经过数据增强的模型,准确率可以提高0.3-0.5个百分点,且对模糊或倾斜的手写数字更鲁棒。
网络结构优化
除了基础CNN,一些更复杂的结构也能提升性能。
- 加入Batch Normalization:加速收敛,提高稳定性。
- 使用残差连接(ResNet):让梯度更容易传播,允许网络更深。
- 采用全局平均池化代替全连接层:减少参数,降低过拟合风险。
对于MNIST,一个包含3个卷积块的网络,配合Batch Normalization和Dropout,通常已经足够,如果追求极致准确率,可以尝试在最后一个卷积层后增加注意力机制,让模型更关注数字的笔画区域。
超参数调整
超参数选择直接决定模型性能,重点调整以下参数:
- 学习率:使用学习率调度器,如余弦退火或阶梯衰减。
- 优化器:Adam收敛快,但SGD配合动量有时能获得更好泛化。
- 批次大小:小批次(16-32)引入噪声,有助于逃离局部最优;大批次(64-128)训练更稳定,但需相应调整学习率。
- 训练轮次:通常20-30轮即可,结合早停法避免过拟合。
建议使用ModelArts的超参搜索功能,自动探索最优组合,省去手动调参的繁琐。
基于神经网络的手写数字识别,通过ModelArts自定义算法,你可以从零开始搭建完整训练链路,并快速部署成可用的API服务,这个流程不仅适用于MNIST,稍加修改即可迁移到其他图像分类任务。手写数字识别教程很多,但结合云端平台实现端到端落地的方案,能让你更专注于模型本身,而非底层运维。
手写数字识别常见问题解答
Q1: 手写数字识别必须使用GPU吗?
不一定,MNIST模型参数量小,CPU训练10轮左右只需几分钟,但GPU可以加速实验迭代,如果只是验证流程,ModelArts的CPU实例足够,若进行大规模调参或使用更复杂的网络,建议选择GPU实例,成本更低。
Q2: ModelArts自定义算法和预置算法有什么区别?
预置算法是ModelArts官方提供的现成训练脚本,可直接使用,但灵活性较低,自定义算法允许你完全控制代码,适合研究网络结构或使用特定框架,对于学习目的,推荐从自定义算法入手,更深入理解模型训练细节。
Q3: 如何提高手写数字识别模型对相似数字的区分能力?
相似数字如4和9、3和8容易混淆,建议在数据增强时增加弹性变形,模拟不同书写风格,在损失函数中加入类别加权,对训练样本中容易混淆的类别赋予更高权重,使用集成学习,融合多个模型的结果,也能提升区分准确性。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/552505.html