如何从零开始准备Iris网络数据,具体操作步骤有哪些?

在机器学习中,使用Iris数据集训练神经网络时,数据准备是决定模型性能的关键环节,包括数据加载、标准化、划分训练集与测试集等步骤。

iris数据准备步骤

iris数据集怎么用?从加载开始

当你拿到一个项目,第一步永远是认识数据,Iris数据集来自UCI机器学习库,包含150个样本,每个样本有4个特征(花萼长度、花萼宽度、花瓣长度、花瓣宽度)和1个标签(山鸢尾、变色鸢尾、维吉尼亚鸢尾),我通常用Python的pandas库直接加载,几行代码就能看清结构:
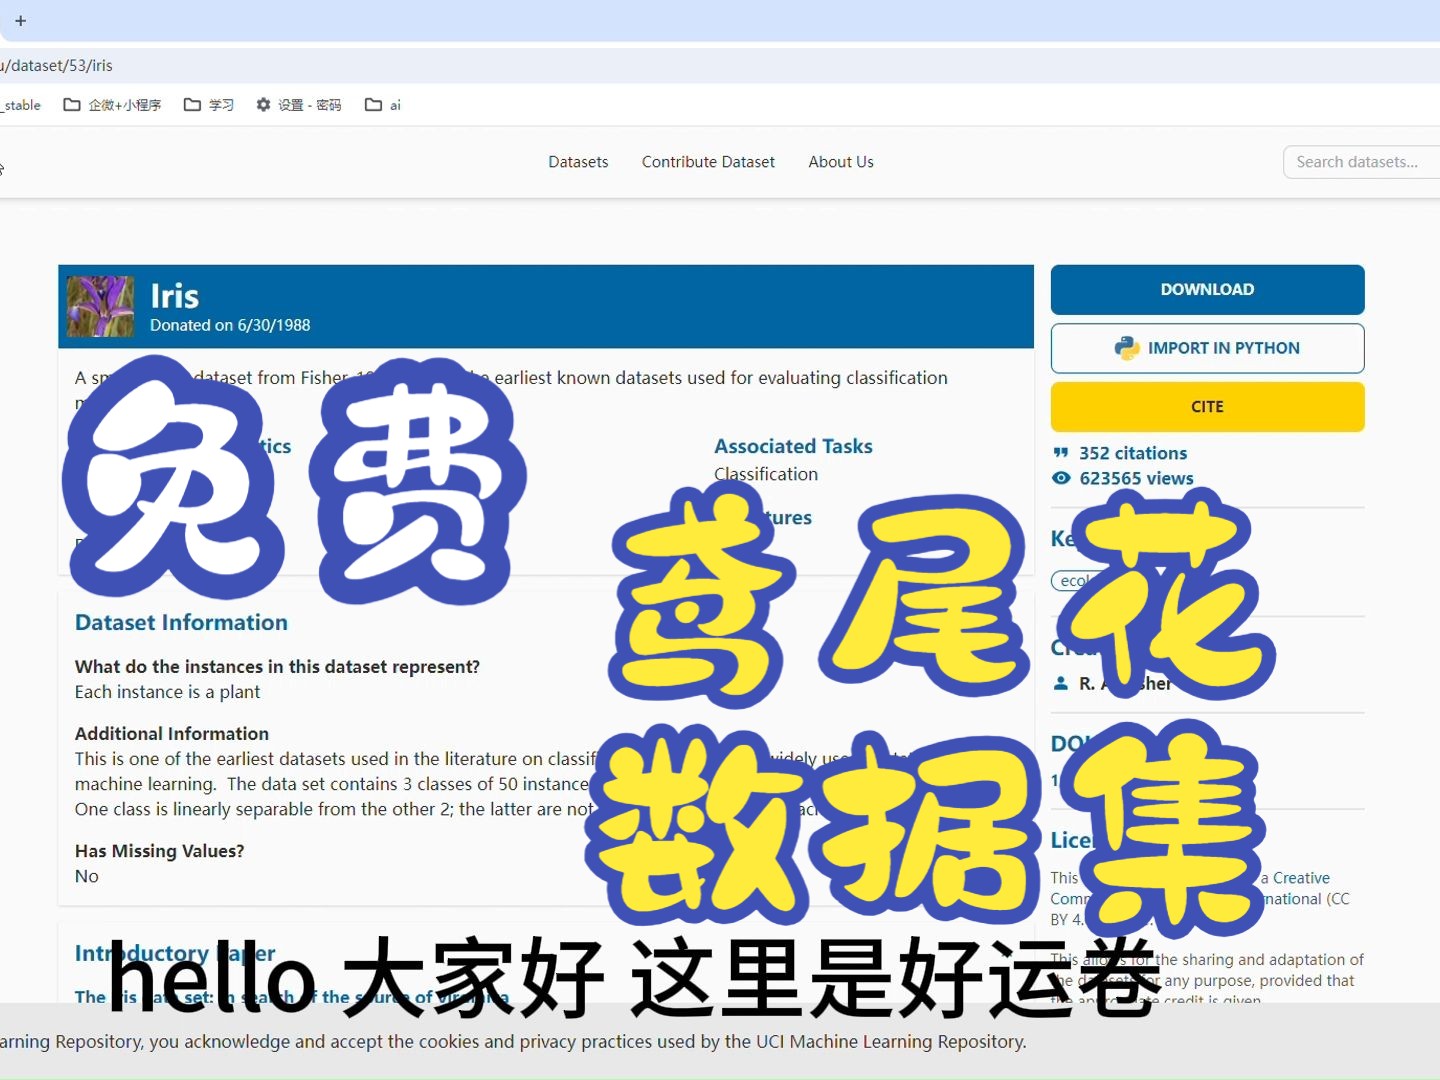
【免费】鸢尾花数据集iris.csv
加载中
【免费】鸢尾花数据集iris.csv
import pandas as pd
from sklearn.datasets import load_iris
iris = load_iris()
df = pd.DataFrame(iris.data, columns=iris.feature_names)
df['target'] = iris.target

加载后,务必用df.head()和df.describe()快速浏览,你会发现特征值范围差异不小花瓣长度在1-6.9之间,而花萼宽度在2-4.4之间,这种差异直接告诉我们需要数据标准化,否则神经网络中权重更新会偏向大数值特征。

数据标准化方法选择

标准化是神经网络训练的前提,常用的方法有两种:Z-score标准化和Min-Max归一化,对于Iris这样量纲差异明显的场景,我倾向于Z-score,因为它能保留数据的分布形态,且对异常值不敏感,实操时用
如何从零开始准备Iris网络数据,具体操作步骤有哪些?

StandardScaler:

from sklearn.preprocessing import StandardScaler
scaler = StandardScaler()
X_scaled = scaler.fit_transform(iris.data)

注意:fit_transform只在训练集上使用,测试集必须用transform,避免数据泄露,如果你不确定选哪种,可以对比一下:Min-Max将数据缩放到0-1之间,适合已知边界的情况;而Z-score假设数据近似正态分布,Iris数据基本符合,所以效果更稳。

划分训练集与测试集

神经网络的训练需要一个独立的验证窗口,我通常按70%训练、30%测试划分,但Iris样本只有150个,所以我会用分层采样确保三个类别在训练集和测试集中的比例一致。train_test_split的stratify参数搞定:

from sklearn.model_selection import train_test_split
X_train, X_test, y_train, y_test = train_test_split(
    X_scaled, iris.target, test_size=0.3, stratify=iris.target, random_state=42
)

random_state固定后,结果可复现,划分后,检查一下每类样本数量,确保不出现极端情况,如果某类在测试集里只有一两个样本,模型评估会失真这时你可以考虑增加测试集比例到0.4,或者用交叉验证。

iris神经网络数据预处理中的常见陷阱

数据泄露问题

新手最容易犯的错误是
如何从零开始准备Iris网络数据,具体操作步骤有哪些?

在标准化之前就划分数据,如果你对整个数据集做fit_transform,然后才分割,那么测试集的信息已经参与了标准化参数的估计(均值和方差),这相当于把测试集的答案泄露给了模型,正确顺序是:先划分,再对训练集fit_transform,对测试集只transform,我见过不少人因为这个操作导致模型在测试集上表现虚高,拿到真实场景立刻崩盘。

标准化参数拟合

另一个细节:标准化器只能从训练集拟合,比如你用了StandardScaler,scaler.fit()必须基于X_train,然后scaler.transform(X_test),如果测试集是单独来的,你要保存这个scaler对象,用pickle或joblib存起来,推理时重新加载,否则,线上数据与训练时分布不一致,结果会偏差。

类别不平衡处理

Iris数据集本身是平衡的,每类50个样本,但如果你自己收集数据时偏了,比如某类样本特别少,神经网络会偏向多数类,解决办法:对少数类做过采样(如SMOTE)或对多数类做欠采样,从我的经验看,过采样更适合小数据集,因为欠采样会丢失信息,但你也可以调整类别权重,让模型在损失函数中惩罚少数类错误,比如class_weight='balanced'
如何从零开始准备Iris网络数据,具体操作步骤有哪些?

,大多数库都支持。

掌握iris数据准备,提升神经网络模型效果

数据准备不是一次性工作,而是反复调试的过程,从加载到标准化,再到划分和平衡,每一步都直接关联最终模型的泛化能力。Iris数据集虽小,但它的数据准备流程是神经网络项目的通用模板,你只需要把特征列换成自己的数据,调整标准化参数,这份步骤就能直接复用。

iris网络数据准备常见问题解答

问:iris数据集怎么用?需要下载吗?

答:不需要单独下载,Python的sklearn库内置了load_iris函数,直接从库中读取即可,如果你需要原始CSV文件,UCI机器学习库也提供免费下载,但建议直接用库版本,避免格式问题。

问:iris数据准备需要几步才算完整?

答:至少五步:加载数据、探索性分析、特征与标签分离、标准化、划分训练集与测试集,如果数据存在缺失或异常,还需要清洗步骤,多做一步数据增强或可视化,对模型理解也有帮助。

问:iris数据标准化选哪种方法更好?

答:多数情况下用Z-score标准化,因为Iris特征近似正态分布,且样本量小,Z-score能保留分布信息,Min-Max归一化在特征值有明确边界时更合适,但Iris特征没有固定边界,所以Z-score是更稳妥的选择。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/551608.html

赞 (0)
IP数据库查询程序如何查询浮动IP,有哪些方法?
上一篇 2026年8月6日 17:42
HP服务器电源线多少钱一根,哪里买最便宜
下一篇 2026年8月6日 17:44

相关推荐

  • 大模型分布式训练DeepSpeed ZeRO教程怎么用?DeepSpeed ZeRO优化原理

    DeepSpeed ZeRO通过将模型状态分片存储,显著降低显存占用,使单卡可训练更大参数规模的模型,是解决大模型分布式训练显存瓶颈的核心方案,在2026年的大模型开发场景中,显存焦虑依然是工程师们最头疼的问题,当你试图在有限的GPU资源上训练千亿参数模型时,传统的并行策略往往力不从心,DeepSpeed Ze……

    2026年6月17日
    3100
  • 服务器维护外包靠谱吗?找哪家服务商性价比高

    服务器维护外包并非简单的“甩手掌柜”,而是通过专业团队接管底层运维,以显著降低故障停机风险并优化长期IT成本的核心策略,在数字化转型的深水区,企业IT架构的复杂度呈指数级上升,从传统的物理机房到混合云架构,再到微服务容器化部署,运维的边界早已模糊,对于绝大多数非互联网原生企业而言,自建一支全天候、全栈式的运维团……

    2026年7月6日
    16200
  • 大模型训练功耗有多大?大模型训练需要多少电

    大模型训练功耗极大,单模型训练能耗可达数百万千瓦时,相当于数千户家庭一年的用电量,且随着参数规模指数级增长,电力成本已成为制约AI发展的核心瓶颈,大模型训练功耗有多大:从数据中心到芯片的微观视角在讨论大模型训练功耗时,我们往往只看到服务器机房里闪烁的指示灯,却忽略了背后庞大的能源消耗链条,这种消耗并非线性增长……

    2026年6月22日
    2600
  • iis75如何正确绑定泛域名?, iis75泛域名绑定失败怎么办?

    *在IIS7.5中绑定泛域名只需在站点绑定中添加主机名为.example.com,而刷新泛域名CDN缓存则需要根据CDN服务商规则使用URL刷新或目录刷新功能,且需注意泛域名下子域名数量众多,批量刷新常需借助API或脚本,**IIS7.5泛域名绑定教程环境配置与泛解析设置在开始绑定前,你需要确保域名DNS解析已……

    2026年8月6日
    400
  • 服务器安装cuda的详细步骤?,需要注意什么?

    服务器安装CUDA并不复杂,核心在于驱动、Toolkit、系统环境的版本匹配,以及正确的安装顺序,只要按照官方文档的思路,普通运维人员也能在30分钟内完成部署,服务器安装cuda和显卡驱动版本对应关系很多人在服务器上装CUDA第一步就翻车,根源在于没弄清楚驱动与CUDA版本之间的依赖关系,NVIDIA官方明确规……

    2026年7月24日
    600
  • findwindowex找不到句柄怎么办?findwindowex用法详解

    FindWindowEx是Windows API中用于在指定父窗口句柄下查找第一个子窗口或控件的关键函数,它是自动化测试、UI自动化及逆向工程中定位界面元素的底层基石,在Windows桌面应用开发的浩瀚海洋中,句柄(Handle)就像是每个窗口的唯一身份证,当你需要与一个程序交互,无论是提取数据、模拟点击还是修……

    2026年7月8日
    14610
  • 服务器维护解决方案有哪些常见问题,如何解决?

    服务器维护的核心在于预防性维护与及时响应,通过定期巡检、硬件监控、安全更新和灾备演练,能有效降低宕机风险,保障业务连续性,服务器维护费用一般多少?成本构成与预算建议每次聊到服务器维护,大家首先关心的就是资金投入,服务器维护费用一般多少?这不是一个固定数字,但我们可以把账算清楚,服务器维护成本的主要构成硬件维护成……

    2026年7月18日
    1000
  • int数据库和WeLink会议带宽多大合适?,怎么设置?

    分辨率与带宽的对应关系视频质量推荐带宽(上行/下行)适用场景标清(360p)512kbps网络较差时的备用方案,画面勉强可辨高清(720p)1Mbps日常内部会议,满足基本沟通需求全高清(1080p)**2Mbps**重要汇报、演示,人物细节清晰注意,这里的带宽是上行和下行都要达到的值,多数家庭宽带下行快,但上……

    2026年8月3日
    1300
  • AI大模型GTR是什么?GTR与ChatGPT哪个更强大

    AI大模型GTR并非单一软件,而是指代具备高吞吐、低延迟及强逻辑推理能力的下一代生成式AI技术架构,其核心价值在于通过优化上下文窗口与思维链技术,显著提升复杂任务的处理效率与准确性,在2026年的数字生态中,企业和个人对人工智能的需求已从“尝鲜”转向“深度集成”,所谓的GTR(Generation, Trans……

    2026年6月16日
    2800
  • 服务器管理规定包括哪些内容,有哪些注意事项?

    服务器管理规定是保障企业数据安全与业务连续性的核心文件,必须包含权限管理、操作规范、审计追踪等关键要素,这是通过等保测评和日常运维的基础,服务器管理规定模板:如何快速搭建合规体系?你首先需要明确管理规定的适用范围,包括所有服务器资产,无论是物理机、虚拟机还是云主机,一个标准的模板应包含以下章节:总则:目的、依据……

    2026年7月28日
    1400

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注