如何解析深度学习语音识别实践,开发深度学习模型有哪些步骤?

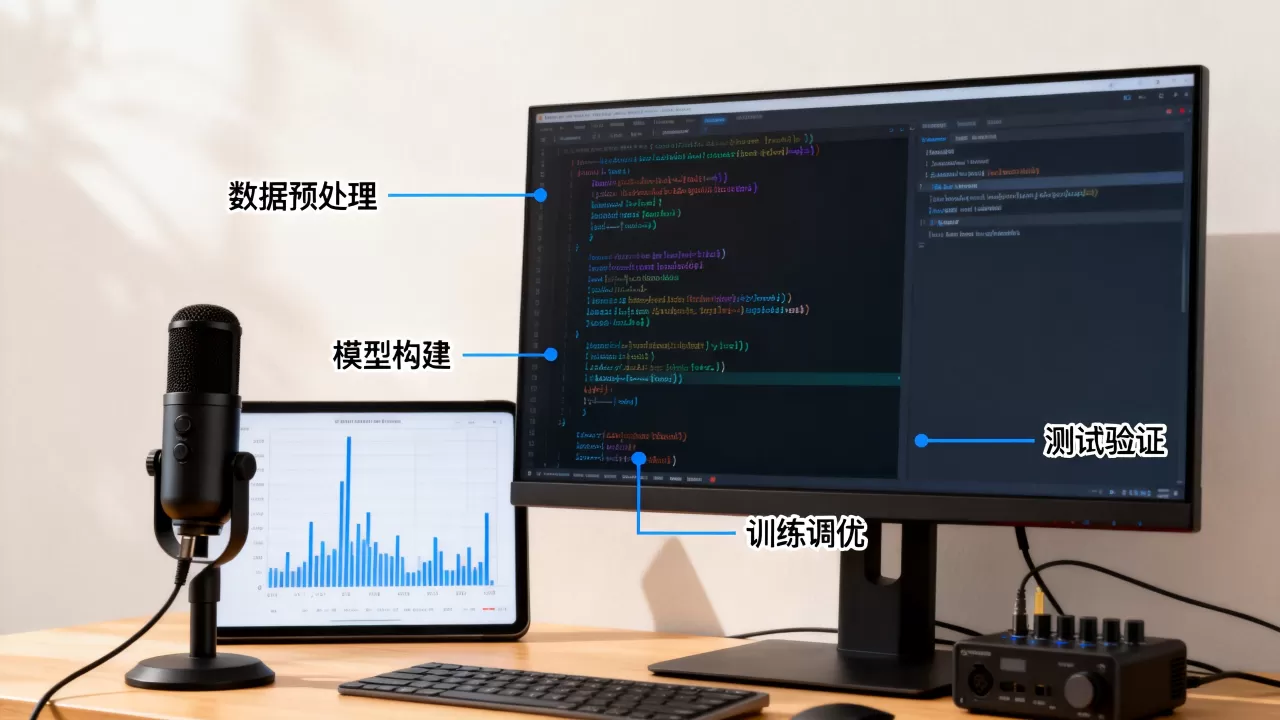
开发一个高效的语音识别深度学习模型,关键在于数据预处理、模型架构选择以及端到端训练策略的合理搭配。

语音识别模型开发实战:数据准备与特征工程

数据是语音识别模型的起点,质量直接决定模型上限,无论你选择哪种架构,数据准备环节都值得投入最多精力。
【研一研二必看】基于PyTorch框架语音识别项目:语音分离,语音转换,语音合成算法原理解析+源码解读+项目实战一口气学爽!深度学习毕设,看完就跑通!
加载中
【研一研二必看】基于PyTorch框架语音识别项目:语音分离,语音转换,语音合成算法原理解析+源码解读+项目实战一口气学爽!深度学习毕设,看完就跑通!

语音数据收集与标注

训练语音模型需要大量带有文本标注的音频数据,公开数据集如LibriSpeech、AISHELL覆盖了英语和中文场景,但实际项目往往需要针对特定场景(如车载环境、电话录音)定制数据。

  • 采集环境多样性:混入不同背景噪声、多距离录制、采样率统一为16kHz(常见标准)。
  • 标注粒度:中文语音标注通常按字对齐,英文按词或音素,标注准确率至少需要95%以上,否则模型会学到错误对应关系。
  • 数据量级参考:专业级模型通常需要数千小时标注数据,小规模项目可从几十小时起步,使用数据增强模拟更多场景。

特征提取实操流程

原始音频波形不适合直接输入神经网络,需要转换为频谱特征,行业共识使用Fbank或MFCC作为主流输入。

  • MFCC:模拟人耳听觉特性,去除了高阶信息,在传统模型中使用广泛。
  • Fbank:保留更多原始频谱细节,深度学习模型更倾向直接使用Fbank或原始波形特征。
  • 工具链:推荐使用Kaldi或Librosa提取特征,参数配置(帧长25ms、帧移10ms)基本固定,无需过度调参。

数据增强的关键作用

多则可能过拟合,少则模型泛化差
如何解析深度学习语音识别实践,开发深度学习模型有哪些步骤?

,数据增强是解决数据瓶颈的有效手段。

  • 速度扰动:将音频变速0.9-1.1倍,模拟不同语速。
  • 噪声叠加:随机混入背景音,如空调声、街景声,提升模型鲁棒性。
  • SpecAugment:对频谱图进行时间/频率掩码,近年来被广泛采用,效果显著。

解析深度学习语音识别实践:模型架构选择

模型架构是语音识别系统的核心,从传统混合模型到端到端方案,选择取决于任务要求和资源约束。

经典RNN与LSTM的局限

早期语音识别依赖RNN或LSTM处理时序依赖。LSTM通过门控机制缓解了长距离遗忘问题,但训练时无法并行,效率较低,在工业级大模型训练中,RNN族逐渐被Transformer取代。

从CTC到Seq2Seq

CTC(联结主义时序分类)允许模型输出与输入长度不对齐,简化了训练过程,但CTC假设帧间条件独立,无法建模上下文依赖。Seq2Seq架构引入注意力机制,让模型在解码时动态关注输入序列的关键部分,显著提升字错误率表现。

  • CTC:适合小模型、实时性要求高的场景,如简单命令词识别。
  • Attention+Transformer:成为主流,尤其在中文大词汇量连续语音识别中,注意力机制能捕捉长距离语音特征。

端到端模型对比表

如何解析深度学习语音识别实践,开发深度学习模型有哪些步骤?

架构类型 优点 缺点 适用场景
RNN+CTC 训练简单,快速部署 对齐能力弱,长句效果差 实时指令识别
Transformer+Attention 全局感知,高准确率 计算量大,需大量数据 通用语音识别
流式Transformer 低延迟,媲美非流式 实现复杂度高 在线语音交互

CNN+RNN混合架构也被广泛使用,CNN提取局部频谱特征,RNN建模时序,兼具效率和效果。

手机端语音识别模型部署实战

移动端模型需要轻量化。量化与剪枝是常用手段:将FP32模型量化为INT8,体积缩小4倍,推理速度提升2-3倍,且精度损失控制在1%以内,工具如TensorFlow Lite、ONNX Runtime支持直接部署。

端到端语音识别模型训练与优化

训练过程涉及多个相互制约的因素,不少开发者会纠结于超参数设置,以下技巧能帮你少走弯路。

学习率调度与优化器

warmup策略被广泛验证有效:前几轮逐渐增加学习率,避免模型训练初期震荡,常用优化器为Adam或Nadam,配合Noam衰减或Cosine衰减,在语音任务中表现稳定。

  • 初始学习率:通常设为1e-4至5e-4,根据模型大小微调。
  • 梯度裁剪:设置阈值为5,防止梯度爆炸,特别是在RNN架构中。

损失函数与评价指标

CTC损失和Attention交叉熵损失是两种主流选择,多任务训练方案同时优化两者,利用CTC加速收敛,Attention提升最终精度,评价指标使用字错误率(CER)或词错误率(WER),行业标准认为CER低于5%可达到商用门槛。

数据增强与正则化

  • SpecAugment:在频谱图上随机掩码,提升对噪声和口音变化的适应能力。
  • 如何解析深度学习语音识别实践,开发深度学习模型有哪些步骤?

  • Dropout:设置在0.2-0.5之间,避免过拟合,特别是在小数据场景下。
  • 多GPU训练:使用Distributed Data Parallel(DDP)可线性加速,但需注意调整batch size,每张卡建议256-512帧,过大反而降低收敛速度。
语音识别模型开发常见问题

语音识别模型开发需要多少训练数据?

数据量取决于场景复杂度,简单命令词任务(如唤醒词)几百小时即可达到较高准确率;通用连续语音识别通常需要数千小时标注数据,如果数据不足,可以先用公开数据集预训练,再通过微调适配特定领域,这是业内专家推荐的低成本方案。

如何选择开源的语音识别框架?

WeNet、Espnet、Kaldi是三个主流选择,WeNet支持流式和非流式统一方案,部署友好;Espnet基于PyTorch,实验灵活性强;Kaldi则适合传统特征工程和混合模型研究,选型时考虑团队技术栈和目标平台,移动端优先WeNet,追求前沿研究选Espnet。

端到端模型与级联模型哪个更优?

端到端模型将声学、语言模型融合,训练更简单,但需要大量数据;级联模型(如WFST结构)依赖语言模型独立优化,在特定领域(如带专有名词的语音识别)中仍占优势。多数情况下,端到端模型在通用场景下效果更好,但级联模型在可解释性和领域定制上仍有不可替代性。

开发语音识别模型没有银弹,从数据、架构到部署,每一步都需要根据实际场景做权衡,理解基本原理,动手实践一个完整流程,比单纯追求最新模型更有价值。

首发原创文章,作者:王坚‌,如若转载,请注明出处:https://test.idctop.com/article/548712.html

赞 (0)
如何实现胶囊模型深度学习,开发模型有哪些方法
上一篇 2026年8月5日 18:05
恐龙岛wqd服务器存龙网怎么充代金券?,充值方法是什么
下一篇 2026年8月5日 18:11

相关推荐

  • 广东广电网络u点家庭服务器红灯亮怎么解决,是什么原因?

    广东广电网络u点家庭服务器亮红灯,通常意味着设备无法正常连接网络或系统出现异常,最直接有效的做法是依次重启光猫和机顶盒、检查物理线路、必要时重置设备,若仍未解决则联系广电客服安排检修,广东广电网络u点家庭服务器红灯怎么办?先看灯的状态面对红灯,先别急着报修,观察一下是闪烁还是常亮,这两种状态指向的问题完全不同……

    2026年8月4日
    3300
  • 香港旅游好去处?香港自由行攻略及热门景点推荐

    2026 年香港作为全球顶级离岸金融中心,其核心价值在于“一国两制”下的法治保障、零资本利得税优势及中西融合的高效营商环境,是跨境资产配置与高端服务业的首选地,2026 香港经济生态与政策红利深度解析政策环境:从“超级联系人”到“全球资产枢纽”的升级2026 年,香港特区政府在“十四五”规划及 2035 远景目……

    2026年5月11日
    6100
  • VMshell双11年付88.88美元值得买吗,VMshell香港CMI线路VPS测评

    VMshell凭借香港CMI原生IP线路和双11年付88.88美元的极致性价比,非常适合对网络延迟敏感且追求稳定性的个人开发者及小型建站用户,但在高并发业务场景下需谨慎评估其资源上限,在VPS(虚拟专用服务器)选择日益内卷的2026年,单纯比拼CPU核心数和内存大小已不再是唯一标准,对于身处国内的用户而言,VM……

    2026年6月20日
    2800
  • js类怎么定义?js类的定义和继承

    关于js类的定义在服务器架构与后端开发的语境中,“JS类”并非指代某一种特定的服务器硬件或云服务套餐,而是指代基于JavaScript(Node.js环境)构建的应用程序逻辑封装方式,许多开发者在选购服务器时,常因对“JS类应用”的资源需求理解偏差,导致性能瓶颈,本文旨在通过深度技术解析,结合2026年最新服务……

    2026年6月13日
    3910
  • mule 开发是什么?mule 开发教程入门指南

    Mule 开发是实现企业级系统集成与数字化转型的最优解,其核心价值在于通过轻量级、可扩展的架构,快速连接异构系统,降低集成成本,提升业务响应速度,企业通过采用 MuleSoft 的 Anypoint Platform,能够构建统一的应用网络,彻底打破数据孤岛,实现业务流程的无缝编排,这种开发模式不仅提高了资产复……

    2026年3月28日
    9900
  • FTP服务器怎么传文件?ftp上传下载大文件教程

    FTP(File Transfer Protocol,文件传输协议)是一种用于在网络上进行文件传输的标准协议,它允许用户将文件从本地计算机上传到远程服务器,或者从远程服务器下载文件到本地计算机,以下是使用 FTP 服务器传送文件的详细步骤,分为准备阶段、使用图形界面工具和使用命令行工具三种方式: 准备阶段在开始……

    2026年7月12日
    7110
  • 服务器ip是什么地址是什么,服务器IP地址在哪里查看

    服务器IP地址本质上是一串用于在互联网中定位特定服务器设备的数字标识,它相当于服务器在网络世界的“门牌号”,确保数据能够准确无误地传输到目标设备,理解这一概念,核心在于认识到它不仅是简单的数字排列,更是网络通信架构中实现寻址与路由的基础逻辑,服务器IP地址的核心定义与功能服务器IP地址(Internet Pro……

    2026年3月29日
    7200
  • 酷番云618服务器低至38元值得买吗,2026年云服务器哪里买最便宜

    腾讯云618年中优惠期间,轻量应用服务器低至38元/年,海外节点199元/年起,且同步发放代金券,这是个人开发者及中小企业降低IT基础设施成本的最佳时机,对于刚起步的创业者、独立开发者或是需要搭建个人博客的技术爱好者来说,服务器成本往往是初期最大的痛点,传统的云服务器配置复杂、计费模式繁琐,往往让预算有限的小团……

    2026年7月8日
    3310
  • 服务器cpu几核和内存怎么配置?服务器cpu核数与内存搭配推荐

    服务器选型中,CPU核数与内存容量的匹配直接决定系统性能上限与运行稳定性,多数企业误以为“核数越多越好”或“内存越大越稳”,实则需结合业务负载特征科学配置,以下为经过生产环境验证的配置逻辑与实操建议,核心原则:业务驱动配置,而非参数堆砌服务器性能瓶颈通常不在CPU主频,而在I/O等待与内存不足,根据IDC 20……

    2026年4月15日
    6400
  • 合肥服务器租用选型先看哪几个参数,哪家好?

    合肥服务器租用选型,核心看CPU、内存、硬盘、带宽和机房,其中CPU和带宽决定了业务响应速度,必须优先确认,明确了业务类型和预算范围后,再对号入座看参数,才不会选错配置,不同场景对软硬件的要求差异很大,比如高并发网站和视频渲染任务,关注点完全不同,下面从最关键的参数开始拆解,合肥服务器租用CPU怎么选?CPU是……

    2026年8月11日
    500

发表回复

您的邮箱地址不会被公开。 必填项已用 * 标注