MapReduce Java API 是 Hadoop 框架中用于编写分布式计算程序的核心接口,你只需实现 Mapper、Reducer 和 Driver 三个部分,即可完成从数据分片到结果汇总的完整流程,这套接口设计简洁,学习曲线平缓,适合绝大多数离线批处理场景。
Java MapReduce 入门教程:核心 API 与组件职责
MapReduce Java API 的类结构非常清晰,你只需要熟悉几个关键抽象类,就能搭建起一个完整的作业,我把它们拆成三个核心角色,方便你逐一理解。
Mapper 接口:如何自定义数据转换逻辑
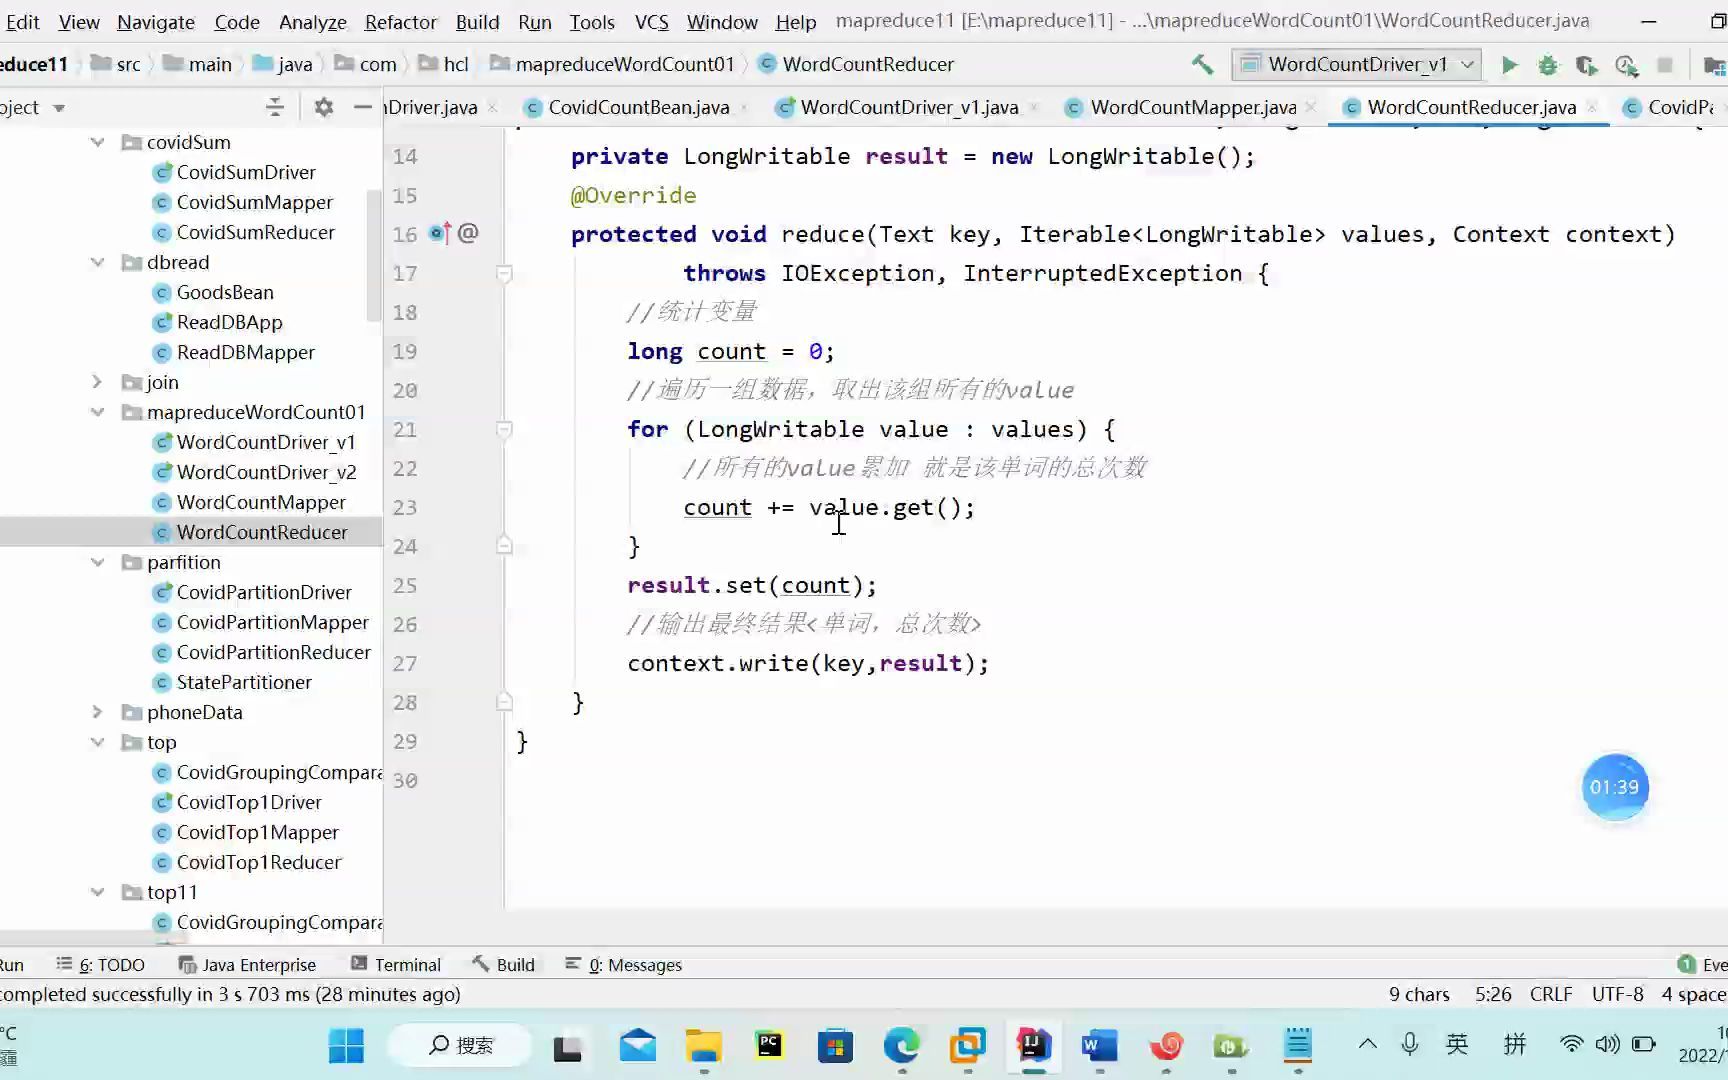
Mapper 是整个作业的“前处理”环节,你需要继承 Mapper<KEYIN, VALUEIN, KEYOUT, VALUEOUT> 类,并重写 map 方法。map 方法接收一个键值对,处理后通过 Context.write 输出零个或多个新键值对。
KEYIN/VALUEIN:输入数据的类型,通常由 InputFormat 决定,文本处理时常用LongWritable(行偏移量)和Text)。KEYOUT/VALUEOUT:输出给 Reducer 的中间数据类型,你需要根据业务设计。
实操中,你需要在 map 方法里写具体的业务逻辑,比如对每一行进行分词、清洗或者过滤。Hadoop 会为每个输入分片自动创建多个 Mapper 实例,因此你无需关心并发细节。
Reducer 接口:如何聚合中间结果
Reducer 负责将 Mapper 输出的相同键值对汇合,你继承 Reducer<KEYIN, VALUEIN, KEYOUT, VALUEOUT>,重写 reduce 方法。reduce 方法接收一个键和该键对应的所有值的迭代器,你可以在其中进行求和、求平均、去重等操作。
- Reducer 的输入类型必须与 Mapper 的输出类型一致。
- Reducer 的数量可以通过
job.setNumReduceTasks()设置,默认是 1,合理设置可以提升吞吐量。
Driver 类:作业配置与提交的入口
Driver 是客户端代码,负责配置 Job 对象,包括指定 Mapper/Reducer 类、输入输出路径、数据类型等,一个典型的 Driver 包含以下步骤:
- 创建
Job实例,通常通过Job.getInstance(conf, "job name")。 - 设置 JAR 包(通过
job.setJarByClass)。 - 指定 Mapper、Reducer、Combiner 等类。
- 设置输入输出格式(常用
TextInputFormat和TextOutputFormat)。 - 设置 Mapper 和 Reducer 输出的键值类型。
- 调用
job.waitForCompletion(true)提交并等待完成。
MapReduce Java API 编程实例:词频统计实战
为了让你快速上手,我以经典的词频统计为例,展示完整的代码结构和关键步骤,这个例子也是多数 Java MapReduce 教程的标配。
环境准备与依赖引入
你需要在 Maven 项目中添加 Hadoop 核心依赖,版本建议与你的 Hadoop 集群一致,2.x 或 3.x。
<dependency>
  <groupId>org.apache.hadoop</groupId>
  <artifactId>hadoop-client</artifactId>
  <version>3.3.6</version>
</dependency>
编写 Mapper 类
public class TokenizerMapper extends Mapper<Object, Text, Text, IntWritable> {
    private final static IntWritable one = new IntWritable(1);
    private Text word = new Text();
    public void map(Object key, Text value, Context context) throws IOException, InterruptedException {
        StringTokenizer itr = new StringTokenizer(value.toString());
        while (itr.hasMoreTokens()) {
            word.set(itr.nextToken());
            context.write(word, one);
        }
    }
}
编写 Reducer 类
public class IntSumReducer extends Reducer<Text, IntWritable, Text, IntWritable> {
    private IntWritable result = new IntWritable();
    public void reduce(Text key, Iterable<IntWritable> values, Context context) throws IOException, InterruptedException {
        int sum = 0;
        for (IntWritable val : values) {
            sum += val.get();
        }
        result.set(sum);
        context.write(key, result);
    }
}
配置 Driver 并运行
public class WordCount {
    public static void main(String[] args) throws Exception {
        Configuration conf = new Configuration();
        Job job = Job.getInstance(conf, "word count");
        job.setJarByClass(WordCount.class);
        job.setMapperClass(TokenizerMapper.class);
        job.setCombinerClass(IntSumReducer.class);
        job.setReducerClass(IntSumReducer.class);
        job.setOutputKeyClass(Text.class);
        job.setOutputValueClass(IntWritable.class);
        FileInputFormat.addInputPath(job, new Path(args[0]));
        FileOutputFormat.setOutputPath(job, new Path(args[1]));
        System.exit(job.waitForCompletion(true) ? 0 : 1);
    }
}
MapReduce Java 接口详解:常见问题与性能优化
当你写完第一个作业后,可能会遇到一些实际场景中的选型或调优问题,下面我从几个常见角度展开。
Java MapReduce 和 Python 接口有什么不同
Python 开发者常使用 Hadoop Streaming 或 Mrjob 库,但 Java API 是原生接口,在性能、类型安全、调试体验上更胜一筹,行业共识认为,对于生产环境中的大规模数据处理,Java 版本能更好地利用 Hadoop 的内部优化机制,比如直接操作字节流、减少序列化开销,如果你已经是 Java 技术栈,直接使用 Java API 是最稳妥的选择。
如何提升 MapReduce 作业性能
- 使用 Combiner:Combiner 是一种“迷你 Reducer”,在 Mapper 端做本地聚合,减少网络传输的数据量,你可以在 Driver 中通过
job.setCombinerClass()指定。 - 合理设置分区与排序:默认的分区器是
HashPartitioner,保证相同键进入同一 Reducer,如果你需要自定义分组,可以实现WritableComparator
并重写
compare方法。 - 控制文件大小:InputFormat 的切片大小会影响 Mapper 数量。通过
mapreduce.input.fileinputformat.split.maxsize和minsize可以调整并发度。
自定义 InputFormat 和 OutputFormat 的场景
当默认的文本格式无法满足需求时(比如读取 JSON、图片、二进制文件),你可以继承 InputFormat 或 FileInputFormat,并实现 RecordReader,同样,OutputFormat 允许你自定义输出格式,例如直接写入 HBase 或分目录存储。多数情况下,Hadoop 预置的格式已经够用,但掌握自定义能力能让你应对更复杂的业务。
MapReduce Java API 的常见疑问解答
Java MapReduce 入门难吗?需要掌握哪些前置知识?
你只需要具备 Java 基础(类、继承、I/O)和 Linux 基本操作即可。Hadoop 会帮你封装分布式细节,你只需关注 Mapper 和 Reducer 中的业务逻辑,业内专家指出,新手从词频统计入手,通常一天内就能跑通第一个作业,建议先本地模式运行,再过渡到集群。
如何调试 MapReduce 作业?
调试分两步:一是本地模式,使用 LocalJobRunner 或 IDE 直接运行,可以打日志;二是集群模式,通过查看 yarn logs 或 JobHistory Server 的日志来定位问题。常见错误包括类型不匹配、路径权限问题、内存溢出,这些都可以通过日志中的堆栈信息快速定位。
在什么场景下应该选择 MapReduce 而不是 Spark?
MapReduce 擅长处理超大规模数据的离线批处理,且对内存要求较低,适合大规模日志清洗、数据 ETL 等场景,而 Spark 更适合需要迭代计算或低延迟的交互式查询。如果你的业务是小时级或天级调度,且现有集群是纯 Hadoop 生态,MapReduce 仍然是稳定可靠的选择。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/547767.html