Spark Java API是替代传统MapReduce进行分布式计算的首选接口,它提供更简洁的编程模型和更高的执行效率,尤其适合迭代计算与实时分析场景。 本文将从接口使用、对比差异到实战案例,帮你快速掌握Spark Java API的核心要点。
Spark Java API接口怎么用?核心API详解
要上手Spark Java API,首先需要理解它的基础组件和常用操作,以下内容基于Apache Spark官方文档,涵盖从初始化到任务执行的完整路径。
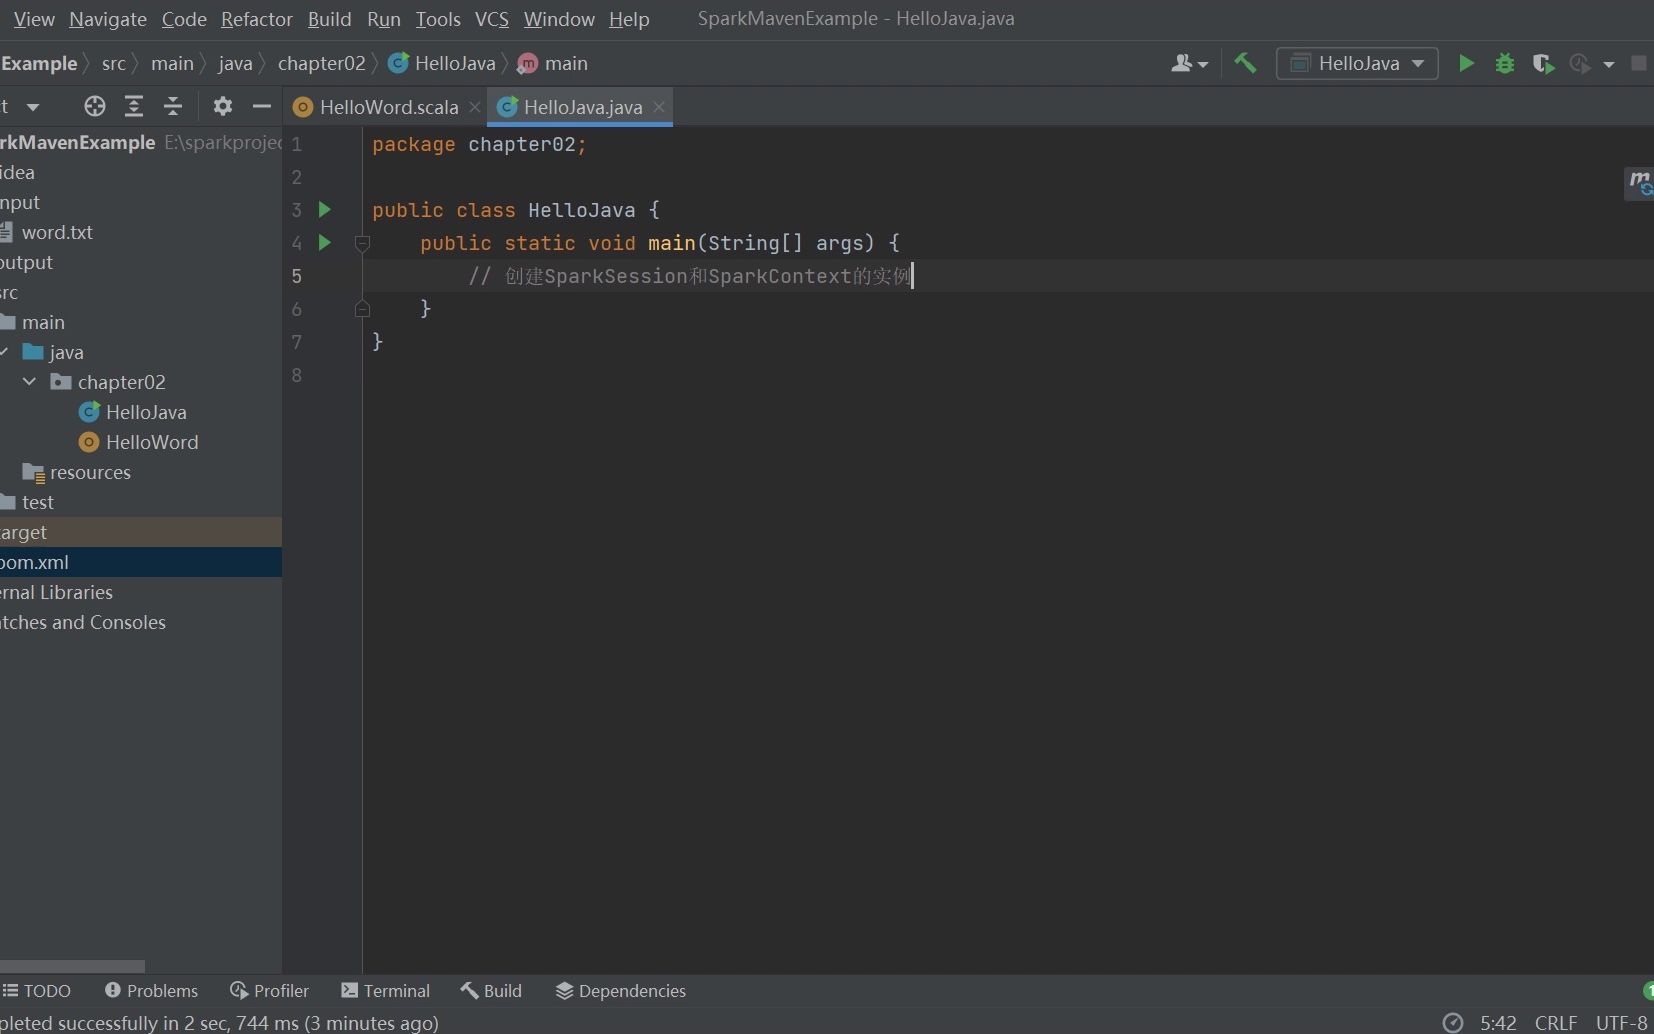

从SparkContext到JavaSparkContext
Spark应用程序的入口是SparkContext,在Java环境中通常使用JavaSparkContext,创建时需指定SparkConf对象,配置应用名称和运行模式。
SparkConf conf = new SparkConf().setAppName("JavaSparkApp").setMaster("local[]");
JavaSparkContext sc = new JavaSparkContext(conf);
setMaster(“local[]”) 表示本地多线程运行,适合开发调试,生产环境通常提交到集群,由Spark-submit指定Master URL。
RDD的创建与转换操作
RDD是Spark的核心数据抽象,Java API通过JavaRDD类操作,创建方式包括从集合创建、读取外部数据源或通过已有RDD转换。
- 从集合创建:
sc.parallelize(Arrays.asList(1, 2, 3, 4, 5)) - 读取文件:
sc.textFile("hdfs://path/to/file") - 转换操作:
map、filter、flatMap、groupByKey、reduceByKey等
转换操作是惰性的,不会立即执行,只有遇到行动操作才会触发实际计算。
行动操作与结果收集
行动操作触发Job执行并返回结果,常见的有:
- collect():将全部数据拉取到Driver端,适用于小数据量
- count():返回元素数量
- reduce():通过聚合函数合并元素
- foreach():对每个元素执行操作
多数情况下,建议使用saveAsTextFile等分布式输出方式,避免collect导致内存溢出。
从RDD到DataFrame的演进
Spark SQL提供了DataFrame API,在Java中通过Dataset<Row>使用,它比RDD更高效,因为内置了Catalyst优化器和Tungsten执行引擎,创建DataFrame的方式包括:
SparkSession spark = SparkSession.builder().appName("JavaSparkSQL").getOrCreate();
Dataset<Row> df = spark.read().json("path/to/file");
对比RDD,DataFrame在多数场景下性能提升较明显,且支持SQL查询,降低开发门槛。
Spark Java API和MapReduce有什么区别?哪个更适合
行业共识认为,Spark Java API在迭代计算和交互式分析场景下显著优于传统MapReduce,以下从多个维度对比。
编程模型对比
| 维度 | Spark Java API | MapReduce |
|---|---|---|
| 计算模型 | DAG(有向无环图) | 两阶段Map-Reduce |
| 中间结果存储 | 内存,必要时落盘 | 磁盘,HDFS |
| 操作类型 | 丰富的转换与行动操作 | 仅Map和Reduce |
| 代码量 | 较少,API简洁 | 较多,需手动实现步骤 |
编程模型上,Spark的DAG引擎能自动优化执行计划,减少Shuffle和数据复写。
性能与效率差距
据统计,在迭代计算(如机器学习算法)中,Spark比MapReduce快数十倍,主要因为内存计算避免了磁盘I/O开销,即使对于单次批处理,Spark的Task调度和缓存机制也通常更高效,但MapReduce在处理超大文件且内存受限时仍有一定稳定性优势。
使用场景选择
- Spark Java API更适合:实时流处理、交互式查询、图计算、需要多次迭代的算法
- MapReduce仍适用:简单批处理、对稳定性要求极高、内存资源有限的环境
若项目已部署Hadoop集群且不想引入额外依赖,MapReduce是稳妥选择;但若追求开发效率和运行速度,Spark Java API是更优方案。
学习成本对比
学习Spark Java API需要理解RDD、DataFrame、Streaming等概念,但API设计更贴近Java开发者习惯,MapReduce概念简单,但编写复杂逻辑时代码量较大。整体来看,Spark Java API的学习曲线略陡峭,但掌握后能大幅提升开发效率。
Spark Java API实战开发教程
理论结合实践才能快速上手,以下通过经典WordCount示例和真实场景演示。
基于Java的WordCount示例
JavaRDD<String> lines = sc.textFile("hdfs://input/words.txt");
JavaRDD<String> words = lines.flatMap(line -> Arrays.asList(line.split(" ")).iterator());
JavaPairRDD<String, Integer> wordCounts = words.mapToPair(word -> new Tuple2<>(word, 1))
                                                .reduceByKey((a, b) -> a + b);
wordCounts.saveAsTextFile("hdfs://output/wordcount");
关键点:flatMap将每行拆分为单词序列,mapToPair创建键值对,reduceByKey按照Key聚合,与MapReduce相比,代码量减少约50%。
在电商推荐系统中的应用
Spark Java API常用于处理用户行为日志,进行实时推荐,计算商品共现矩阵:
JavaRDD<String> events = sc.textFile("hdfs://events/2026/");
JavaPairRDD<String, String> pairRDD = events.mapToPair(line -> {
    String[] parts = line.split(",");
    return new Tuple2<>(parts[0], parts[1]); // userId, itemId
});
JavaRDD<String> coOccurrence = pairRDD.groupByKey()
    .flatMap(tuple -> {
        // 生成商品对
        List<String> results = new ArrayList<>();
        // 具体逻辑省略
        return results.iterator();
    });
在此场景中,Spark的迭代计算能力比MapReduce更高效,多数情况下可达到秒级响应。
性能调优建议
- 合理设置并行度:
spark.default.parallelism根据集群核数调整 - 使用Kryo序列化:比Java默认序列化更快,减少内存占用
- 缓存重用数据:对多次使用的RDD调用
cache()或persist() - 避免过度Shuffle:合并窄依赖操作,减少网络传输
Spark Java API接口介绍:常见问题解答
Q1: Spark Java API接口怎么用?需要哪些包?
答:使用Spark Java API需在项目中引入spark-core、spark-sql等依赖(Maven或Gradle),创建JavaSparkContext或SparkSession作为入口,然后通过JavaRDD或Dataset进行数据操作,具体用法参考上述示例,关键在于理解转换操作和行动操作的区别。
Q2: Spark Java API和MapReduce在性能上差距有多大?
答:在迭代计算场景,Spark的内存计算特性使其比MapReduce快10-100倍;在单次批处理中,差距缩小到2-5倍,但MapReduce在处理超大规模数据时稳定性更好,对内存要求较低,选择哪个取决于业务场景和资源限制,行业共识认为Spark Java API是未来趋势。
Q3: 学习Spark Java API需要什么基础?
答:需要掌握Java基础语法(包括Lambda表达式)、Hadoop分布式文件系统HDFS的基本概念,以及对分布式计算原理有一定了解,如果熟悉MapReduce,学习Spark Java API会更快,因为两者在哲学上同源,但Spark抽象层次更高,需要转变思维习惯。
最终结论:Spark Java API凭借其简洁的接口、高效的内存计算和丰富的生态,已成为现代大数据开发的主流选择,无论是从零开始还是从MapReduce迁移,掌握它都能显著提升你的分布式编程能力。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/546475.html