分布式缓存不是银弹,但选对方案能解决90%的性能瓶颈,核心结论:根据业务场景、数据一致性和预算,在Redis、Memcached、Tair等中做选择,兼顾读写性能与成本,才能真正发挥缓存价值。
分布式缓存和本地缓存对比:选型前的必知差异
很多团队在初期会纠结用本地缓存还是分布式缓存,这背后是隔离性与共享性的权衡,本地缓存(如Caffeine、Guava Cache)驻留在应用进程内,读写速度极快,但无法跨实例共享数据,分布式缓存则独立部署,所有应用节点共享同一份缓存数据,适合需要全局一致性的场景。
缓存位置与数据共享
本地缓存的数据存储在单个JVM或进程的内存中,应用重启或扩容时缓存会丢失,且不同实例之间数据互不可见,分布式缓存通过一致性哈希分片,将数据分布在多个节点上,客户端通过API透明访问。当系统有多个微服务实例且需要共享用户会话、商品库存这类全局数据时,分布式缓存是唯一的选择。
一致性保证与扩展性
本地缓存不存在网络开销,延迟极低,但无法保证多实例间的数据一致性,分布式缓存虽然引入网络延迟(通常毫秒级),但通过主从复制、哨兵或集群模式,能提供高可用和最终一致性。扩展性方面,本地缓存受限于单机内存,而分布式缓存可以横向扩展至数百节点,承载TB级数据。
性能与成本权衡
本地缓存查询延迟通常在微秒级,分布式缓存则在1-5毫秒左右,对于单次请求,本地缓存更快,但一旦涉及跨实例数据同步或失效广播,复杂度反而上升。多数情况下,业务中会用本地缓存做一级缓存,分布式缓存做二级缓存,兼顾速度与共享。
分布式缓存选型指南:三大主流方案深度解析
行业共识认为,Redis、Memcached和云原生缓存是目前最主流的选项,选型时需关注功能特性、数据持久化、集群管理方式以及社区活跃度。
Redis:功能全面但需注意内存开销
Redis支持丰富的数据结构(字符串、哈希、列表、有序集合、HyperLogLog等),并内置了持久化、主从复制、哨兵和集群模式。对于需要复杂数据结构(如排行榜、计数器、分布式锁)的场景,Redis是首选。 但Redis将所有数据存储在内存中,内存成本较高,且某些操作(如大Key删除)可能阻塞主线程,业内专家指出,使用Redis时应避免存储过大的Value,并合理设置淘汰策略(如LRU、LFU)。
Memcached:简单高性能,适合纯KV
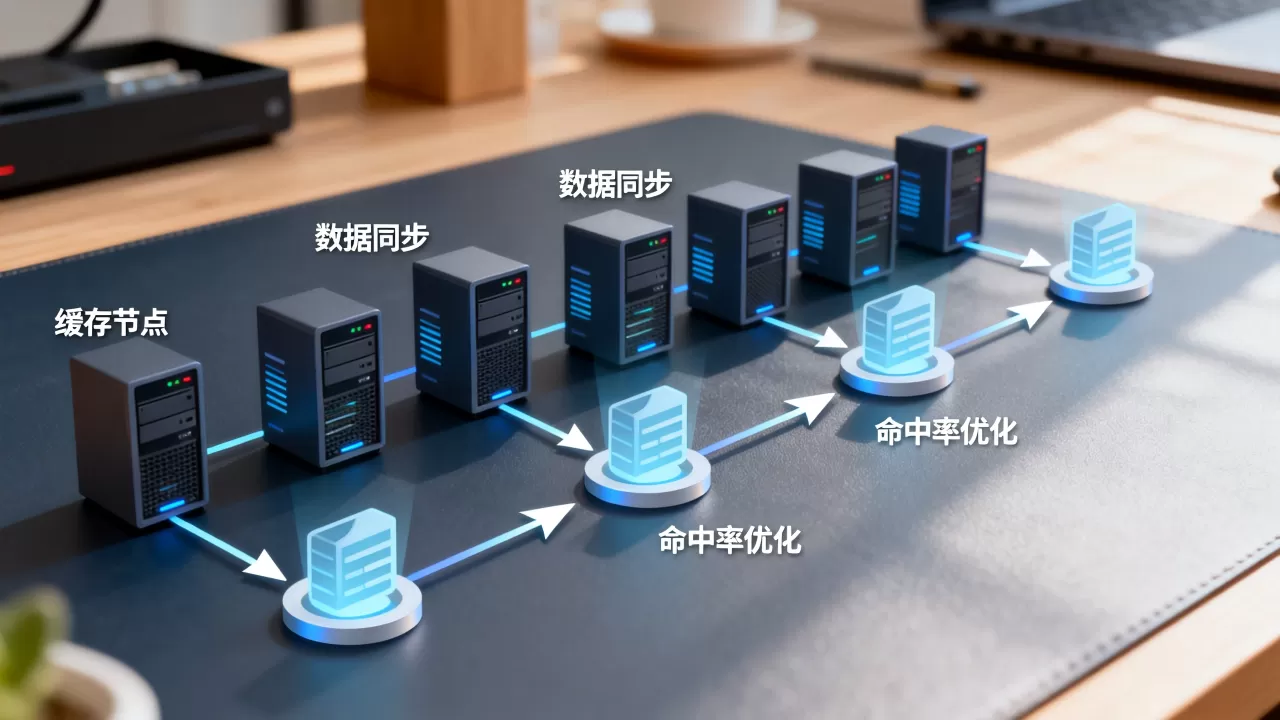
Memcached只支持简单的字符串键值对,但内存管理更高效,无持久化,无复制,集群依赖客户端哈希。当业务只要求纯缓存加速,且数据允许丢失时,Memcached的吞吐量能超过Redis。 不过Memcached不支持数据持久化,重启后缓存全失,且无法实现消息队列、发布订阅等高级功能,近年来,随着Redis性能的持续优化,Memcached的份额有所下降,但在一些高吞吐、低延迟的纯缓存场景中依然是性价比之选。
Tair及其他云原生方案
各大云厂商均推出了托管的分布式缓存服务,如简米云的Tair、AWS的ElastiCache、Azure的Redis Cache。这些服务内置了高可用、自动故障迁移、监控告警,且提供了Redis兼容的接口,运维成本大幅降低。 对于预算有限且缺乏专业运维团队的团队,云原生缓存省去了集群搭建和调优的麻烦,但需要注意数据迁移和供应商锁定问题。
分布式缓存场景实战:从架构设计到代码落地
选型只是第一步,真正考验架构能力的是如何在具体业务中用好缓存,以下三个典型场景几乎覆盖了绝大部分缓存需求。
电商秒杀:缓存热key的应对
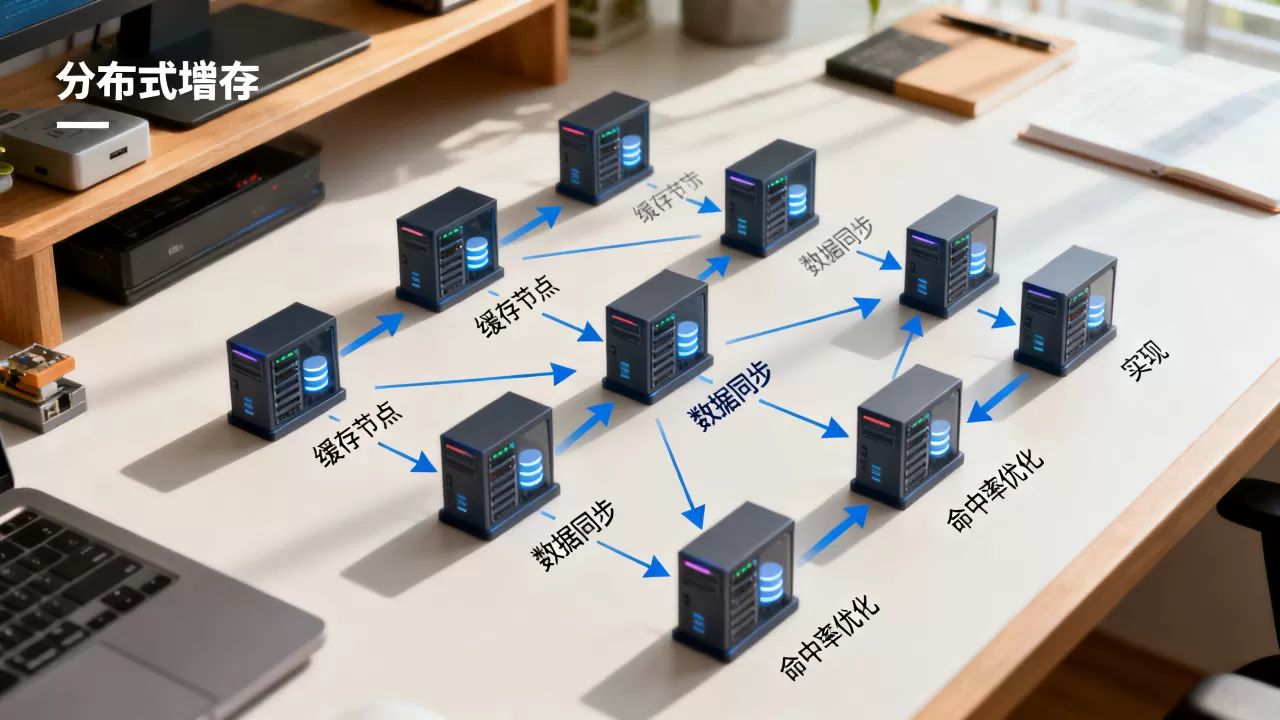
秒杀时,大量请求集中在少数商品上,形成热Key,如果直接访问分布式缓存,可能直接打爆缓存节点。常见的做法是本地缓存+分布式缓存两级架构:在应用层对热Key进行本地缓存,并设置较短的过期时间,同时用分布式缓存做降级容错。 实操中,还可以将热Key备份到多个副本,分散读取压力,对于写操作,直接更新分布式缓存,并异步同步到数据库。
社交Feed:缓存穿透与雪崩的预防
社交Feed的访问特征是不规律,大量用户可能同时刷新首页,如果缓存未命中,流量会直接穿透到数据库。预防缓存穿透的有效方法是使用布隆过滤器,在查询缓存前先判断Key是否存在。 对于缓存雪崩,行业共识是设置缓存过期时间时加上随机偏移量,避免大量Key同时失效,使用多级缓存(如本地缓存+分布式缓存)也能提升系统韧性。
实时排行榜:有序集合的应用
Redis的有序集合天然适合排行榜场景,用ZADD命令即可动态更新分数,ZREVRANGE快速获取排名。但在数据量极大时,单个有序集合可能成为瓶颈,需要按时间或类别分片。 将全局排行榜分为多个小时段,每个段独立排序,再通过归并算法得到最终排名,这种分段设计也降低了单Key的内存压力。
分布式缓存价格与成本考量:如何不花冤枉钱
缓存成本包括硬件、运维和云服务费用。分布式缓存的价格因内存大小、网络带宽、集群规模而异,盲目配置很容易超支。
自建集群 vs 云服务
自建Redis集群需要购买服务器,内存成本按服务器价格计算,同时需要投入运维人力。一个8核32G的Redis实例,单机年成本约几千元,但集群规模达到10台以上时,运维复杂度指数级上升。 云服务按实例规格和存储空间计费,预付费实例通常比按量付费便宜30%-50%。对于中小团队,云服务是更省心的选择,可以按需扩容,避免前期硬件投入过大。
运维成本与硬件开销
分布式缓存对内存和网络要求较高,需要配置持久化、备份、监控。自建时,内存需预留20%-30%用于操作系统和内存碎片,否则容易OOM。 云服务则提供了自动备份和跨可用区部署,容灾能力更强,但跨地域的缓存同步会带来额外的延迟和费用。如果业务对延迟极度敏感,最好将缓存部署在同一个地域,避免跨机房通信。
分布式缓存部署实操:常见问题与解决方案
即使选对了方案,部署中仍会遇到经典问题,以下操作步骤和配置建议经过大量生产验证。
缓存穿透、击穿、雪崩的应对
- 缓存穿透:查询一个不存在的数据,绕过缓存直击数据库,解决方案:缓存空对象,并设置短过期时间;或使用布隆过滤器,在应用层拦截非法Key。
- 缓存击穿:一个热Key在失效瞬间,大量并发请求涌入,解决方案:使用互斥锁,仅允许一个线程重建缓存,其他线程等待;或设置热Key永不过期,通过后台异步更新。
- 缓存雪崩:大量缓存同时失效,导致数据库压力激增,解决方案:为每个Key的过期时间增加随机值(如基础时间+0-5分钟随机数);做好缓存预热,避免冷启动。
数据一致性策略
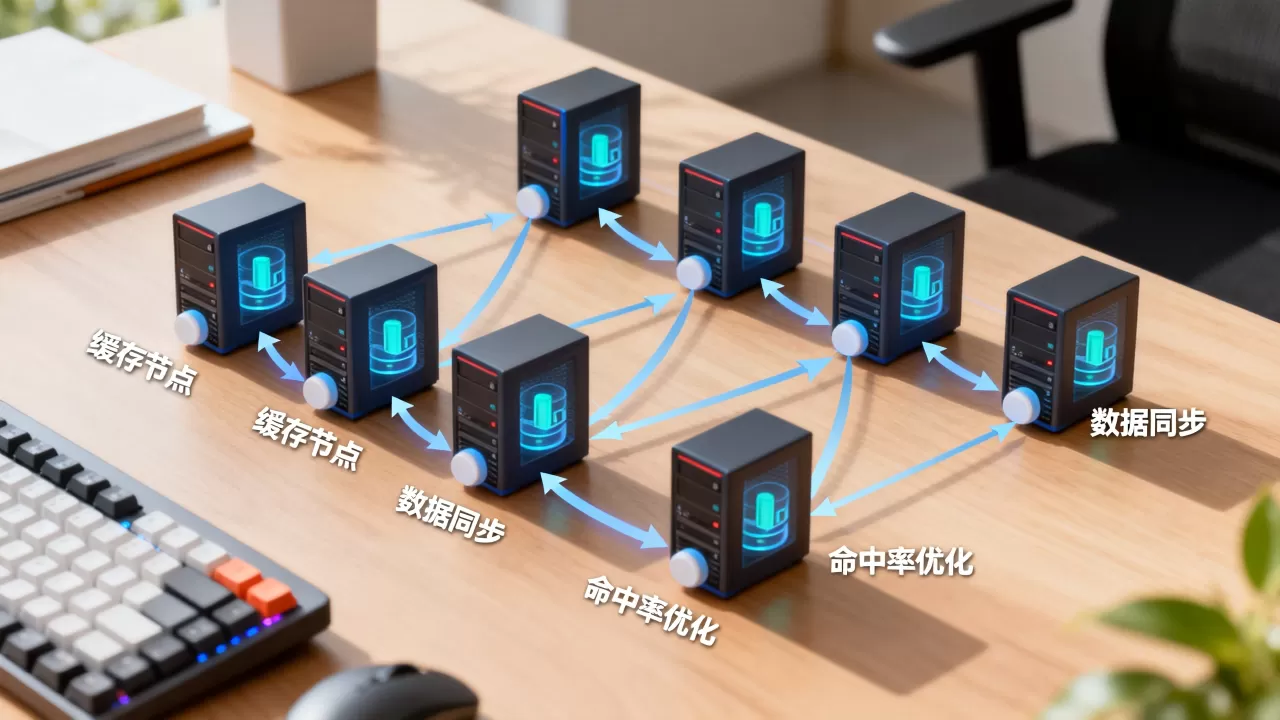
缓存与数据库之间的一致性是分布式系统经典难题。业界普遍采用“先更新数据库,再删除缓存”的策略,利用缓存的最终一致性。 如果业务要求强一致性,可使用分布式事务或Binlog监听同步缓存,但会牺牲部分性能。对于大多数场景,设置合理的过期时间(如5-10分钟),配合缓存失效后的回源更新,就能满足业务需求。
分布式缓存不是简单的“加一层缓存”就能解决所有问题,它需要结合业务特征、一致性要求和成本预算进行综合设计。选对方案、做好热点防护、规划好数据一致性策略,才能让缓存真正成为系统加速的引擎,而非故障的源头。
分布式缓存常见问题与解答
问题1:分布式缓存怎么保证数据一致性?
分布式缓存一般通过缓存更新策略来保证最终一致性,最常用的做法是“先更新数据库,再删除缓存”,下次查询时重新加载数据库内容,如果要求强一致性,可以采用分布式锁或数据库Binlog同步更新缓存,但会带来额外的延迟和复杂度。对于大多数业务,最终一致性结合合理的过期时间就足够。
问题2:分布式缓存和本地缓存可以一起用吗?
可以,这被称为多级缓存,通常将本地缓存作为一级缓存,分布式缓存作为二级缓存,查询时先查本地缓存,命中直接返回;未命中再查分布式缓存,并回填本地缓存。这种设计利用本地缓存的超低延迟,同时借助分布式缓存实现数据共享,适用于读多写少的场景,但需注意本地缓存的一致性问题,建议设置较短的过期时间。
问题3:分布式缓存价格一般是多少?
价格取决于内存规格、节点数量和部署方式,自建Redis集群,一台8核32G的云服务器年费约3000-5000元,但集群规模越大,运维成本越高,云托管服务按实例规格计费,例如简米云Redis 4GB实例月费约200-300元,16GB实例约800-1200元,预付费有折扣。Memcached云服务价格通常比Redis略低,但功能也更有限。 实际成本还需考虑带宽和存储费用,建议根据业务峰值预估内存用量,避免过度配置。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/543118.html