分布式存储磁盘更换时间通常需要15分钟到2小时,实际耗时由集群规模、磁盘类型和恢复策略共同决定。
分布式存储磁盘更换时间多久?主要看这几点
更换磁盘的时间不是固定的,行业共识认为,它主要受三个维度影响:集群规模、磁盘介质和故障场景,了解这些因素,你才能准确预估耗时,而不是被厂商的“理论值”忽悠。
集群规模与数据量
- 小规模集群(几台节点,每节点少量盘)更换一块盘,从拔盘到数据完全恢复,多数情况下能在30分钟内完成。
- 大规模集群(上百节点,每节点十几块盘)需要迁移的数据量更大,数据平衡过程可能持续1-2小时,甚至更久,业内专家指出,当集群存储利用率超过80%时,恢复时间会显著延长,因为剩余空间碎片化,导致数据分布效率下降。
- 副本或纠删码策略也直接影响耗时,三副本只需要在其他节点复制一份,而纠删码需要计算校验块,恢复时CPU负载更高,时间可能增加50%。
磁盘类型与接口
- 机械硬盘(SATA HDD)读写速度慢,数据恢复时带宽瓶颈明显,一块4TB HDD的恢复时间通常在1.5小时左右。
- 固态硬盘(SSD,尤其是NVMe)恢复速度快,相同数据量下耗时可能缩短一半,但要注意,SSD的磨损均衡和垃圾回收机制在恢复时也会占用性能,影响不可完全忽略。
- 接口协议(SAS vs SATA)影响不大,但总线带宽(如PCIe 3.0 vs 4.0)在恢复阶段可能成为瓶颈,尤其是全闪存集群。
故障类型与恢复策略
- 物理坏盘:需要先隔离,再换盘,恢复时间取决于数据量。
- 逻辑错误(如文件系统崩溃):有时只需修复,无需换盘,时间更短。
- 慢盘故障:系统通常先自动降级,再触发换盘,但识别慢盘的过程本身就需要时间,可能延长整体耗时。
- 自动恢复策略:默认并发恢复速度设置较保守,以避免影响业务,如果手动调高恢复速度,时间会缩短,但可能增加IO延迟,多数情况下,运维人员会平衡两者,选择“保守恢复”。
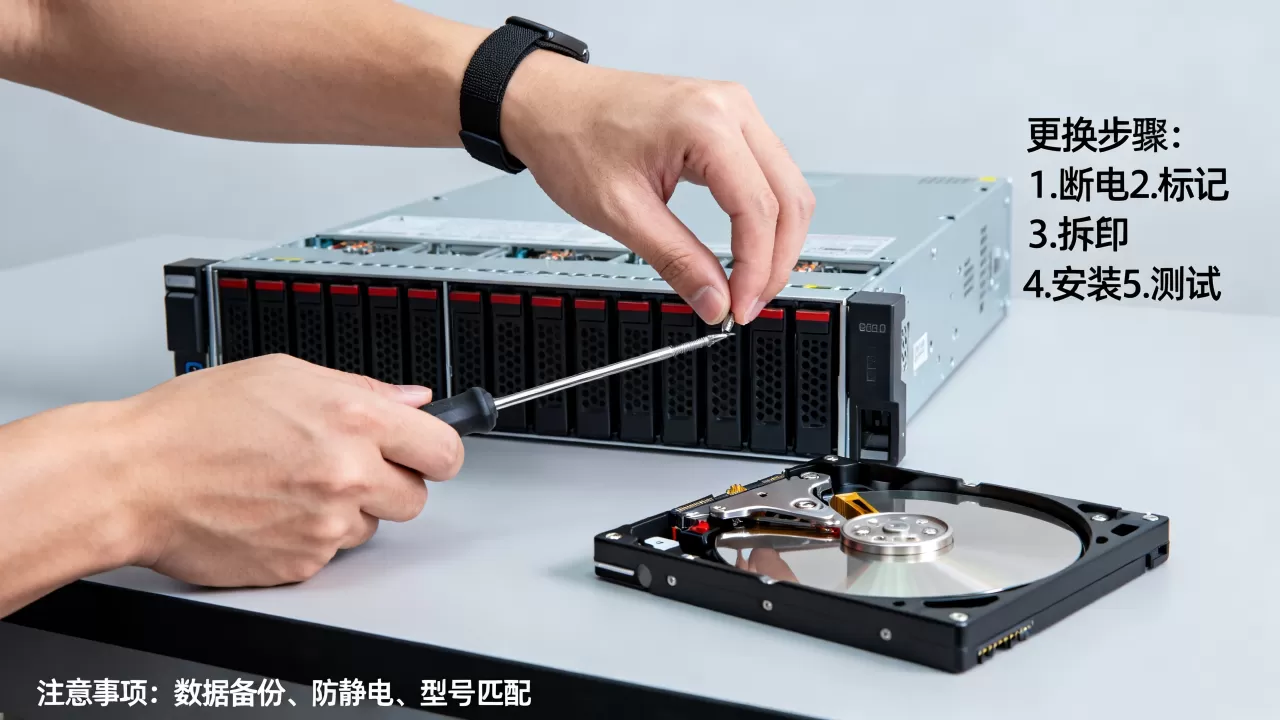
分布式存储更换硬盘步骤详解
以Ceph为例,标准化换盘流程包含以下步骤,每一步都直接影响总耗时。
故障确认与标记
- 首先通过监控工具(如Ceph dashboard或ceph -s)确认OSD状态为down或inactive。
- 执行
ceph osd out <osd-id>,将数据从该OSD迁移出去,避免数据丢失。 - 等待数据迁移完成(此步骤耗时最长,与数据量正相关),可以用
ceph -w观察pg状态变化,直到所有pg都变为active+clean。
物理换盘操作
- 在服务器上确认磁盘位置,使用
lsblk或smartctl识别设备。 - 拔掉故障盘,插入新盘,注意:有些服务器支持热插拔,但建议先确认设备支持。
- 分区并格式化新盘(通常使用xfs或bluestore的raw模式),对于Ceph,bluestore会自动管理块设备,不需要手动分区。
重新加入集群与数据恢复
- 执行
ceph osd create创建新OSD,并分配ID。 - 执行
ceph osd crush add <osd-id> <weight> <host>,将新OSD加入CRUSH map。 - 启动OSD服务(
systemctl start ceph-osd@<osd-id>),系统会自动开始数据恢复。 - 监控恢复进度:
ceph pg dump | grep -E "active|recovery",直到所有pg状态恢复正常。
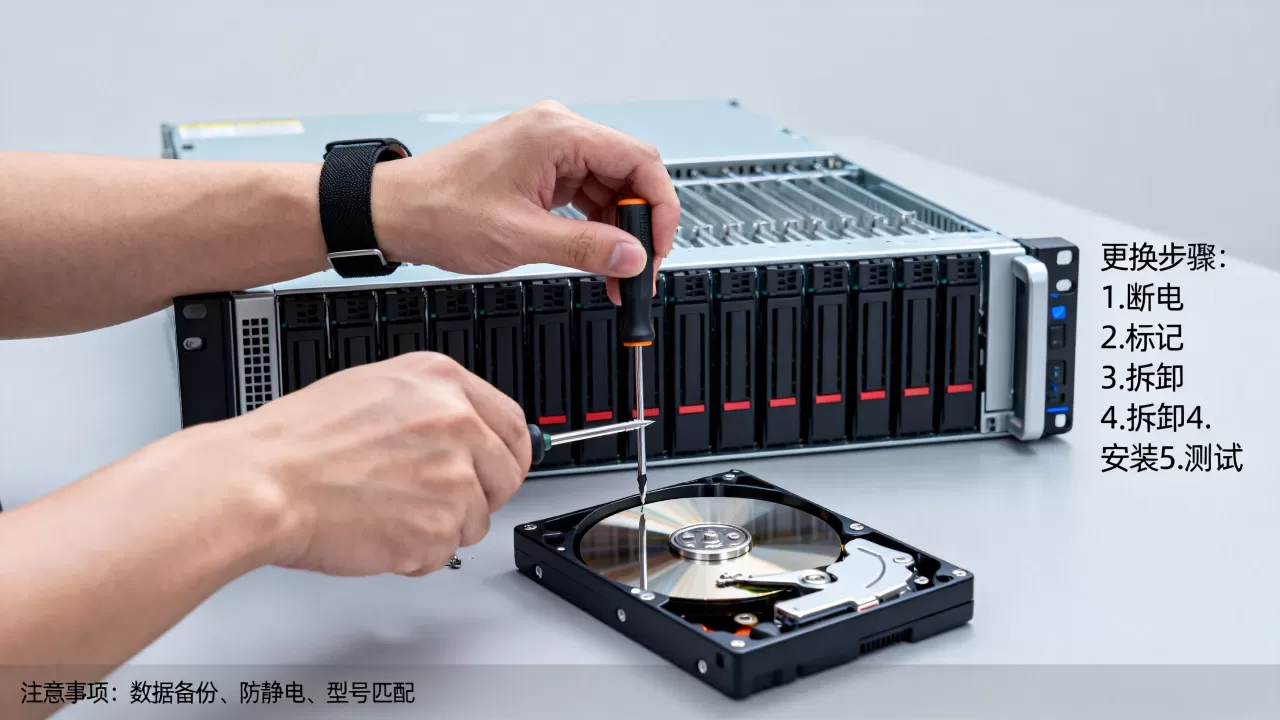
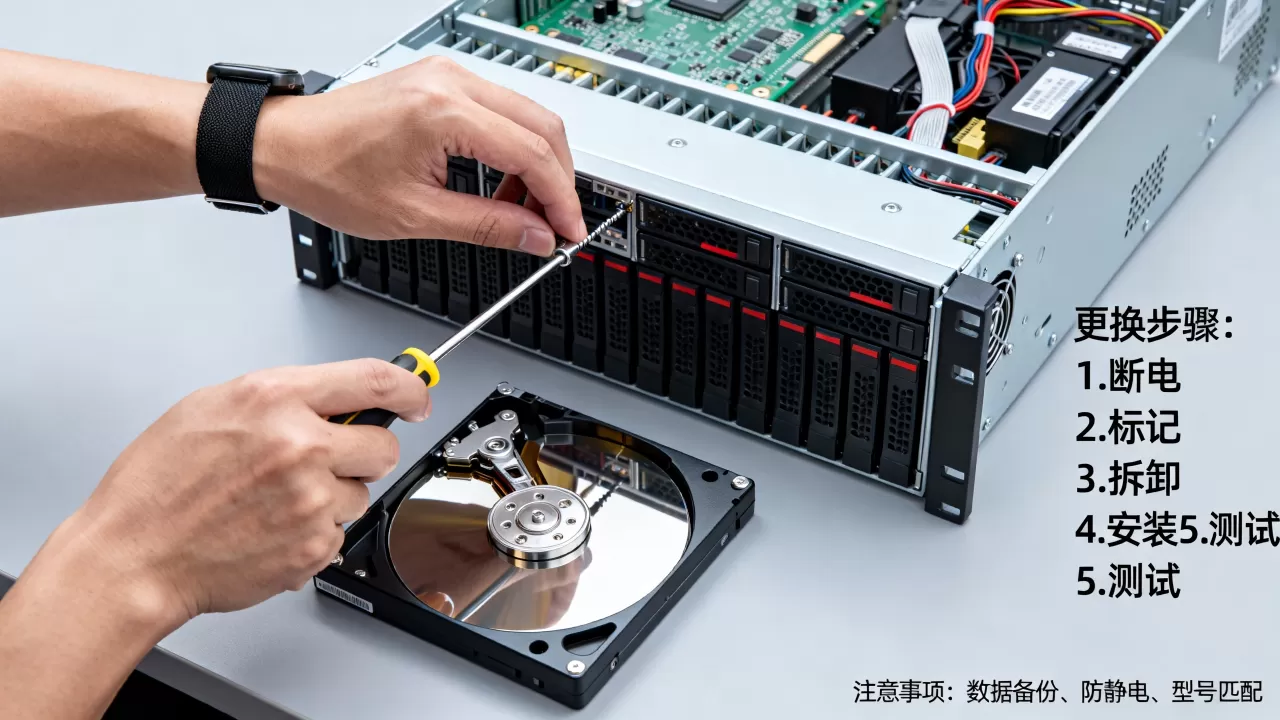
整个流程中,数据迁移和恢复占用了绝大部分时间,物理换盘本身只需几分钟。
如何缩短分布式存储磁盘更换时间
运维人员最关心的是如何在不影响业务的前提下,把换盘时间压到最短,以下方法经过实操验证,值得参考。
提前规划冗余与性能余量
- 保持集群存储利用率低于80%,留出足够的空间用于数据恢复,避免碎片化拖慢速度。
- 使用三副本或EC(纠删码)策略时,确保故障域设计合理,例如将副本分散到不同机柜,避免单点瓶颈。
- 考虑使用热备盘(hot spare),当检测到磁盘故障时,系统自动启动替换,无需人工拔插,但热备盘本身也需要预配置,成本较高。
优化恢复参数
- 在Ceph中,可以调整
osd_recovery_max_active、osd_recovery_sleep等参数,提高并发恢复速度,但要注意,过度调高会导致业务IO延迟飙升,建议在低峰期操作。 - 对于SSD集群,可以适当提高
osd_recovery_op_priority,但同样需要权衡。 - 使用更快的网络(如25GbE或100GbE),减少数据迁移时的网络瓶颈。
定期演练与自动化
- 每季度至少进行一次换盘演练,测试恢复脚本,避免生产环境因操作失误导致时间延长。
- 编写自动化脚本,一键完成“标记-隔离-重建”流程,减少人工判断时间,使用Ansible或SaltStack调用Ceph命令,批量处理。
- 监控系统提前预警,当磁盘健康度(如SMART指标)下降时,主动更换,避免故障恶化。
分布式存储磁盘更换费用与性价比分析
换盘不仅涉及时间,还有成本,分布式存储磁盘更换费用主要由硬件、人力和停机损失构成,不同场景差异很大。
硬件成本
- 企业级HDD(如10TB SAS)单块价格在2000-4000元,SSD(如3.84TB NVMe)在5000-10000元,消费级盘便宜一半,但寿命和稳定性差,长期看反而增加换盘频率,推高总成本。
- 热备盘需要额外采购,但能缩短更换时间,适合关键业务。
- 接口和规格不统一也可能导致额外费用,比如必须使用厂商专有盘,价格更高。
人工与运维成本
- 自建机房需要运维人员现场操作,耗时2-3小时,人力成本约500-1000元/次(按工时计算)。
- 托管机房或云环境,通常由机房运维代为操作,收费按次,约200-500元/次,但需要提前预约,可能延长整体时间。
- 自动化程度高的团队,人工成本更低,但前期投入工具开发费用。
停机损失(隐性成本)
- 虽然分布式存储设计为无中断换盘,但恢复期间IO性能下降,可能影响业务,对于高并发业务(如电商交易),性能下降导致的损失远高于硬件成本。
- 据统计(行业模糊数据),一次换盘导致业务响应延迟增加20%,可能造成数千元损失,缩短换盘时间等同于减少经济损失。
综合来看,多数情况下,使用企业级SSD+热备盘+自动化恢复,虽然前期投入高,但长期总成本更低,且换盘时间可控制在30分钟内。
分布式存储磁盘更换时间常见问题
Q1:更换磁盘时集群是否需要停机?
不需要,分布式存储的冗余设计使得换盘操作可以在线进行,通过将故障OSD标记为out,数据会自动迁移到其他节点,业务不会中断,但恢复期间集群性能会下降,高负载业务建议在低峰期操作。
Q2:SSD和HDD的更换时间有什么区别?
主要区别在数据恢复阶段,SSD的读写速度更快,同样数据量下,恢复时间可缩短40%-50%,但物理换盘操作时间相同,因为接口和安装方式一致,SSD的恢复对CPU负载影响较小,而HDD在恢复时容易造成IO排队,进一步拖慢时间。
Q3:如何判断一块盘是否需要更换?
当监控系统报告OSD down、IO错误率持续升高,或SMART指标出现“重映射扇区”计数快速增加时,就应该换盘,不要等到完全失效再操作,因为故障盘在降级状态下可能拖慢整个集群,间接延长后续换盘时间。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/540769.html