分析型数据库连接的核心在于正确选择驱动、配置连接参数、管理连接池,并针对分析型负载优化查询效率。 很多人以为连上就行,结果跑个复杂聚合查询直接超时,或者连接数一多就崩,下面从连接方式、常见故障、性能调优到工具选择,把整个流程拆开揉碎。
理解分析型数据库的连接特性
分析型数据库(如 ClickHouse、Apache Doris、Greenplum)与事务型数据库的工作负载完全不同,它们追求的是海量数据下的高吞吐查询,而非单条记录的高速写入,这种差异直接体现在连接行为上:连接往往需要维持较长时间,且一次查询可能返回大量结果集。
分析型数据库连接方法有哪些
- JDBC / ODBC 驱动:最通用的方式,适用于 Java、Python、C++ 等语言,驱动版本必须与数据库版本匹配,否则容易出现协议错误。
- HTTP 接口:许多分析型数据库提供 REST API,适合无状态应用或轻量查询,ClickHouse 的 HTTP 接口可直接用 curl 访问。
- 原生客户端:数据库厂商提供的命令行工具,用于调试和运维,连接参数通常需要指定主机、端口、用户名、密码以及数据库名称。
- 连接池中间件:如 HikariCP、Druid,负责管理连接生命周期,避免频繁创建销毁。
连接池的核心作用
分析型查询通常比事务型耗时更长,如果每次查询都新建连接,TCP 握手和认证开销占比会非常高,连接池提前创建固定数量的连接,查询时复用,能显著降低延迟,行业共识认为,连接池大小设置为 10–50 之间就能覆盖大部分场景,过大反而导致数据库调度压力。
分析型数据库连接失败怎么办
连接失败是新手最常见的困扰,错误信息往往含糊,但排查逻辑是固定的。
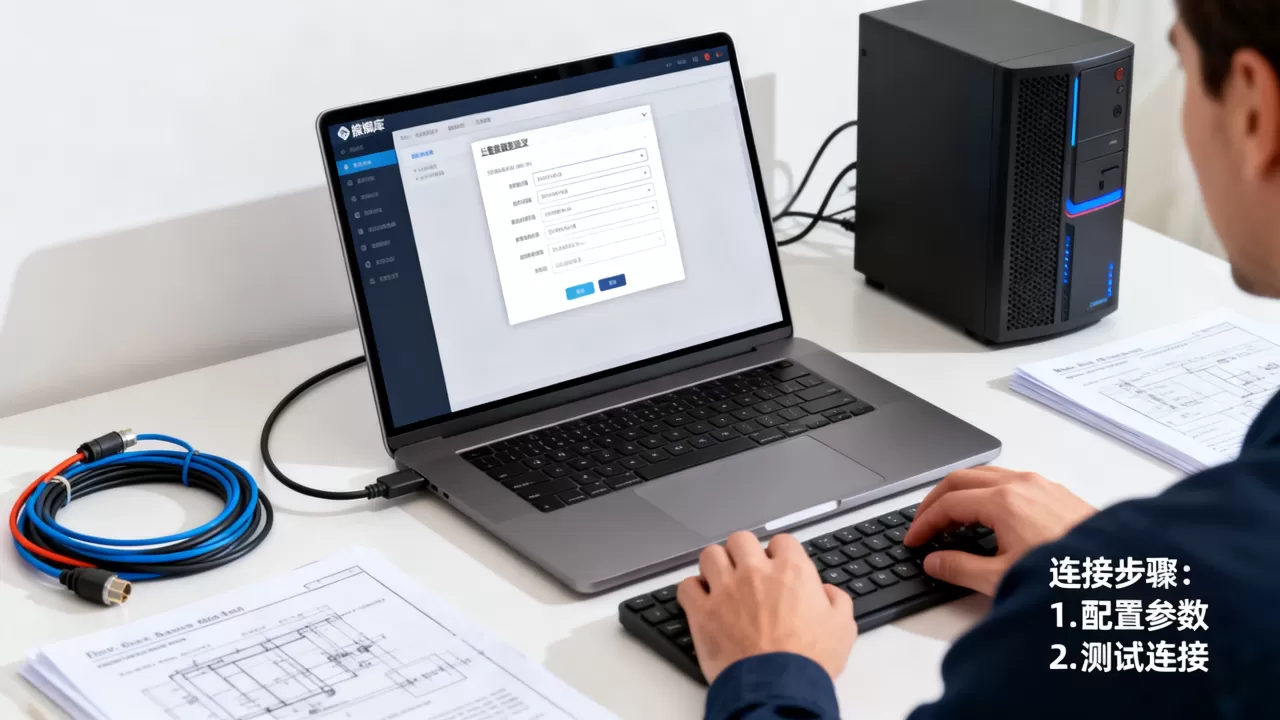
按以下清单逐步确认,多数问题三分钟内定位。
常见错误码与排查思路
- Connection refused:端口未开放或服务未启动,检查防火墙和数据库监听地址是否绑定在 0.0.0.0。
- Authentication failed:用户名或密码错误,或该用户未被允许从当前 IP 访问,在分析型数据库中,通常需要单独授权 IP 段。
- Socket timeout:网络延迟高或数据库负载过大,先 ping 测试网络,再检查数据库的 max_concurrent_queries 参数。
- Protocol error:驱动版本与数据库不兼容,升级驱动或查看官方文档的版本矩阵。
网络与权限检查清单
- 在应用服务器上执行
telnet <host> <port>确认端口可达 - 确认数据库用户已授予远程访问权限(MySQL 的
'user'@'%',ClickHouse 的from_ip设置) - 检查安全组或 iptables 规则是否放行对应端口
- 查看数据库的日志文件,通常在
/var/log/下,会给出具体拒绝原因
分析型数据库连接池设置与性能调优
连接池参数不是照搬事务型数据库的配置就能用。分析型查询的响应时间更慢,连接池更容易达到上限,导致请求排队。 需要针对查询特点做调整。
连接池参数配置建议
- 最大连接数:不是越大越好,分析型数据库的并发能力由 CPU 和内存决定,通常设置为应用线程数的 1/2 到 2/3,32 个线程池,连接池设 16–20。
- 连接超时:建议设为 30–60 秒,分析型查询可能运行较久,超时太短会误杀正常查询。
- 空闲回收时间:设为 5–10 分钟,驱动与数据库之间存在心跳机制,频繁回收反而增加开销。
- 测试查询:使用
SELECT 1或SELECT version()验证连接有效性,分析型数据库对这类轻量查询支持良好。
针对分析型查询的优化策略
- 使用批量查询:将多个小查询合并成一次 SQL 或使用
UNION ALL,减少连接周转次数。 - 避免频繁断开:分析型数据库建立连接成本高,建议在业务低谷期统一回收,而不是每次查询后立即关闭。
- 连接池预热:系统启动时主动执行一次查询,让连接池进入稳定状态,避免首次查询因连接建立而延迟。
- 监控连接池状态:记录活跃连接数、等待队列长度、连接创建频率,如果等待队列经常堆积,说明最大连接数不够或查询效率低。
分析型数据库连接工具选择
不同场景适合不同的连接方式。工具选错了,不仅影响开发效率,还可能引入性能瓶颈。
不同场景下的工具对比
| 场景 | 推荐工具 | 理由 |
|---|---|---|
| Java 微服务 | HikariCP + JDBC | 轻量、速度快,支持异步获取连接 |
| 数据中台批量查询 | 数据库原生连接池(如 ClickHouse JDBC) | 便于管理长连接,支持复杂 SQL 转义 |
| 临时分析脚本 | HTTP 接口 + requests | 无需引入驱动,快速验证数据 |
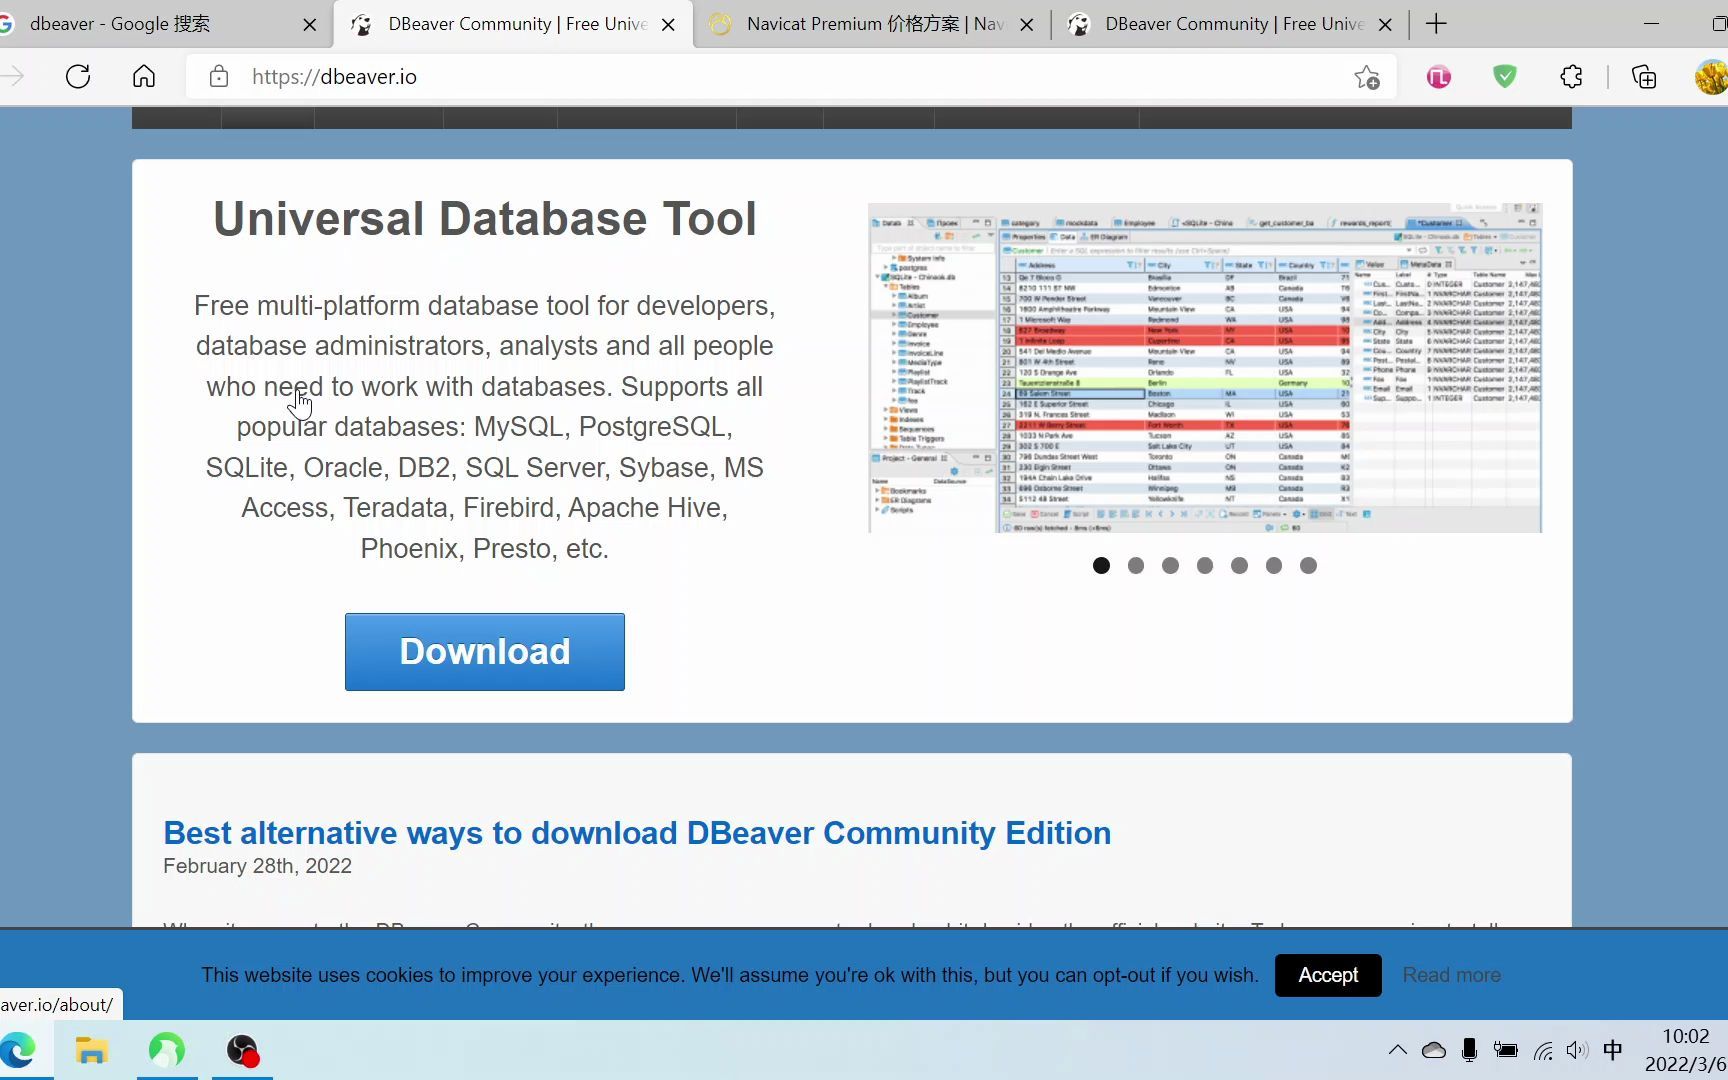
| 图形化客户端 | DBeaver、DataGrip | 支持大部分分析型数据库驱动,连接配置可视化 |
连接配置示例
以 ClickHouse 的 JDBC URL 为例,配置项直接影响连接行为:
jdbc:clickhouse://localhost:8123/default?connect_timeout=10000&socket_timeout=600000&use_server_time_zone=true
connect_timeout:建立连接的超时,单位毫秒。socket_timeout:查询超时,分析型查询建议设长一点,避免大结果集被截断。use_server_time_zone:保持时区一致,避免数据时间错乱。
对于 Apache Doris,JDBC URL 类似但参数不同,需查阅官方文档。不建议在 URL 中写死用户名和密码,应通过连接池配置安全存储。
分析型数据库连接不是简单的“能连上就行”。从驱动选择、连接池参数到超时设置,每一个环节都直接影响查询效率和系统稳定性。 遇到连不上时,先检查网络和权限;做性能调优时,优先调整连接池大小和超时时间;选工具时,根据场景匹配最轻量的方式,把这些细节做好,分析型数据库才能真正跑起来。
分析型数据库连接常见问题解答
Q: 连接池应该设置多大?
A: 没有固定公式,但多数情况下 10–50 个连接足够,如果查询平均耗时 3 秒,50 个连接能支撑每秒约 16 个并发查询,随着查询变慢或并发升高,需要逐步增加连接数,同时观察数据库 CPU 和内存使用率,避免超过硬件上限。
Q: 分析型数据库连接为什么比关系型数据库慢?
A: 分析型数据库通常需要更复杂的握手协议认证,且部分驱动会加载元数据,连接池预热不足或网络延迟也会导致首次连接慢,建议使用持久连接池,并提前执行一次查询完成预热。
Q: 通过 HTTP 连接和使用 JDBC 连接的主要区别是什么?
A: HTTP 连接无状态,适合短查询和跨语言场景,但每次请求都需要解析 HTTP 头部,批量查询效率较低,JDBC 连接能保持会话状态,支持事务和游标,适合复杂查询和大数据量导出,选择依据是业务是否需要跨语言或长连接。
首发原创文章,作者:王坚,如若转载,请注明出处:https://test.idctop.com/article/538993.html